概览
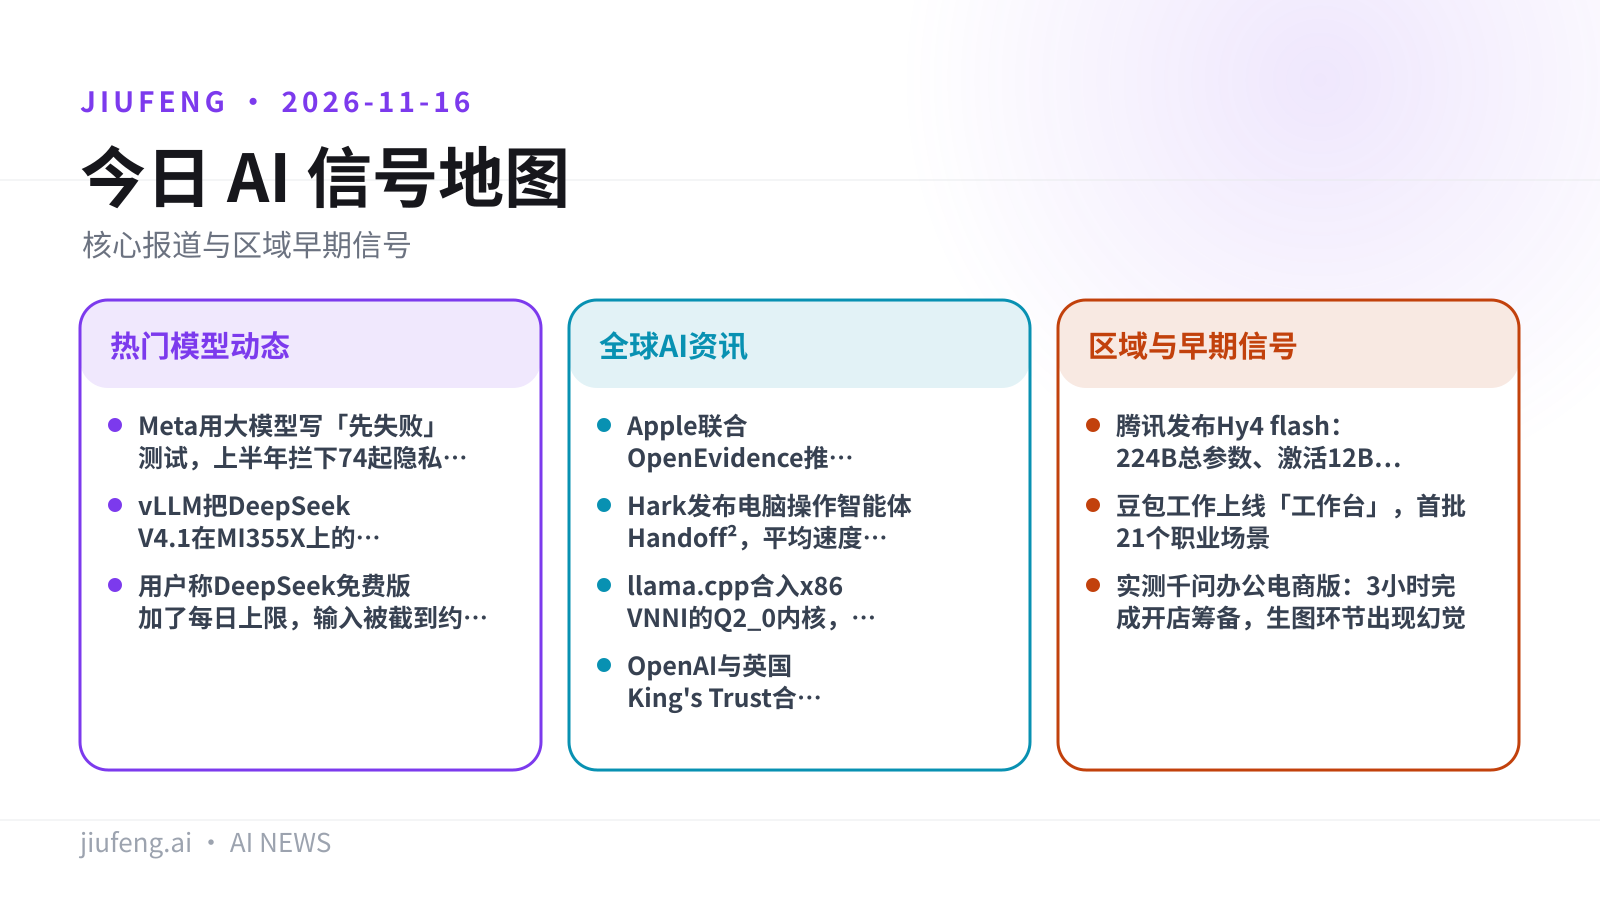
本期共 11 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · Meta 用大模型写「先失败」测试,上半年拦下 74 起隐私事故
- 重点 · vLLM 把 DeepSeek V4.1 在 MI355X 上的一次 Engram 查表从 54 ms 降到 5.1 ms
- 重点 · 用户称 DeepSeek 免费版加了每日上限,输入被截到约 4 万字
全球 AI 资讯
- Apple 联合 OpenEvidence 推出研究 App,研究人们怎么用 AI 问健康问题
- Hark 发布电脑操作智能体 Handoff²,平均速度是上一版的 2 倍
- llama.cpp 合入 x86 VNNI 的 Q2_0 内核,CPU 测试最高快 3.64 倍
- OpenAI 与英国 King's Trust 合作 100 万英镑,培训年轻人 AI 技能
- 论文 Gamer:面向长时程实时游戏的通用视觉-语言-动作模型
区域与早期信号
- 腾讯发布 Hy4 flash:224B 总参数、激活 12B,限时免费到 11 月 30 日
- 豆包工作上线「工作台」,首批 21 个职业场景
- 实测千问办公电商版:3 小时完成开店筹备,生图环节出现幻觉
九凤根据本期已引用来源整理。
热门模型动态
01/11
Meta 用大模型写「先失败」测试,上半年拦下 74 起隐私事故
Meta 已把 JiTTests 用进生产:大模型针对有风险的代码改动写测试,测试失败就说明这次 diff 改变了程序行为。
Meta 已把 Catching Just-in-Time Tests(JiTTests)从研究原型转入生产基础设施。系统用大模型生成可执行测试,这些测试专门设计成在有风险的代码改动上失败。测试失败本身就是具体证据,说明这次 diff 改变了程序行为。方法写在 FSE 2026 论文《Just-in-Time Catching Test Generation at Meta》里。
- 成效:2026 年上半年,在 diff 阶段、代码合入前拦下 74 起隐私类 SEV(严重事故)
- 规模:运行在数亿行的 Meta 后端代码上,论文分析了 22,126 个生成的测试
- 评判模型:论文中用 Llama3.3-70B、Gemini 3 Pro、Claude Sonnet 4 作为判定模型
- 运行方式:在 Meta 内部基础设施上运行,夜间利用空闲算力执行
局限:全量运行时 60% 的真阳性率由工程师自行报告,不是独立评估。JiTTests 是 Meta 内部系统,不对外提供。
来源:有原始出处 论文 arXiv · Meta Engineering on X · MarkTechPost
一项已合并的 vLLM 改动重排了 GPU 读取主机内存表的顺序,最大一档测试提速 10.6 倍。
贡献者 Fangzhou Ai 发现,DeepSeek V4.1 在 MI355X 上的预填充卡顿,原因是多块 GPU 从主机内存表中读取行的顺序。这项已合并到 vLLM 的改动,先对请求排序,再发往主机内存。
- 测试规模:8 块 MI355X,对 94 GiB 共享表做 589,824 行查找
- 结果:耗时从 54 ms 降到 5.1 ms,约 10.6 倍
- 启用条件:在 ROCm 上,查表行数从 32,768 行起走排序路径
局限:10.6 倍是这一查表步骤在 8 块 MI355X 上的测试结果,由贡献者给出。
来源:单一报道 RuntimeWire
多位用户报告 DeepSeek 应用和网页端出现用量收紧,DeepSeek 官方未确认。
据用户报告,DeepSeek 免费应用和网页聊天现在有每日使用上限。单次输入被压缩到约 40,000 字符,较早的长对话会被丢弃。
局限:这些都来自用户反馈,DeepSeek 尚未确认。
来源:单一报道 Pandaily
全球 AI 资讯
04/11
Apple 联合 OpenEvidence 推出研究 App,研究人们怎么用 AI 问健康问题
Apple 与医疗 AI 公司 OpenEvidence 合作推出研究用 App,计划在 12 个多月里招募最多 20 万名美国参与者。
Apple 宣布一项新研究,与专注医疗的 AI 公司 OpenEvidence 合作推出研究用 App。这个 App 会回答日常医疗问题,研究目的是了解有临床依据的回答能怎样帮到用户。Apple 正在邀请符合条件的美国用户参加。
- 参与条件:在美国、年满 21 岁、使用 iPhone 15 及以上、运行 iOS 26 及以上并开启 Apple Intelligence
- 规模:最多 200,000 人,持续 12 个月以上
局限:这是一项研究,不是 Apple 推出的健康聊天产品。目前只面向美国用户。
来源:单一报道 TechCrunch
05/11
Hark 发布电脑操作智能体 Handoff²,平均速度是上一版的 2 倍
Hark Pro 里的 Handoff² 用惩罚延迟的强化学习训练,学会把操作合并批量执行。
Handoff² 是 Hark Pro 中电脑操作智能体的第二版。Hark 称,提速来自强化学习:训练时惩罚多余的回合和延迟。
| 指标 | Handoff² | v1 |
|---|---|---|
| 内部对齐基准(%) | 93.8 | 90.3 |
- 任务完成:Hark 内部 478 个网页任务完成 82%
- 速度:端到端平均约为 v1 的 2 倍,订机票最多快 3.8 倍
- 运行环境:运行在 Hark 云端,每个请求一台专用虚拟电脑,支持网页、iOS、Android
局限:成绩都来自 Hark 自己的内部基准。在同一测试框架下,82% 的浏览任务完成率仍比 Claude Opus 5.5(max)低最多 5 个百分点。不提供本地或量化部署。
来源:单一报道 MarkTechPost
06/11
llama.cpp 合入 x86 VNNI 的 Q2_0 内核,CPU 测试最高快 3.64 倍
新内核面向支持 AVX-VNNI 或 AVX-512 VNNI 的 x86 CPU,Bonsai 1.7B 到 27B 模型提速 3.0 到 3.64 倍。
llama.cpp 在 11 月 15 日合并了贡献者 Saejin Kim-Heinert(@Michionlion)提交的 group-64 内核。它为已有的 ggml_vec_dot_q2_0_q8_0 运算加了优化实现,面向 AVX-VNNI,或者 AVX-512 VNNI 加 AVX-512 VL 的构建。在 PR 的纯 CPU 测试里,Bonsai 1.7B 到 27B 模型的速度提到原来的 3.0 到 3.64 倍。
局限:提速只适用于 Q2_0 量化和上述指令集。测试中困惑度有小幅漂移,作者认为是编译器行为导致的。
来源:单一报道 RuntimeWire
这项合作计划帮助英国最多 25,000 名年轻人掌握工作中用得上的 AI 技能。
King's Trust 和 OpenAI 宣布一项 100 万英镑的合作,面向全英国的年轻人。目标是帮助最多 25,000 人学会在工作中实际使用 AI。
局限:这是技能培训合作,不涉及模型或产品功能变化。具体课程形式和时间安排要看原公告。
来源:有原始出处 OpenAI
08/11
论文 Gamer:面向长时程实时游戏的通用视觉-语言-动作模型
Gamer 用同一套训练和部署管线,同时处理 2D 图形界面和复杂 3D 模拟世界。
arXiv 论文 2611.18397 于 11 月 13 日提交,作者为 Run Luo 等 27 人。Gamer 是一个通用智能体框架,针对复杂交互环境里的长时程任务。它的端到端架构把感知、记忆管理和多步推理放在一起。在常规 2D 图形界面和 3D 模拟世界里交互,用的是同一套训练与部署管线。
局限:摘要里没有基准分数、参数量或权重许可证。能力需要看论文正文和公开的模型核实。
来源:有原始出处 arXiv
九凤根据本期已引用来源整理。
区域与早期信号
Hy4 flash 是 Hy4 的高效版,按媒体实测与腾讯数据,单任务成本是 Hy4 的 1/20。
据爱范儿(APPSO)报道,腾讯 11 月 16 日正式发布 Hy4 flash,主打把 Hy4 的智能体与长程任务能力以更低成本带到高频场景。
- 参数:总参数 224B,激活参数 12B
- 能力:支持多模态,1M 上下文
- 价格:输入每百万 Token 0.5 元,输出每百万 Token 2 元,约为 Hy4 的十分之一
- WorkIndex 单任务成本:是 Hy4 preview 的 1/13,Hy4 的 1/20,DeepSeek-V4.1-Flash-1017(max 档、忙时价格)的 1/8
- 可用性:可在 WorkBuddy 里选用,11 月 16 日至 30 日每日赠送免费额度
局限:成本对比来自腾讯数据和媒体抢先测试,没有独立复测。报道没有提到是否开放权重。仅有中文来源。
来源:单一报道 爱范儿
10/11
豆包工作上线「工作台」,首批 21 个职业场景
金融、医疗、教育等场景预配好技能和插件,金融工作台可接万得、同花顺数据。
豆包工作上线「工作台」,首批覆盖 21 个专业场景。金融投研工作台连接万得、同花顺、国泰海通等数据插件,用户授权终端账号后才能调用。教师工作台与学科网有官方合作,可以通过连接器找教学资源、找相似题。用户也可以选好技能和插件,自建并分享工作台。功能已在豆包工作电脑版和豆包电脑版上线。
局限:「业内首个」是官方说法。目前只有电脑端。仅有中文来源。
来源:单一报道 雷锋网
一位没有电商经验的编辑用千问办公电商版走完 7 个开店筹备环节,模型输出约 30 分钟,Token 费用约 47 元。
壹览商业的实测把开店筹备拆成 7 个环节:市场调研、定价测算、店名、素材、备货、上架清单、客服话术。全程约 3 小时,其中包括人工核对和修改 AI 产出的时间。
| 环节 | 千问办公 | 新手传统做法 |
|---|---|---|
| 市场调研 | 8 分 48 秒 | 1–2 天 |
| 商品素材 | 15 分钟出 19 张图,约 33.75 元 | 外包 3–5 天,千元级 |
| 装修/备货/上架/话术 | 各 2 分钟以内 | 各半天到一天 |
局限:原文指出,市场调研产出比较基础,生图环节是问题最集中的地方,出现了「生图幻觉」,核心环节仍需人工把关。这是单一媒体的单次测试。仅有中文来源。
来源:单一报道 钛媒体
本文由 AI 根据文中所附信源整理,经自动事实核查后发布,发布前未经人工逐篇审核;如与原文不一致,以原始出处为准。了解本日报的制作方式或报告错误:关于本日报