概览
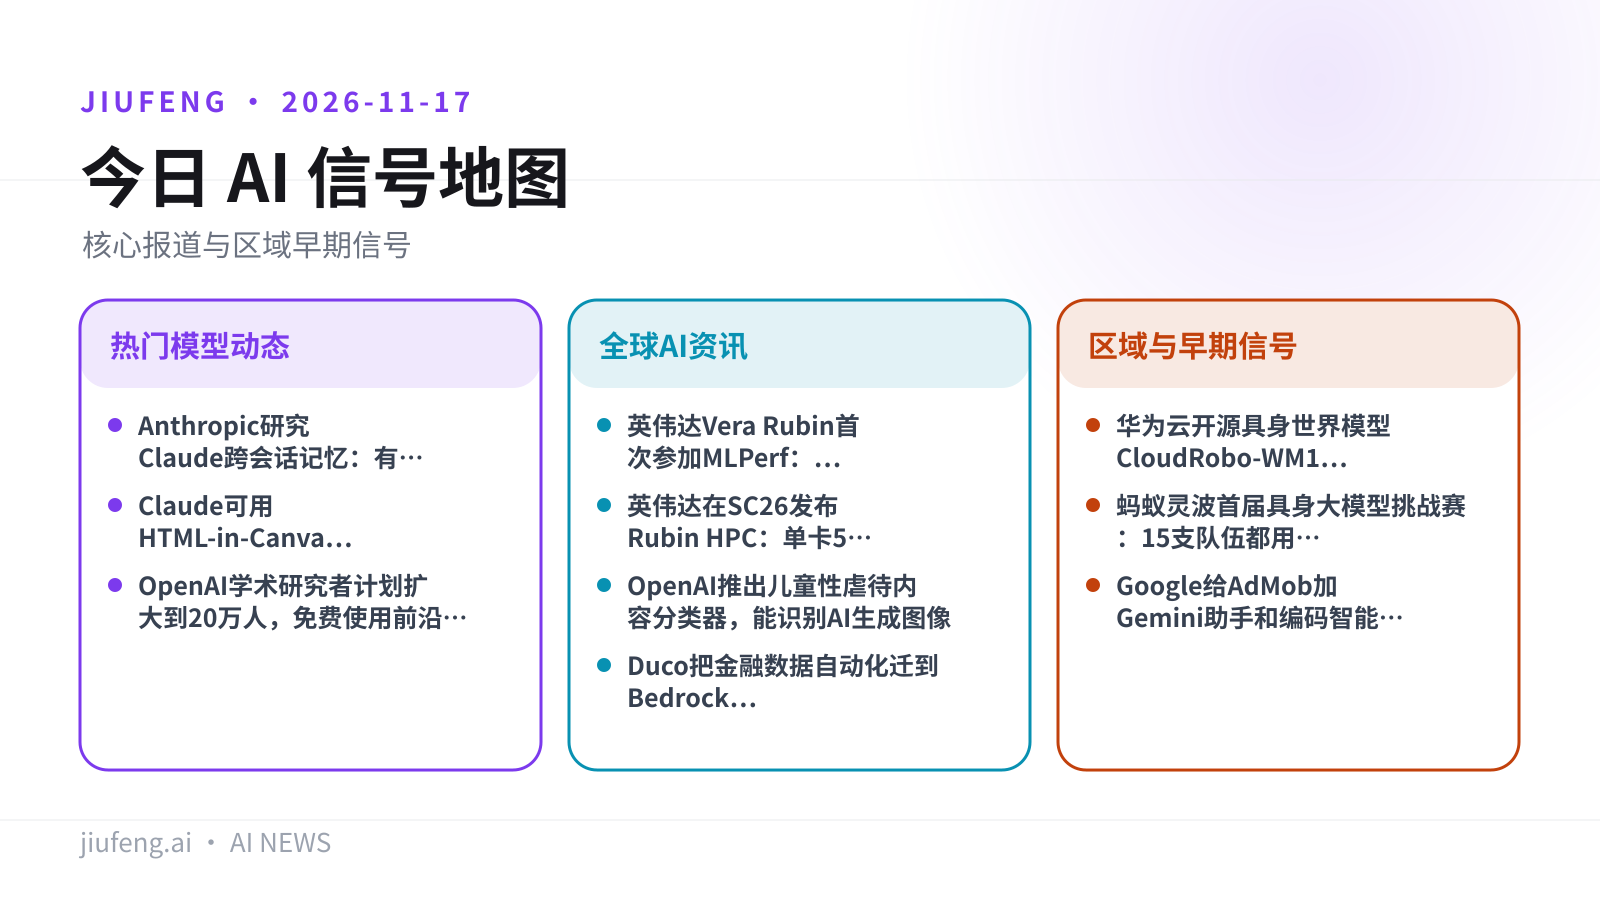
本期共 11 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · Anthropic 研究 Claude 跨会话记忆:有选择地记,比全部存档效果好
- 重点 · Claude 可用 HTML-in-Canvas 生成可交互网页,示例页给了 15 个案例
- 重点 · OpenAI 学术研究者计划扩大到 20 万人,免费使用前沿模型
全球 AI 资讯
- 英伟达 Vera Rubin 首次参加 MLPerf:Training v6.1 全部项目第一
- 英伟达在 SC26 发布 Rubin HPC:单卡 5 万多个 CUDA 核心,预计 2028 年上市
- OpenAI 推出儿童性虐待内容分类器,能识别 AI 生成图像
- Duco 把金融数据自动化迁到 Bedrock AgentCore,每月处理 200 亿笔交易
- Noeri 获 1.1 亿美元融资,做能从企业数据里持续自我改进的 AI 系统
区域与早期信号
- 华为云开源具身世界模型 CloudRobo-WM1.2,称在两项评测排第一
- 蚂蚁灵波首届具身大模型挑战赛:15 支队伍都用 LingBot-VLA 2.0 底座
- Google 给 AdMob 加 Gemini 助手和编码智能体技能,MCP 服务器在早期测试
九凤根据本期已引用来源整理。
热门模型动态
模型本身不变,Claude 靠写笔记跨会话保留知识。只记策略和规则、不逐步记日志时效果更好。
Anthropic 发布研究文章,测试 Claude 怎样把信息写进一个笔记文件夹,在后续会话里读回来用。测试结果是:有选择地记录策略和规则,比把每一步都记下来效果好得多。完整存档会让模型被过时信息淹没。
研究还介绍了会话结束后运行的「Dreaming」流程:系统在空闲时分析之前的会话记录,自行纠正写错的笔记,整理出结构化的知识集。在《宝可梦 红》测试里,较新的 Claude Fable 5 推进的距离是对照模型的 4 倍。
局限:这是一篇研究文章,不是产品发布。报道没有说明 Dreaming 是否已经作为功能开放给用户。原文提到,宝可梦测试里每个模型只玩了一次。
来源:有原始出处 Anthropic Research · The Decoder
Claude 现在能把真实的文本、按钮等网页元素放进 canvas 图形和 3D 效果里,元素仍可点击、可选中。
普通 HTML 元素可点击、能被读屏软件识别,但很难做视觉变形;canvas 什么都能画,浏览器却只把它当成一张图。HTML-in-Canvas 把真实的页面元素放进 canvas 图形,同时保留交互。在 Anthropic 参与 Claude 工作的 Felix Rieseberg 在 X 上说,Claude 已经能用这个特性做「怪异又漂亮」的网站,让他想起 Flash 时代。
示例页有 15 个案例,包括渲染成编织图样、3D 立方体和分层爆炸视图的网站,里面的内容仍是可以高亮和复制的真实文本。HTML-in-Canvas 由 Google 作为 Web 标准推进,目前在 Chrome 和 Edge 里可用。
局限:这条消息来自员工在 X 上的帖子,不是正式的产品更新说明。这项能力依赖一个仍在标准化过程中的浏览器特性,报道只提到 Chrome 和 Edge 支持。
来源:有原始出处 Felix Rieseberg on X · The Decoder
OpenAI 扩大 ChatGPT for Academic Researchers 计划,向全球 20 万名研究者免费开放前沿模型;另外发布了一份 1800 多名科学家使用 ChatGPT 的调查。
按 OpenAI 公告,扩大后的计划面向全球 20 万名研究者,免费提供其前沿模型。OpenAI 另外发布了《Science at the Frontier》报告,调查了 1800 多名科学家在研究中怎样使用 ChatGPT,内容包括日常工作流程、自报的效率变化,以及他们对科学发现的预期。
局限:公告摘要没有写明申请资格、覆盖哪些模型、免费期多长。调查里的效率数据是科学家自己报告的,不是对照实验测出来的。
来源:有原始出处 OpenAI:Broadening access to AI for scientists · OpenAI:Science at the Frontier
全球 AI 资讯
04/11
英伟达 Vera Rubin 首次参加 MLPerf:Training v6.1 全部项目第一
Vera Rubin 平台首次提交 MLPerf,英伟达称拿下 Training v6.1 全部基准,在首次参加的 Endpoints 测试里每瓦吞吐提升超过 10 倍。
英伟达称,Vera Rubin 平台在 MLPerf Training v6.1 的每一项基准里都排第一。这是英伟达第一次提交 MLPerf Endpoints,在智能体推理上,每瓦吞吐(每瓦电能完成多少智能体工作)比上一代提升超过 10 倍。MLPerf Training 测的是系统把一组模型训练到目标精度需要多长时间。
局限:以上数据来自英伟达自己的博客,没有列出其他提交方的成绩。英伟达说 Vera Rubin 的性能会随 CUDA 软件栈优化继续提高,这属于厂商承诺。
图片来源:NVIDIA Blog。
来源:有原始出处 NVIDIA Blog
05/11
英伟达在 SC26 发布 Rubin HPC:单卡 5 万多个 CUDA 核心,预计 2028 年上市
Rubin HPC 是 Vera Rubin 平台里的新 GPU,面向科学、工程和分析领域的仿真与数据处理。
- CUDA 核心:单 GPU 超过 50,000 个,英伟达称是历来最多
- 稀疏数据加速:给核心持续供数
- 互连:第七代 NVLink,加快 GPU 之间的连接
- 定位:对智能体提出的材料、分子和设计跑仿真验证
- 上市:英伟达称预计 2028 年推出
局限:公告没有给出价格和具体性能数字,以上规格均来自英伟达自己的博客。
来源:有原始出处 NVIDIA Blog:Rubin HPC
OpenAI 在华盛顿发布会上推出检测儿童性虐待图像的分类器,向经过审核的机构免费开放。
据 The Verge 报道,OpenAI 周一在华盛顿特区的发布会上推出这款分类器。它能更好地识别涉及儿童的虐待图像,包括判断图像是不是 AI 生成的。OpenAI 称,这是首个广泛可用、带 AI 生成标记的此类分类器,需要人工复核的误报更少,识别虐待内容的效果也更好。
同时推出的还有几项措施:向经过审核的机构免费开放分类器,给开发者提供检测这类内容的指导,协助培训执法人员在调查中使用 AI。
局限:准确率提升和「首个」的说法都来自 OpenAI,报道没有引用独立评测。
07/11
Duco 把金融数据自动化迁到 Bedrock AgentCore,每月处理 200 亿笔交易
服务一线银行的数据自动化平台 Duco,把智能体技术栈重建在 Amazon Bedrock 和 AgentCore 上,每家银行的数据单独隔离。
- 规模:每月处理 200 亿笔交易,客户超过 200 家
- 客户:全球前 20 大银行里有 7 家,前 20 大资产管理公司里有 10 家
- 架构:按租户严格隔离,同时使用多个模型,并接入 MCP
- 演进:从传统机器学习的预测打标签,升级到 Bedrock 的智能体能力
局限:这是 AWS 官方博客上的客户案例,效果数据来自 Duco 和 AWS 自己的介绍,没有第三方核验。
来源:有原始出处 AWS Machine Learning Blog
08/11
Noeri 获 1.1 亿美元融资,做能从企业数据里持续自我改进的 AI 系统
由 Yejin Choi 和 Carlos Guestrin 创办的 Noeri 带着 1.1 亿美元融资亮相,做「活的」企业 AI 系统。
本轮由 Menlo Ventures 领投,Madrona Ventures、Kindred Ventures、Wing Venture Capital、NEA 跟投,Snowflake 和 Cisco Ventures 也参与了。两位创始人来自斯坦福大学,此前在华盛顿大学做了多年自我改进系统的研究。Noeri 的软件会学习企业的数据、工作流和业务流程,再针对具体任务提出修改建议,例如换一套指令。
局限:报道没有披露估值、客户数量和产品上线时间。「自我改进」的效果目前没有公开数据支持。
来源:单一报道 SiliconANGLE
区域与早期信号
华为云发布并开源 CloudRobo-WM1.2,这是一个基于昇腾的原生具身世界模型。华为云称它在 RoboTwin 2.0 和 Libero Pro 2.0 上都排第一。
CloudRobo-WM1.2 用共享的世界模型骨干网络做预测增强的世界表征,再通过 DualAct 架构由世界模型直接生成动作。模型本身开源;训练框架的工程代码和 WAM 昇腾算力代码库只定向开放给核心合作伙伴。华为云还称,80% 的中国具身智能企业在用昇腾云。
局限:只有钛媒体一家报道,属于中文来源。报道没有给出两项评测的具体分数,排名和市场份额都是华为云自己的说法。
来源:单一报道 钛媒体
10/11
蚂蚁灵波首届具身大模型挑战赛:15 支队伍都用 LingBot-VLA 2.0 底座
参赛队伍统一用开源预训练模型 LingBot-VLA 2.0、同一款机器人硬件和算力做 48 小时真机比赛,TARS 战队以 82.5 分夺冠。
决赛 11 月 14 日在上海张江举行,15 支队伍参加。赛题有三项:单臂抓取果蔬,单臂把化妆品放进透明盒子,双臂配合清扫桌面垃圾再倒进收纳筐。共进行三轮真机测评,每队取最高一轮的总分。冠军 TARS 战队的做法是把杂乱的多物体场景简化成一次只抓一个物体,避开 VLA 模型在杂乱环境里的感知短板。
局限:只有雷锋网一家报道,属于中文来源。报道没有公布 LingBot-VLA 2.0 本身的参数量和基准成绩。
来源:单一报道 雷锋网
Google 为移动广告平台 AdMob 推出基于 Gemini 的对话助手 Ask AdMob,以及给 AI 编码助手用的 AdMob 智能体技能。
Ask AdMob 直接嵌在开发者的 AdMob 账户里,可以检查广告设置、排查集成错误、给出收入优化建议,也能用自然语言设置品牌安全规则。智能体技能是预先写好并测试过的操作指南,让编码助手协助接入广告、迁移到新版 SDK,以及检查实现是否正确。
局限:目前只有智能体技能可以用;Ask AdMob 计划在未来几个月开始测试,MCP 服务器还在早期测试,预计 2027 年初扩大测试范围。本条只有 IT之家报道,属于中文来源。
来源:单一报道 IT之家
本文由 AI 根据文中所附信源整理,经自动事实核查后发布,发布前未经人工逐篇审核;如与原文不一致,以原始出处为准。了解本日报的制作方式或报告错误:关于本日报