概览
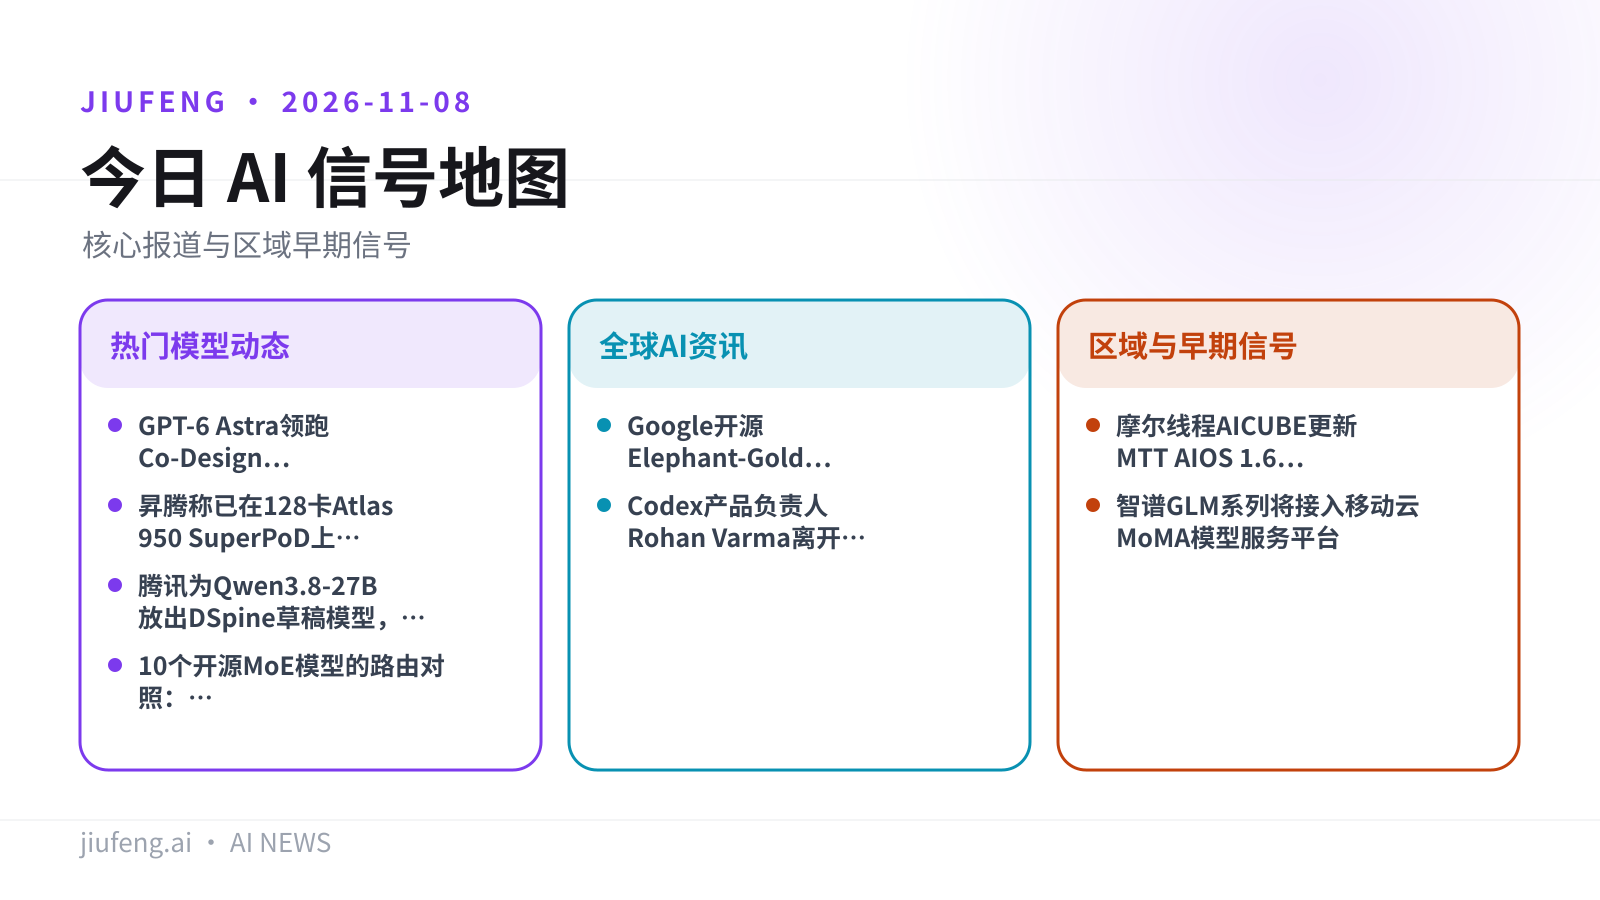
本期共 8 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · GPT-6 Astra 领跑 Co-Design Bench,但只有 26.4% 的任务完全做对
- 重点 · 昇腾称已在 128 卡 Atlas 950 SuperPoD 上验证 Kimi K3.1 Pro 的 LoRA 微调
- 重点 · 腾讯为 Qwen3.8-27B 放出 DSpine 草稿模型,智能体测试中提速 2.71–3.84 倍
- 10 个开源 MoE 模型的路由对照:DeepSeek-V4-Pro 用 384 个专家,Llama 4 Maverick 每次只选 1 个
全球 AI 资讯
- Google 开源 Elephant-Goldfish Model 插件:编码智能体先写规格,再过 5 轮评审
- Codex 产品负责人 Rohan Varma 离开 OpenAI
区域与早期信号
- 摩尔线程 AICUBE 更新 MTT AIOS 1.6.1:新增智能家居控制与本地 AI NAS 管理
- 智谱 GLM 系列将接入移动云 MoMA 模型服务平台
九凤根据本期已引用来源整理。
热门模型动态
这个基准用的是真实用户的修改需求。在 10 个参测模型里,GPT-6 Astra 排名第一,但大约四分之三的任务仍要人来收尾。
阿里巴巴和几所亚洲高校的研究者发布了编码智能体基准 Co-Design Bench。任务取自真实用户的修改请求,而且这些请求在实际使用中曾经难住过智能体。智能体要按请求改造已有的 Web 应用,有的请求还附带图片、录音、视频或文档。
- 第一名:GPT-6 Astra,平均满足单个任务约 70% 的要求,完全做对的任务占 26.4%
- 第二、三名:Claude Opus 5、Qwen3.8-Max
- 垫底:Grok 4.6
- harness 的影响:同一个 Qwen3.8-27B 换用不同 harness,得分分别为 75% 和 56%
- token 消耗:在较小的改动任务上,GLM-5.2 用掉的 token 接近 GPT-6 Astra 的 6 倍,得分仍明显更低
论文作者说,之所以另做这个测试,是因为现有编码基准已经饱和,旧测试上接近满分的成绩需要重新看待。
局限:大多数任务里,智能体完成了主要工作,但至少留下一个细节没做完,用的人几乎总要手动修补。
来源:有原始出处 论文 arXiv · The Decoder
昇腾称,已在一套 128 卡的华为昇腾超节点上完成 2.8 万亿参数 Kimi K3.1 Pro 的 LoRA 微调验证,并称 Swap Core 缓存平均带来 15% 的提升。
据 Pandaily 报道,华为昇腾表示,已在一套 128 卡的 Atlas 950 SuperPoD 上完成 Kimi K3.1 Pro 的 LoRA 微调验证。这个模型的参数量是 2.8 万亿。昇腾引用的数据是:Swap Core 缓存平均带来 15% 的提升。
局限:以上是昇腾方面的说法,15% 的提升也是昇腾自己引用的数据。本条只依据 Pandaily 一家的报道。
来源:单一报道 Pandaily
不用换目标模型:腾讯在 Hugging Face 上放出一个 5 层的投机解码草稿检查点,给 Qwen3.8-27B 推理提速。
- 形式:五层 DSpine 草稿检查点(tencent/Qwen3.8-27B-DSpine-b16),已上架 Hugging Face
- 提速:腾讯的智能体吞吐测试中,速度是自回归基线的 2.71 到 3.84 倍
- 代码:GitHub 仓库的更新记录写着「[2026-11] Added support for Qwen3.8-27B inference」
RuntimeWire 认为,智能体负载会产生很长、工具调用很多的输出。能下载使用的草稿模型提高了每次被接受的 token 长度,可以压低延迟和服务成本。
局限:提速数据来自腾讯自己的测试。仓库里的支持记录只精确到月份。路线图把「Qwen3.8-27B 草稿权重发布」单独列为一项,所以这条月份记录不能当成检查点首次上传的日期。
图片来源:huggingface。
来源:有原始出处 Hugging Face · GitHub · RuntimeWire
同样标「17B 激活」的模型,路由方式可能完全不同。MarkTechPost 按各模型的 config.json 核对了专家数、top-k 和负载均衡方法。
参测的 10 个模型从 Qwen3.6-35B-A3B(35B 总参、3B 激活)到 DeepSeek-V4-Pro(1.6T 总参、49B 激活),全部采用 token-choice 路由。路由专家数在 8 到 384 之间,top-k 在 1 到 8 之间。
| 模型 | 总参/激活 | 路由专家数 | top-k | 共享专家 | 负载均衡 |
|---|---|---|---|---|---|
| Mixtral 8x7B | 47B / 13B | 8 | 2 | 0 | 辅助损失,系数 0.02 |
| gpt-oss-120b | 117B / 5.1B | 128 | 4 | 0 | 未在 config 公开 |
| Qwen3.6-35B-A3B | 35B / 3B | 256 | 8 | 1 | 辅助损失,系数 0.001 |
| Llama 4 Maverick | 400B / 17B | 128 | 1 | 1 | 未公开 |
| DeepSeek-V4-Pro | 1.6T / 49B | 384 | 6 | 1 | noaux_tc |
DeepSeek-V4-Pro 的路由专家增加到 384 个,top-k 从 8 降到 6,打分函数换成 sqrtsoftplus,前 3 个 MoE 层用哈希路由,noaux_tc 负载均衡沿用。部署方面,gpt-oss-120b 用 MXFP4 可以放进一块 80GB GPU;DeepSeek-V4-Pro 和 Kimi K2 要多卡专家并行。Kimi K2 的实验显示,验证损失相同时,稀疏度 48 比稀疏度 8 少用 1.69 倍的 FLOPs。
局限:Llama 4 Maverick 和 gpt-oss 的 config.json 没有公开门控或负载均衡方法,这几项无法核对。这篇文章是对已公开配置的整理,不是新模型发布。
来源:有原始出处 NVIDIA Megatron Bridge 文档 · Mixtral config · Meta Llama 4 · MarkTechPost
全球 AI 资讯
05/08
Google 开源 Elephant-Goldfish Model 插件:编码智能体先写规格,再过 5 轮评审
写代码之前,先让没有对话历史的新子智能体去挑规格文档的毛病。Google 称内部已有数千名工程师在用。
- 组成:7 个技能、9 种评审角色、6 个头脑风暴视角、5 个评审阶段
- 模型:不含模型权重,由所用的智能体提供 LLM,消耗用户已有的模型额度
- 适用环境:任何能拉起全新子智能体的 harness,包括 Antigravity、Claude Code 2.1.271+、Claude Cowork、Codex、ChatGPT
- 测试:Codex 0.163.0 按顺序跑完 15 个全新上下文的评审者;2 项实测在 573.13 秒内通过
这个插件的思路是把错误的假设拦在 Markdown 规格文件里,不等到 pull request 才发现。
局限:官方没有公布准确率基准,现有证据只是采用情况和端到端的 harness 测试。在 Claude Cowork 上的测试跑到中途就停了。
来源:有原始出处 GitHub · MarkTechPost
他是 Cursor 的第一位产品经理,之后在 OpenAI 负责 Codex 产品,现已离职。
Rohan Varma 在 X 上宣布离开 OpenAI。他说,自己在 Codex 团队的这段时间不长,但经历了公司的三四次演变。他此前还创办过有风投支持的创业公司。
局限:他没有透露下一份工作,只说休息几天后会回去工作。OpenAI 是否已安排接任者,公开信息里没有提到。
来源:有原始出处 Rohan Varma 的 X 帖子 · RuntimeWire
区域与早期信号
07/08
摩尔线程 AICUBE 更新 MTT AIOS 1.6.1:新增智能家居控制与本地 AI NAS 管理
摩尔线程的 AICUBE 设备更新系统,可以控制 Matter/ZigBee 设备、管理 Olares 文件,并支持按语义搜照片。
MTT AIOS 1.6.1 新增四项功能:Matter/ZigBee 智能家居控制、Olares 文件管理、语义照片搜索,以及「桌面宠物」模式。
局限:本条只依据 Pandaily 一家的报道,功能清单以报道描述为准。
来源:单一报道 Pandaily
11 月 6 日,中国移动云与智谱签署合作协议,GLM 系列模型将上架移动云的 MaaS 平台。
双方将围绕国产算力适配和模型调优,共建「Token 联合发展中心」。智谱 GLM 系列模型将接入移动云的 MoMA 模型服务平台。双方还计划联合做 AI Coding 产品,并在金融、政务等行业提供「算力 + 模型 + 应用」一体化方案。移动云总经理孙少陵和智谱 CEO 张鹏出席了签约。
局限:报道没有说明接入哪几个 GLM 版本、上线时间和价格。目前这只是签约阶段的合作意向,暂时没有看到英文报道。
来源:单一报道 IT之家
本文由 AI 根据文中所附信源整理,经自动事实核查后发布,发布前未经人工逐篇审核;如与原文不一致,以原始出处为准。了解本日报的制作方式或报告错误:关于本日报