概览
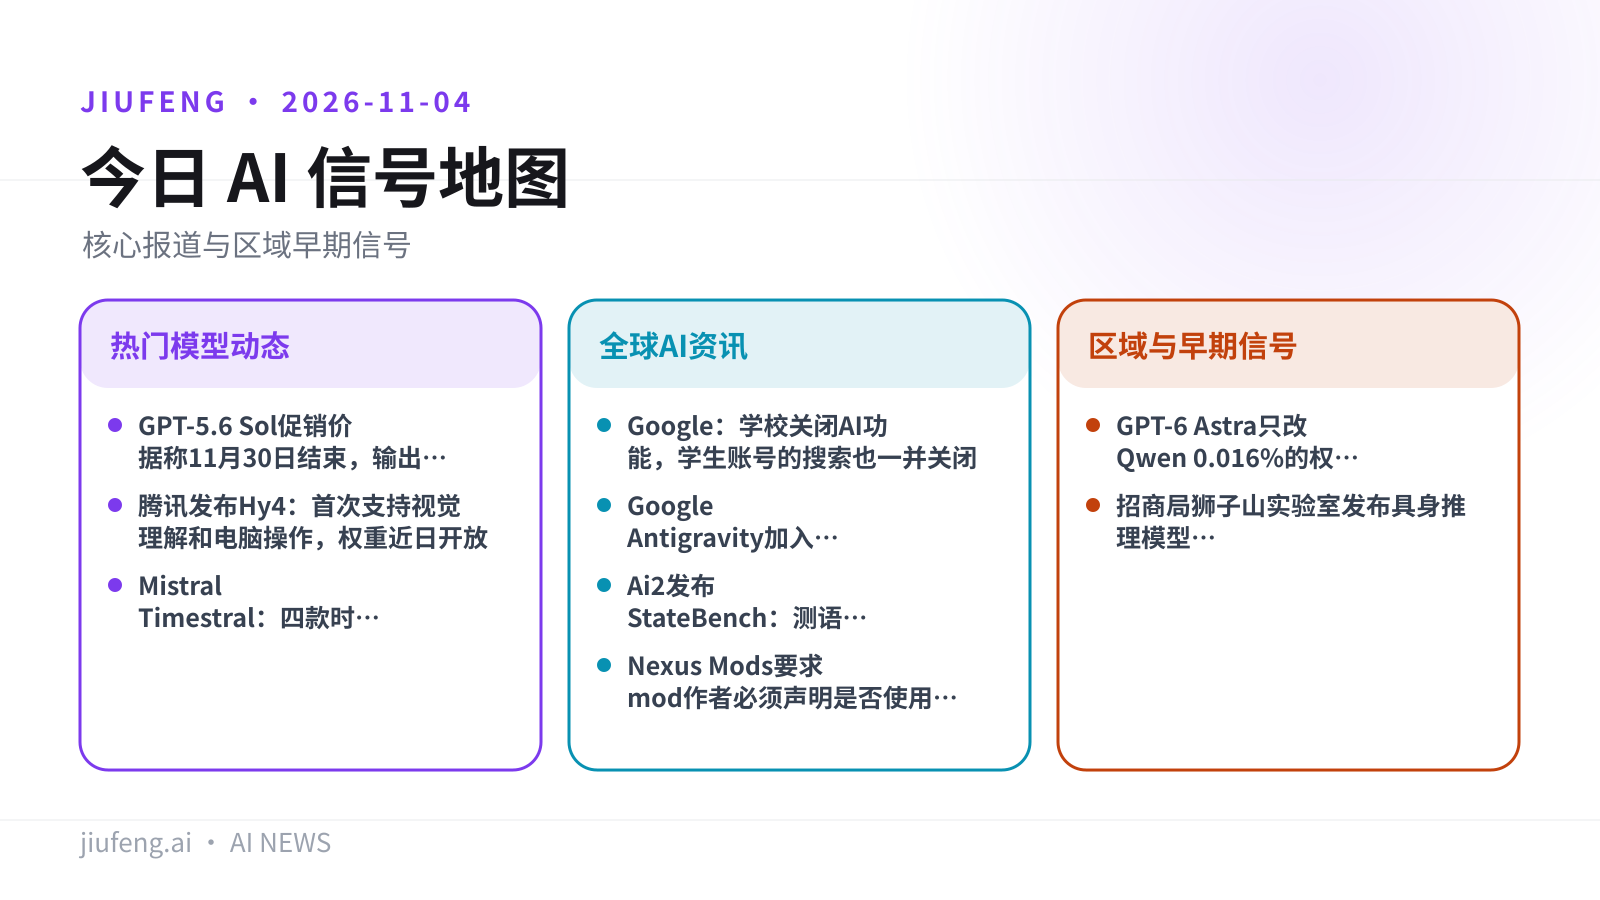
本期共 9 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · GPT-5.6 Sol 促销价据称 11 月 30 日结束,输出价涨 50%
- 重点 · 腾讯发布 Hy4:首次支持视觉理解和电脑操作,权重近日开放
- 重点 · Mistral Timestral:四款时序预测模型,最小 500 万参数,可只用 CPU
全球 AI 资讯
- Google:学校关闭 AI 功能,学生账号的搜索也一并关闭
- Google Antigravity 加入化学信息学技能,一小时提出新的大环分子
- Ai2 发布 StateBench:测语言模型在长文档里追踪状态变化的能力
- Nexus Mods 要求 mod 作者必须声明是否使用 AI,已有 mod 有 60 天宽限
区域与早期信号
- GPT-6 Astra 只改 Qwen 0.016% 的权重,MATH-500 从 7.9% 升到 48.1%
- 招商局狮子山实验室发布具身推理模型 Lion-ER-35B-A3B
九凤根据本期已引用来源整理。
热门模型动态
一封 OpenAI 客户邮件称 GPT-5.6 Sol 的 API 促销价 11 月 30 日结束;官方文档目前只承诺促销价至少维持到 11 月 21 日。
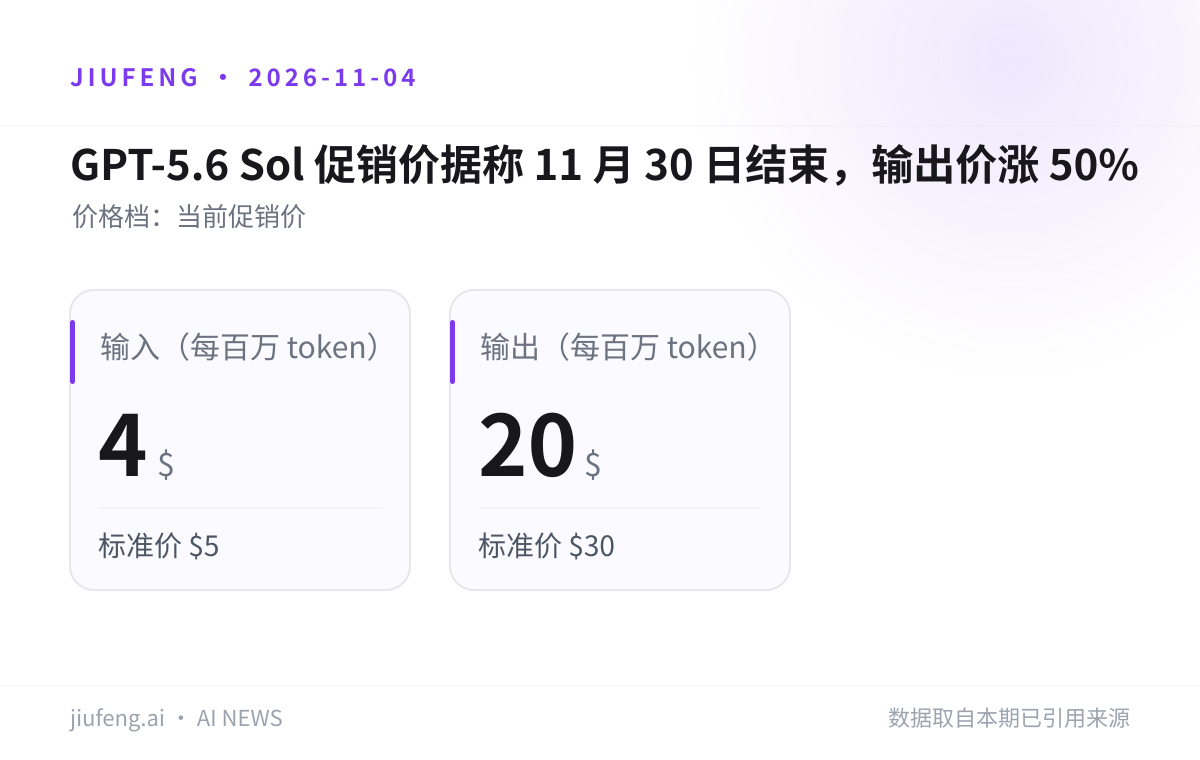
据 RuntimeWire 报道,OpenAI 发给客户的邮件称,GPT-5.6 Sol 的 API 促销定价将于 2026 年 11 月 30 日结束,之后恢复标准价。按报道给出的价格,恢复后输出价上涨 50%,输入价上涨 25%。
| 价格档 | 输入(每百万 token) | 缓存输入(每百万 token) | 输出(每百万 token) |
|---|---|---|---|
| 当前促销价 | $4 | — | $20 |
| 标准价 | $5 | $0.50 | $30 |
局限:11 月 30 日这个截止日期和届时恢复上述价格,目前只有这封客户邮件一个来源。OpenAI 公开的模型文档只保证促销价至少持续到 11 月 21 日,没有写明具体结束日期。
九凤根据本期已引用来源整理。
来源:有原始出处 OpenAI API 文档:GPT-5.6 Sol · RuntimeWire
腾讯发布新一代大模型 Hy4,首次加入视觉理解和电脑操作能力,称将在近几天发布模型权重和系统卡。
腾讯在官方新闻稿中公布了 Hy4 的几项变化:
- 视觉理解:首次支持,可处理细粒度图像、复杂图表分析和数学视觉推理。
- 电脑操作:首次支持,可同时操作命令行界面和图形界面,完成工作和日常任务。
- 其他改进:指令遵循、长上下文理解和长程智能体任务。
- 开源计划:近几天发布模型权重和系统卡,安全方面重点关注网络安全和生物安全。
新闻稿同时给出了几组评测结果:WorkBuddy 场景平均分 83.18、通过率 96.15%,12 个场景中 9 个排第一;在一项金融盲评中,Hy4 得 3.04 分,DeepSeek-V4.1-Flash 为 2.97 分。
局限:「跻身全球领先开源模型之列」是腾讯的自我表述,以上评测都由腾讯自己公布。权重还没有发布,开源条款要等正式放出后才能确认。
来源:有原始出处 Tencent Newsroom
Mistral 推出首个时间序列基础模型系列 Timestral,共四款,参数量 500 万到 2.09 亿,称可在标准服务器 CPU 上运行。
据 RuntimeWire 报道,Mistral 于 2026 年 10 月 15 日发布 Timestral。它面向工厂传感器、能耗、资金流等运营数据,可以同时预测多条相关的数据流,并把计划中的输入纳入预测。
- 规模:4 款模型,参数量 500 万到 2.09 亿。
- 硬件:Mistral 称可在标准服务器 CPU 上推理,不需要 GPU。
- 部署:支持由客户自己控制部署。
- 评测:Mistral 称已把结果提交到 GIFT-Eval 和 TIME 两个时序榜。
局限:这个系列在 10 月中旬就已发布,不是当天的新消息。RuntimeWire 指出,在评测结果和评测设置能够直接对比之前,「榜单领先」仍只是公司的说法。
来源:有原始出处 Mistral Newsroom · RuntimeWire
全球 AI 资讯
04/09
Google:学校关闭 AI 功能,学生账号的搜索也一并关闭
Google 的 K-12 学生账号将默认关闭 Gemini 和搜索,管理员不能只关 Gemini 而保留搜索。
Google 在一份教育产品更新中写明:除非管理员明确开启,K-12 学生账号的 Gemini、Gemini Notebook、Gemini in Classroom 和 Google Search 将「完全关闭」。管理员想关掉 Gemini 相关功能,就必须同时关掉搜索,学生会看到搜索不可用的提示。Google 教育副总裁 Chris Phillips 对《纽约时报》说:「搜索和 AI 已经深度融合。」
局限:据 The Verge 报道,多名议员和地方官员已对此作出回应,其中包括参议员 Bernie Sanders。报道没有给出受影响的学校或学生数量。
来源:有原始出处 Google 教育更新 · The Verge
05/09
Google Antigravity 加入化学信息学技能,一小时提出新的大环分子
Google DeepMind 为 Antigravity 推出 Cheminformatics Skills,智能体用一小时完成通常需要几天的药物设计迭代。
DeepMind 以真实的肺癌治疗药物为案例:智能体在数千个化合物中检索,做匹配分子对分析,最后提出新的刚性化大环分子,并给出合成路线,全程约一小时。DeepMind 说,同样的流程人工做一轮通常要好几天,包括从图表和文献里整理数据、训练预测模型、提出候选分子。
局限:文章展示的是智能体「提出」的候选分子和合成路线,没有报告这些分子是否已经合成或通过实验验证。
来源:有原始出处 Google DeepMind
06/09
Ai2 发布 StateBench:测语言模型在长文档里追踪状态变化的能力
Ai2 推出长上下文状态追踪基准 StateBench,按难度分四级,数据和代码已开放。
StateBench 测的是:一个实体的信息在长文档中不断变化时,模型能不能一直追踪到正确状态,比如代码里变量反复赋值,或小说里人物移动、物品易手。最低一级 R-trivial 用的是不可变赋值,模型只需取回从未改变的初始值;第二级 Aperiodic 要求找出最近一次的值;最难一级包括 S₅ 置换问题,也就是追踪连续交换后五个物体的排列。Ai2 同时发布了技术报告、数据集和 GitHub 代码。
局限:本文不转述各模型的具体得分,结果以技术报告为准。
来源:有原始出处 Hugging Face Blog(Ai2) · GitHub:allenai/state-bench
07/09
Nexus Mods 要求 mod 作者必须声明是否使用 AI,已有 mod 有 60 天宽限
PC 游戏最大的 mod 站 Nexus Mods 将 AI 使用声明改为强制项,已有 mod 须在 1 月 2 日前补齐。
据 The Verge 报道,站长 Victor「Foledinho」Folmann 发帖宣布,新上传 mod 的作者必须声明作品中「是否使用了 AI」。网站原本已有「AI 生成」和「AI 辅助」两个标签,Folmann 说,用户最一致的担忧是 AI 的使用没有被清楚标出来。
局限:已有 mod 的作者有 60 天时间按新要求更新,宽限期到 1 月 2 日结束,之后网站才开始执行。被标为「AI 辅助」的 mod 还有额外要求,细节以原帖为准。
来源:单一报道 The Verge
区域与早期信号
MIT CSAIL 让 GPT-6 Astra 直接读取并修改 Qwen3.5-0.8B 的权重,修好了长达 3 万 token 的推理死循环。
据雷锋网报道,Qwen3.5-0.8B 做数学题时会写出 3 万多个 token、反复重复相似的推理,最后交不出答案。研究者让 GPT-6 Astra 检查模型内部权重、定位问题,再直接改参数,研究者把这种做法称为「权重空间编程」(Weight-Space Programming)。
| 模型状态 | MATH-500(%) |
|---|---|
| 原始 Qwen3.5-0.8B | 7.9 |
| Astra 改动约 0.016% 权重后 | 48.1 |
同一组实验里,Astra 只看权重、不运行网络,就认出了 4 个分别学会 Breakout、Pong、Pac-Man、Freeway 的网络(架构相同,各 17,253 个参数)。它还分析了 3 个约 720 万参数的字符级 Transformer,判断它们分别学的是 Python、罗马字日语还是英语。
局限:Chinese-language source,报道未附论文链接。实验对象都是小模型;报道也指出,游戏网络的输入位置有明确物理含义,而大型语言模型的隐藏维度没有这种标签,难度更高。
来源:单一报道 雷锋网
招商局狮子山人工智能实验室发布具身推理视觉语言模型「驭物™ Lion-ER-35B-A3B」,总参数约 35B,每个 token 激活约 3B,十项基准等权平均 65.29。
据量子位报道,模型的主要信息如下:
- 架构:MoE,总参数约 35B,每个 token 激活约 3B。
- 数据方法:用「能力牵引」的数据引擎替代大规模堆数据,把具身推理拆成实体、空间、时序、物理、可供性、任务、社会、证据 8 个一级领域和 39 项二级能力,再根据评测找到的短板迭代数据。
报道给出的部分评测成绩(括号内为报道给出的提升幅度):
| 基准 | 得分 |
|---|---|
| 十项基准等权平均 | 65.29 |
| Where2Place | 64.28(+9.30) |
| ERQA | 64.38(+6.19) |
| SAT | 89.33 |
| ERQA 轨迹理解 | 68.18(+12.12) |
局限:Chinese-language source,单一来源,以上成绩均为团队公布。「超越更大参数量的主流模型」是团队说法,暂无第三方复现。
来源:单一报道 量子位
本文由 AI 根据文中所附信源整理,经自动事实核查后发布,发布前未经人工逐篇审核;如与原文不一致,以原始出处为准。了解本日报的制作方式或报告错误:关于本日报