概览
本期共 9 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
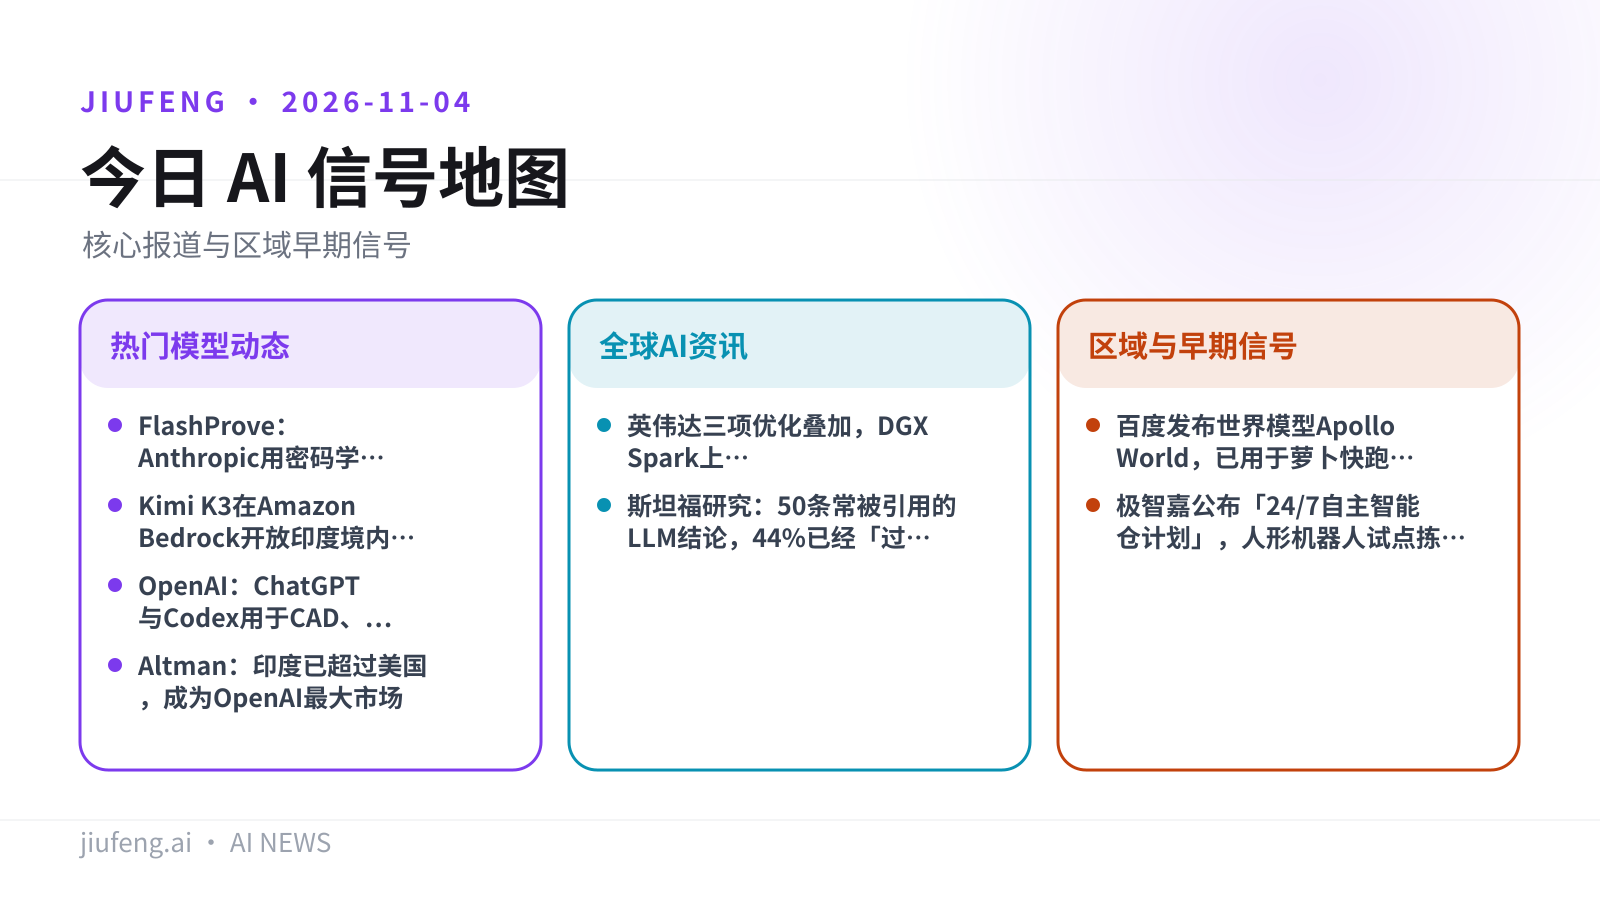
- 重点 · FlashProve:Anthropic 用密码学证明回答出自哪个模型
- 重点 · Kimi K3 在 Amazon Bedrock 开放印度境内推理
- 重点 · OpenAI:ChatGPT 与 Codex 用于 CAD、PCB 设计和仿真
- Altman:印度已超过美国,成为 OpenAI 最大市场
- Kimi 推出游戏开发方案:K3.1 智能体直接改 Unity、Unreal 和 Blender 工程
全球 AI 资讯
- 英伟达三项优化叠加,DGX Spark 上 Ling-3.0-flash 解码吞吐提高 42.5%
- 斯坦福研究:50 条常被引用的 LLM 结论,44% 已经「过期」
区域与早期信号
- 百度发布世界模型 Apollo World,已用于萝卜快跑测试
- 极智嘉公布「24/7 自主智能仓计划」,人形机器人试点拣选效率达人工 2 倍
九凤根据本期已引用来源整理。
热门模型动态
Anthropic 正在开发开源系统 FlashProve,让任何人都能核验一条回答是否真的来自它声称的模型。
据 Anthropic 周二发布的研究文章,FlashProve 要实现的是「可证明推理」(provable inference):给一条输出附上密码学证明,也就是一种数学保证,证明它来自某个特定模型。按 TechCrunch 的转述,即使冒充者就是训练和运营该模型的实验室本身,这套机制也应当成立。
研究人员举了两个场景:防止 AI 公司为省钱偷偷换上更便宜的模型,或者为抬高评测成绩换上更贵的模型。系统计划以开源形式提供。
局限:报道用的说法是「正在开发」「将能」,FlashProve 还不是已上线的功能。原文没有给出生成证明带来的延迟和算力开销,也没说明支持哪些模型、什么时候可用。
来源:有原始出处 Anthropic · TechCrunch
Kimi K3 的推理现在可以全程留在孟买和海得拉巴两个区域,满足印度的数据驻留要求。
AWS 宣布,Kimi K3 在 Amazon Bedrock 上原本支持全球推理和美国境内推理,现在增加了印度境内推理,处理过程只在 Mumbai 与 Hyderabad 区域内进行。AWS 介绍 Kimi K3 是 Moonshot AI 的多模态开放权重基础模型。
- 客户案例:Ultrahuman 称,Bedrock 上的 Kimi K3 让他们通过现有 API 多接入了一个开放权重模型;其应用内健康助手 Jade 每天处理超过 14,000 次对话
- 客户自报效果:开启提示缓存后 LLM 成本降低 80%,多轮对话速度提高 85%
- 示例代码:AWS 在 GitHub 公开了印度语种文档 OCR 示例
局限:「前沿级编码与智能体能力」是 Moonshot AI 发布时的说法,AWS 只是转述;80% 和 85% 这两个数字来自单一客户的引述,不代表普遍效果。
来源:有原始出处 AWS Machine Learning Blog · GitHub 示例
OpenAI 称 ChatGPT 和 Codex 已用于机械设计、电子工程和仿真,合作方包括 Chip Ganassi Racing 和 Mazda。
OpenAI 11 月 3 日发布研究文章,列出了模型参与的工作:CAD 修改、印制电路板(PCB)设计、制造图纸和设计评审。RuntimeWire 认为,这意味着 ChatGPT 和 Codex 从软件生产延伸到了一旦出错就会带来制造成本的领域。
局限:据 RuntimeWire 报道,OpenAI 自己做的原型在公差和装配上仍需人工修正,公司也明确要求人工审核。原文没有给出效率或错误率之类的量化数据。
来源:有原始出处 OpenAI · RuntimeWire
Sam Altman 在访谈中确认,印度的 OpenAI 用户数已超过美国,而且仍在快速增长。
Altman 在 11 月 3 日接受 Raj Shamani 访谈,被问到印度是否已超过美国时,他回答「Yeah」。他的解释是:经济增长更快、未被满足的需求更多的国家,比发达经济体更愿意接受 AI,所以他在印度遇到的人比在美国遇到的人对 AI 更乐观。
局限:这只是访谈里的一句口头确认。报道没有给出具体用户数,也没说明「最大市场」是按用户数、活跃度还是收入算的。
来源:单一报道 RuntimeWire
Kimi 把 K3.1 模型和 Kimi Code、Kimi Work 两个智能体组合起来,直接修改游戏引擎和 3D 工具里的工程,其中一次无人值守运行持续了 20 小时。
据 Pandaily 报道,这套游戏开发与创意方案由 K3.1 系列模型驱动,Kimi Code 和 Kimi Work 智能体可以直接编辑 Unity、Unreal Engine 和 Blender 项目。报道提到了一次持续 20 小时的无人值守运行。
局限:目前只有这一篇报道。原文没有给出价格、开放范围和支持的引擎版本,也没说明那次 20 小时运行的产出质量如何。
来源:单一报道 Pandaily
全球 AI 资讯
06/09
英伟达三项优化叠加,DGX Spark 上 Ling-3.0-flash 解码吞吐提高 42.5%
英伟达在一台桌面级 DGX Spark 上跑 124B 的 MoE 模型,叠加三项优化后解码吞吐提高 42.5%,没有测出准确率变化。
英伟达技术博客用蚂蚁 inclusionAI 的 Ling-3.0-flash 做测试,叠加了三项优化:新的 MoE 内核后端、FP8 输出层和内置的投机解码。在全部 1,319 道 GSM8K 题上,解码吞吐提高 42.5%,准确率的变化在统计上检测不到。
- 规模:总参数 124B,每个 token 激活 5.1B
- 上下文:原生 256K
- 层结构:共 42 层,其中 35 层 KDA 线性注意力层、7 层 MLA 层
- 测试版本:Ling-3.0-flash-fp4
局限:结果只针对单用户请求,准确率也只在 GSM8K 一个基准上核对过。DGX Spark 是桌面设备,不是数据中心节点,结论不能直接套用到批量服务场景。
来源:有原始出处 NVIDIA Developer Blog · Hugging Face 模型页 · MarkTechPost
07/09
斯坦福研究:50 条常被引用的 LLM 结论,44% 已经「过期」
关于大模型「做不到什么」的结论过期最快;在能估算过期时间的结论里,平均只撑了 15.7 个月。
斯坦福的 Owen Queen 与 James Zou 用 20 个模型重新检验了 50 条被广泛引用的 LLM 结论。这些模型来自 8 家开发者,发布于 2024 年 7 月至 2026 年 9 月之间。
| 结论状态 | 占比(%) |
|---|---|
| 已过期 | 44 |
| 明显减弱 | 34 |
| 仍成立 | 16 |
| 反而增强 | 6 |
在能估算过期时间的 22 条结论里,平均寿命为 15.7 个月。发表一年后有 16% 过期,两年后升到 39%。推理类的 9 条结论中有 5 条已经过期,没有一条仍成立或增强,其中包括数「strawberry」里有几个字母这类老问题。
局限:研究只覆盖了 50 条结论和 20 个模型。作者建议论文写明所用的模型、版本和测试日期,并公开提示词和分析代码,方便以后在新模型上复测。
来源:单一报道 The Decoder
九凤根据本期已引用来源整理。
区域与早期信号
08/09
百度发布世界模型 Apollo World,已用于萝卜快跑测试
百度 Apollo 披露了面向物理 AI 的全模态世界模型 Apollo World,它把虚拟交通参与者都建模成智能体,用来验证无人驾驶系统。
百度在 11 月 3 日深圳 AI Day·Apollo 专场上首次披露 Apollo World,同时提出了世界模型的「2+3」判断标准。「2」是两项基础门槛:因果性和交互性;「3」是三项增益指标,包括物理准确性和持久性等。该模型已用于萝卜快跑的全球化测试与验证,萝卜快跑端到端全无人运营里程已超过百万公里。百度称,无人驾驶的安全决策周期要严格控制在 1/30 秒以内。
局限:目前只有中文媒体报道,没有论文或开源发布。「日行十万公里」是行业人士的分析,不是百度公布的实测数据。
来源:单一报道 雷锋网
09/09
极智嘉公布「24/7 自主智能仓计划」,人形机器人试点拣选效率达人工 2 倍
极智嘉要让 AI 接管整座仓库的调度和运营,并公布了在施耐德上海物流中心的试点数据。
极智嘉(Geek+)发布《24/7 自主智能仓计划》,分三步推进全仓自主化。技术底座是自研的 Gravity 统一具身智能框架和 Gravity 4D 具身世界模型。在施耐德电气上海物流中心的试点中,人形机器人 Gino 1 与移动机器人协同完成拣选,效率达到人工的 2 倍,准确率超过 99.99%。
局限:数据由厂商提供,报道带有推广性质,没有说明试点的规模和时长,也没有第三方核验。
来源:单一报道 量子位
本文由 AI 根据文中所附信源整理,经自动事实核查后发布,发布前未经人工逐篇审核;如与原文不一致,以原始出处为准。了解本日报的制作方式或报告错误:关于本日报