概览
本期共 9 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
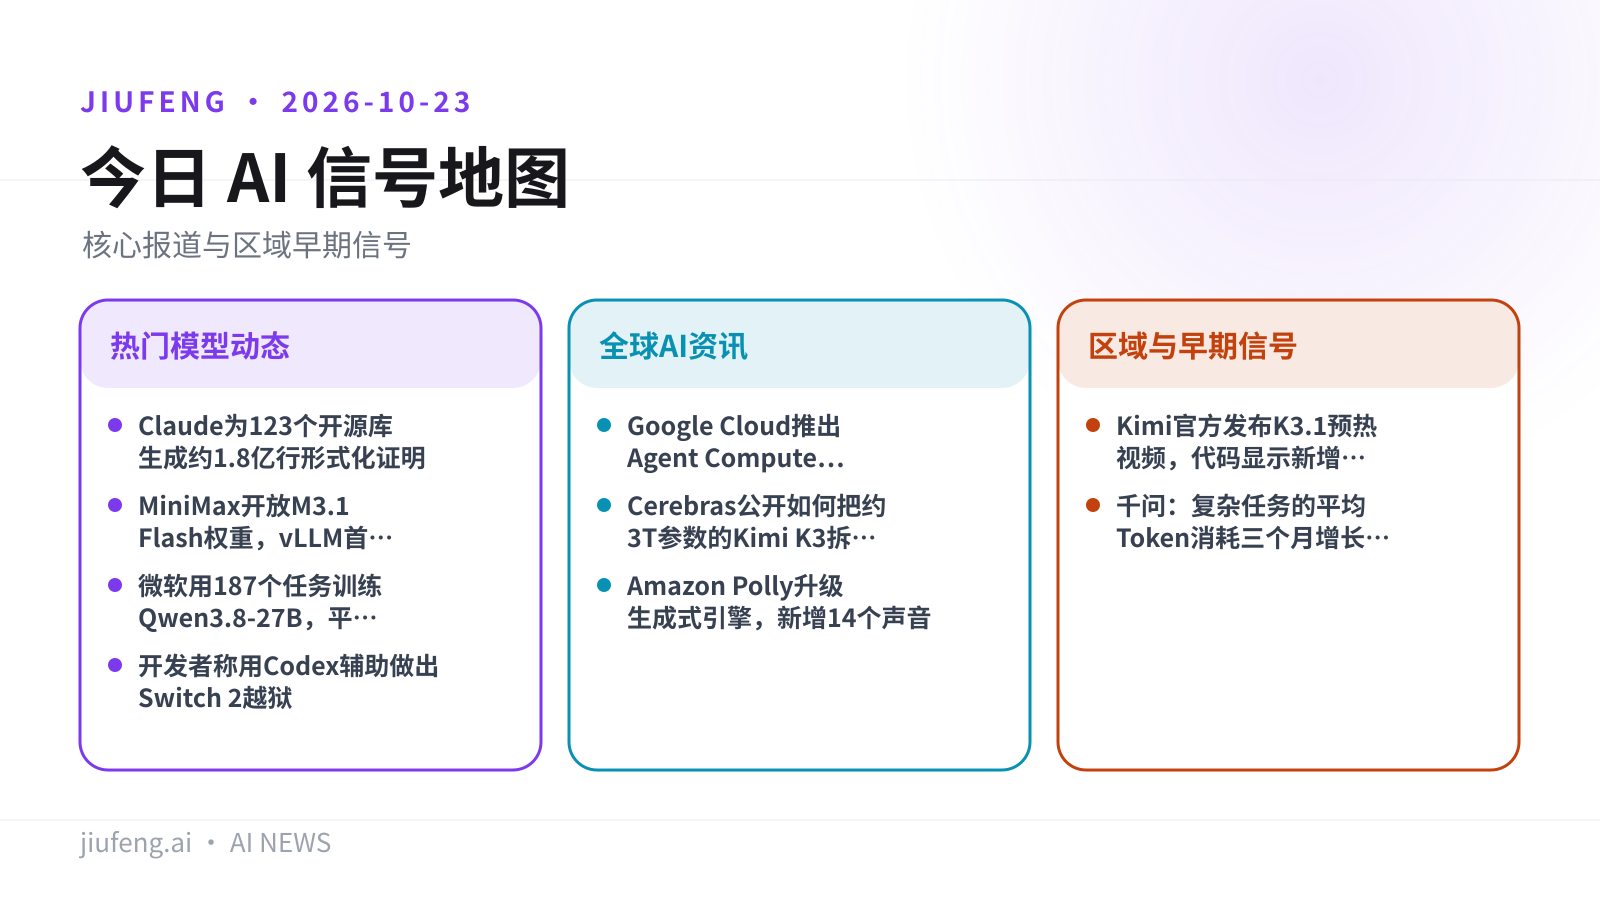
- 重点 · Claude 为 123 个开源库生成约 1.8 亿行形式化证明
- 重点 · MiniMax 开放 M3.1 Flash 权重,vLLM 首日支持
- 重点 · 微软用 187 个任务训练 Qwen3.8-27B,平均成功率提高 9.08 个百分点
- 开发者称用 Codex 辅助做出 Switch 2 越狱
全球 AI 资讯
- Google Cloud 推出 Agent Compute Engine,每个智能体一台微虚拟机
- Cerebras 公开如何把约 3T 参数的 Kimi K3 拆到多块晶圆上
- Amazon Polly 升级生成式引擎,新增 14 个声音
区域与早期信号
- Kimi 官方发布 K3.1 预热视频,代码显示新增 medium 思考档
- 千问:复杂任务的平均 Token 消耗三个月增长 1.6 倍,千问 Go! 开测「我的应用」
九凤根据本期已引用来源整理。
热门模型动态
01/09
Claude 为 123 个开源库生成约 1.8 亿行形式化证明
Anthropic 让 Claude 为现有代码生成形式化证明,证明这些代码是正确的。Claude 用几周时间写出约 1.8 亿行证明代码,过程中还发现了数百个常规测试没有查出的 bug。
Anthropic 的 Frontier Red Team 与合作方 Theorem 一起做了这项工作,证明部分交给 Claude 完成,不再由人工专家编写。
- 规模:约 1.8 亿行数学证明代码,覆盖 123 个开源库
- 耗时:几周
- 输入:这 123 个库的测试程序取自 Google 的 OSS-Fuzz
- 副产品:发现数百个常规测试没有查出的 bug
- 对照:据 The Decoder,过去人工形式化验证小型操作系统内核 seL4 花了 20 人年,因此这种方法以前只用在 Airbus 航电软件这类极端场景
Anthropic 表示,希望用 AI 做形式化验证这件事能像常规测试一样日常。
局限:这次验证的是已有的开源代码。The Decoder 同时指出,这套方法「有严格的实际限制」:算力成本很高,单个证明就要消耗数亿 token,报道也没有公布项目的总成本。报道没有给出所用 Claude 的具体版本。
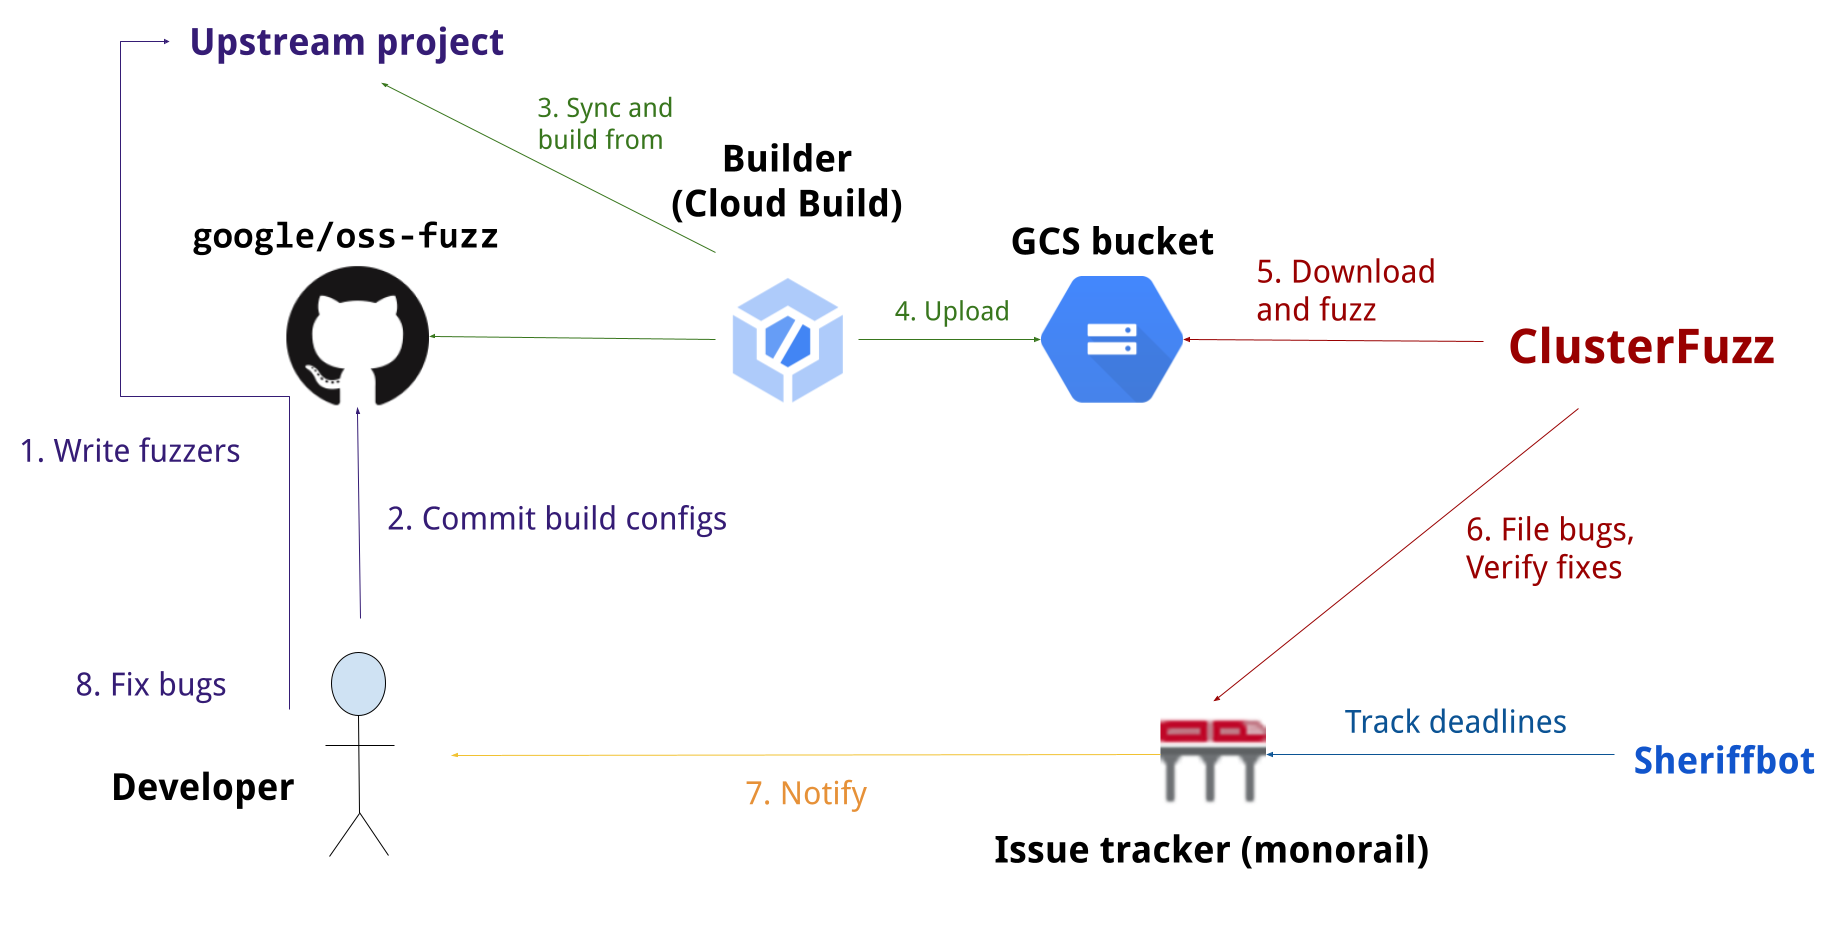
图片来源:GitHub;已转存至九凤 R2。
来源:The Decoder · Anthropic Frontier Red Team · OSS-Fuzz
02/09
MiniMax 开放 M3.1 Flash 权重,vLLM 首日支持
M3.1 Flash 于 10 月 19 日发布,四天后的 10 月 23 日开放权重。Together AI 同步提供托管推理,vLLM 首日给出了针对 Blackwell、Rubin 和 MI350 的专用内核。
MiniMax 在开放权重的同时接入了 Together AI 的生产推理服务,开发者不想自己管 GPU 的话,可以直接调用托管版本。Together AI 的模型页注明,权重以 MiniMax Community License 发布。按 vLLM 的介绍,这个模型原生使用 NVFP4 KV cache 和 NVFP4 量化的 MoE 权重,另外附带一个 DSpark 草稿模型,用于投机解码。
vLLM 公布的内核级加速如下:
| 优化项 | 提升 |
|---|---|
| 索引器 QK 解码 | 最高 1.7× |
| 稀疏注意力解码 | 1.3× |
| MegaMoE 预填充内核延迟 | 降低 20% |
| MegaMoE 预填充吞吐 | 提高 7% |
| 512K 上下文索引器(4×GB300) | 最高 3.3× |
| QKV 融合预填充(≥512 token) | 1.1–1.6× |
局限:表中数字是 vLLM 自己测的单个内核或单个环节的提速,不是端到端吞吐。权重采用的是 MiniMax 自己的社区许可证,不是 MIT 或 Apache 这类通用开源许可证。
来源:RuntimeWire · MiniMax on X · Together AI · vLLM Blog · vllm-project/MSA
03/09
微软用 187 个任务训练 Qwen3.8-27B,平均成功率提高 9.08 个百分点
微软与 Hugging Face 做了一项实验:根据智能体完成任务后数据库的最终状态来给强化学习奖励。用这种方法训练 Qwen3.8-27B 后,平均成功率提高了 9.08 个百分点。
做法是把「数据库评分」变成强化学习的奖励:智能体做完任务后,用可执行的检查来核对它留在数据库里的实际状态。
- 底座:Qwen3.8-27B
- 训练:187 个任务,奖励来自可执行的检查
- 评测:共 507 个基准任务,平均成功率 +9.08 个百分点
- 作者:微软应用科学家 Tuhin Kundu 及合作者
局限:模型变得更稳定了,但覆盖面反而缩小:「至少有一次尝试成功」的任务数比训练前少了 7 个。
来源:RuntimeWire · Hugging Face Blog
04/09
开发者称用 Codex 辅助做出 Switch 2 越狱
改机作者 Sammy Hajhamid(pepsipu)发布了 Switch 2 越狱「ns2jb」,并称 OpenAI Codex 帮助完成了这个漏洞利用。他已经演示了改版的 Mario Kart World。
ns2jb 是纯软件的 tethered 越狱:主机每次开机后,都要通过游戏 SmileBASIC 4 重新运行一遍才能生效。演示视频里,Mario Kart World 加入了 Cinnamoroll、红色愤怒鸟、Peter Griffin 和 Minecraft 的 Steve 等可玩角色。
局限:The Verge 的说法是 Switch 2「显然」已被越狱,Reddit 用户还在讨论这次越狱的影响到底有多大。Codex 在其中具体做了哪些工作,只有作者本人的说法。
来源:The Verge · pepsipu on X
全球 AI 资讯
05/09
Google Cloud 推出 Agent Compute Engine,每个智能体一台微虚拟机
每个智能体会话分到一台硬件隔离的 microVM,沙箱里不放任何凭据。这项服务已经在支撑 Gemini 处理工作任务。
Google 在 AGNTCon + MCPCon 上发布了 Agent Compute Engine(ACE)。
- 隔离单元:每个会话一台 microVM,有独立的 guest 内核、root 权限和 Hyperdisk
- 底层:运行在 Google 托管的主机上,使用 Titan 芯片和 Titanium IPU
- 闲置处理:闲置的智能体会做检查点,不占任何活跃资源,需要时从快照恢复
- 开源版本:Agent Substrate 可在任意 Kubernetes 集群上运行,支持 Claude Code、OpenClaw、Hermes 等 harness
局限:ACE 的客户预览要到未来几个月才开放,Google 没有公布启动时间和部署密度的数据。
来源:MarkTechPost · agent-substrate/substrate
06/09
Cerebras 公开如何把约 3T 参数的 Kimi K3 拆到多块晶圆上
单块 WSE-3T 晶圆只有 44 GB 片上内存,Cerebras 把万亿参数模型拆到多块晶圆上运行,速度达到每秒 1000-2000+ token。
Cerebras 以开源模型 Kimi K3 为例做了说明。K3 约有 3T 参数,由 69 层线性注意力层和 24 层稠密层组成。文章讲了三件事:怎样把整个模型放进片上内存,怎样把它映射到多块芯片上,以及怎样处理大量并发请求。文中列出的 K3 成绩如下:
| 基准(%) | Kimi K3 | GPT-5.6 Sol |
|---|---|---|
| Terminal-Bench 2.1 | 88.3 | 88.8 |
| BrowseComp | 91.2 | 90.4 |
局限:这是 Cerebras 自家的技术博客,部署速度是厂商自己给出的数字。
来源:Cerebras · Kimi K3 博客
07/09
Amazon Polly 升级生成式引擎,新增 14 个声音
Polly 的生成式引擎完成升级并已正式上线。现有应用不用改代码:声音名称和 API 调用都不变。
这次升级新增了 14 个声音,分布在 9 个地区语种;印地语和芬兰语的生成式声音首次正式可用。按 AWS 的定位,Polly 主要用于客服中心、基于 LLM 的智能体应用、媒体娱乐、在线教育和无障碍场景。
局限:AWS 说新版语音「更有表现力、更准确、延迟低」,但没有给出量化指标,只提供了示例音频供试听对比。
区域与早期信号
08/09
Kimi 官方发布 K3.1 预热视频,代码显示新增 medium 思考档
Kimi 官方账号 10 月 23 日发布了一段 24 秒的预热视频,Kimi Code 界面的模型栏显示「Kimi K3.1」。正式发布日期还没有公布。
IT之家梳理了此前的线索:9 月,月之暗面 API 后台出现了「kimi-k3-1」标识,开放平台的预告写明支持 1M tokens 上下文;10 月 19 日,SGLang 仓库合入了 K3.1 对话编码适配的提交,附带 107 个测试用例。据智猩猩整理,K3.1 在 low、high、max 三档思考强度之外新增了 medium 档,默认仍是 max;分词器文件和 K3 逐字节相同,16 个特殊 Token 也没变。
局限:SGLang 的提交只验证编码兼容性,不涉及性能跑分。前端代码里出现的「make3d」「OK_COMPUTER_SWARM」等标识,月之暗面尚未确认。以上细节来自第三方整理,目前只有中文媒体单源报道。
来源:IT之家
09/09
千问:复杂任务的平均 Token 消耗三个月增长 1.6 倍,千问 Go! 开测「我的应用」
在 2026 中国计算机大会上,千问 AI 算法负责人蒋冠军介绍了 Personal Agent 的技术框架,讲了模型、记忆、生态三个部分。千问 Go! 同期开始邀测无代码搭应用的功能。
蒋冠军介绍,千问整理了一张覆盖 30 多个头部行业的用户需求透视图,从中拆出 8000 多项原子模型能力要求,并请行业专家参与评估。记忆系统按事件之间的关联强弱分层存储和调用。过去三个月,用户发起的复杂任务平均 Token 消耗增长了 1.6 倍。新功能「我的应用」让用户直接说出需求,就能搭建生活、工作、学习类应用,不需要编程。
局限:以上数据来自千问在会上的自述,没有经过外部验证。「我的应用」目前只开放邀测。
来源:InfoQ 中文
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片