概览
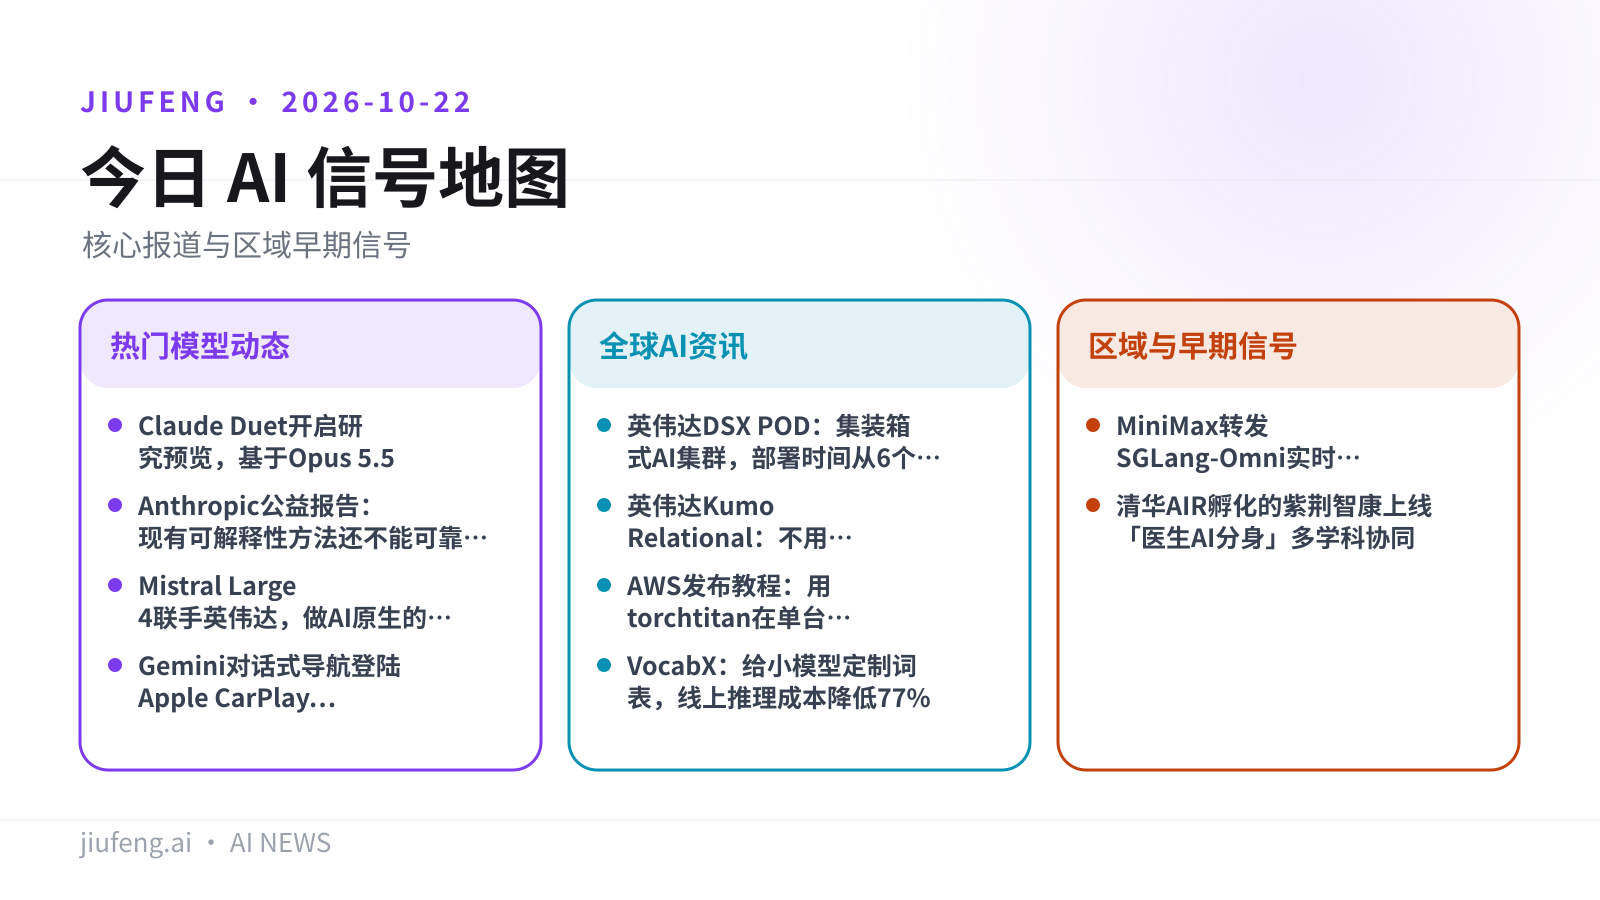
本期共 10 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
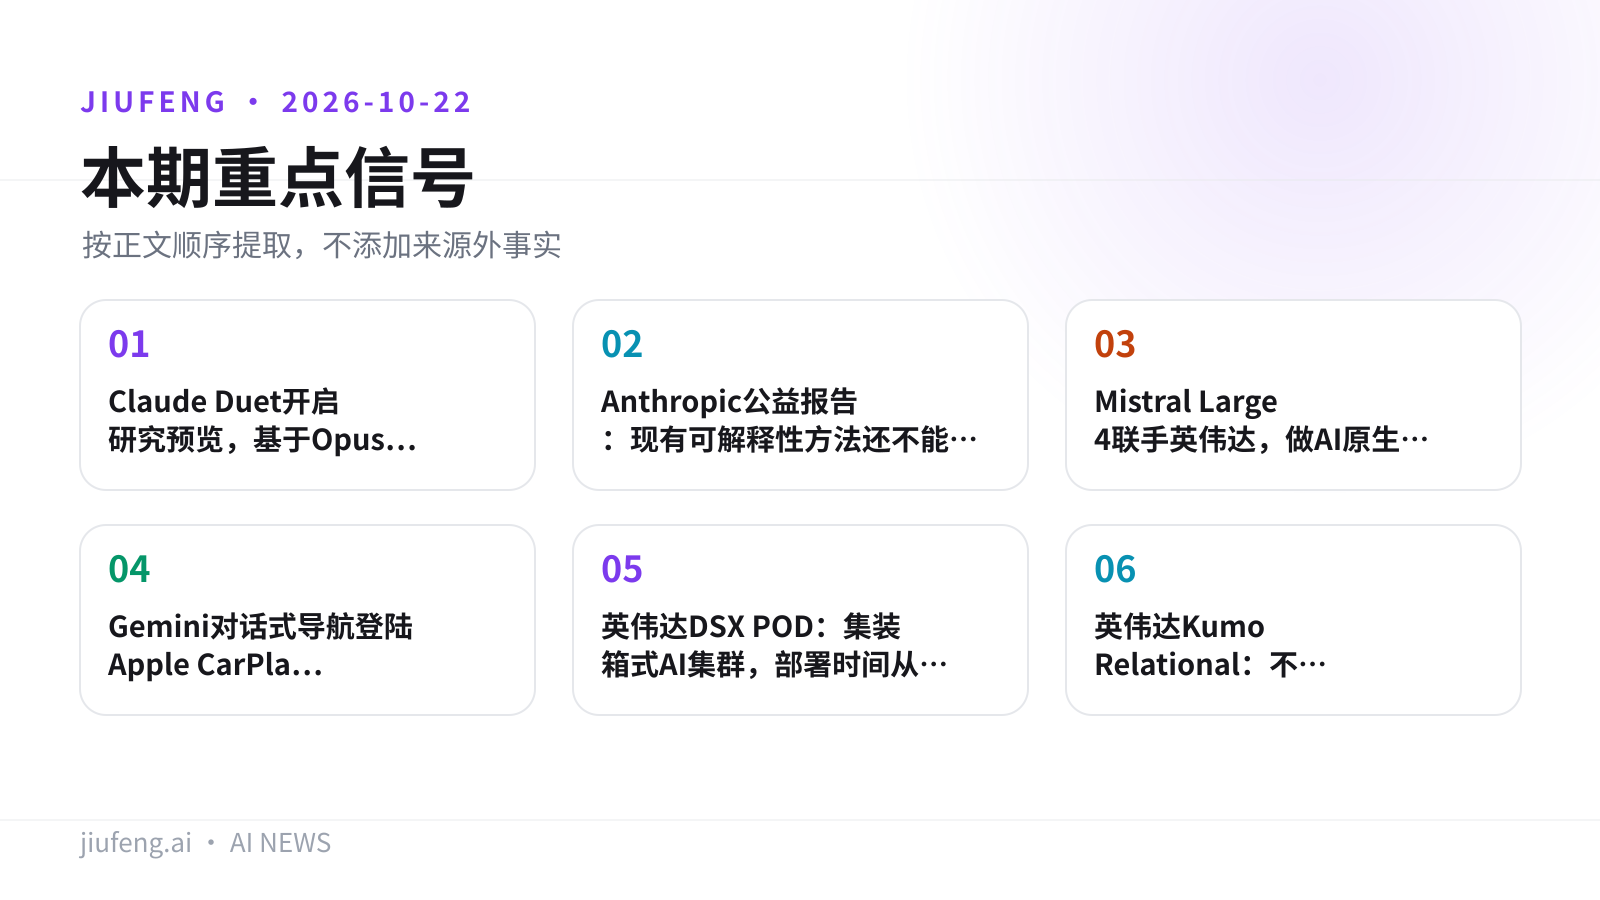
- 重点 · Claude Duet 开启研究预览,基于 Opus 5.5
- 重点 · Anthropic 公益报告:现有可解释性方法还不能可靠发现所有危险行为
- 重点 · Mistral Large 4 联手英伟达,做 AI 原生的工程仿真流程
- Gemini 对话式导航登陆 Apple CarPlay,美国先上线
全球 AI 资讯
- 英伟达 DSX POD:集装箱式 AI 集群,部署时间从 6 个月缩到 14 天
- 英伟达 Kumo Relational:不用训练,41 项关系型任务超过监督学习
- AWS 发布教程:用 torchtitan 在单台 Trainium 实例上训练 Qwen3
- VocabX:给小模型定制词表,线上推理成本降低 77%
区域与早期信号
- MiniMax 转发 SGLang-Omni 实时多模态推理指南
- 清华 AIR 孵化的紫荆智康上线「医生 AI 分身」多学科协同
九凤根据本期已引用来源整理。
热门模型动态
01/10
Claude Duet 开启研究预览,基于 Opus 5.5
Anthropic 向部分候补名单用户开放 Claude Duet 研究预览。这是一个基于 Opus 5.5 的个人助理,可在多个终端上使用。
- 底座模型:Claude Opus 5.5
- 支持平台:iPhone、Android 和网页端
- 开放方式:候补名单用户可进入研究预览
- 沿用内容:账户里的记忆、技能和已连接的应用
Duet 会判断哪些事需要用户亲自处理、哪些可以先放一放,也会判断什么时候应该先征求用户的意见。
局限:目前只是候补制研究预览,还没有全面开放。
来源:Claude(X) · RuntimeWire
02/10
Anthropic 公益报告:现有可解释性方法还不能可靠发现所有危险行为
Anthropic 的《2026 公益报告》承认,核心安全工作还没有完成。另有一份评估回顾了公司此前披露过的网络安全事件。
报告写明,目前的可解释性方法还不够可靠,不能保证发现模型的每一种危险行为。公司也承认仍有安全缺口,独立监督也有限。报告把这些不足和 Anthropic 的公益承诺放在一起对照,公司的公益章程页面可以找到这份报告。另有一份评估在 9 月 9 日发布,补充了 Anthropic 此前披露过的网络安全事件的细节。
局限:根据报道,这些网络测试没有启用正式发布的模型所带的防护措施,因此测试中的表现不等于线上模型的表现。这份报告是 Anthropic 的自我评估,没有经过第三方核验。
来源:Anthropic 公益章程 · RuntimeWire
03/10
Mistral Large 4 联手英伟达,做 AI 原生的工程仿真流程
Mistral 把 Large 4 和自家的数据生成、物理建模管线接入英伟达的加速计算,并承诺发布公开基准和开放数据集。
- 模型:Mistral Large 4,搭配 Mistral 自己的数据生成和物理建模管线
- 加速栈:英伟达 CUDA-X 库和 NVIDIA Warp;3D 仿真和资产创建使用 Omniverse
- 评测:将推出公开基准和开放数据集,用来统一计算机辅助工程(CAE)中物理 AI 与智能体 AI 的评测
- 目标行业:航空航天、汽车、半导体
Mistral 称,这项合作的目标是让仿真更快,并实现由 AI 驱动的闭环设计。
局限:目前只是合作方向的公告,来源没有给出基准分数、仿真提速倍数,也没有给出数据集的发布时间。
来源:Mistral AI · NVIDIA Warp
04/10
Gemini 对话式导航登陆 Apple CarPlay,美国先上线
Gemini 对话导航去年先在 Android Auto 上线,现在 Google 地图把它带到了 CarPlay。
从今天起,美国的 CarPlay 用户可以在 Google 地图里点击 Gemini 图标,用语音和 Gemini 对话。它支持多步提问,比如先请它推荐可以去的地方,再让它导航过去并避开收费路段。Google 去年先在 Android Auto 上推出了这个助手。
局限:Google 只说「也在全球推送」。The Verge 已向 Google 询问具体开放哪些地区,目前还没有得到答复。
来源:The Verge
全球 AI 资讯
05/10
英伟达 DSX POD:集装箱式 AI 集群,部署时间从 6 个月缩到 14 天
英伟达在 GTC Berlin 发布 DSX POD 参考架构,GPU、CPU、网络、散热和配电设备全部在工厂预装好。
DSX POD 是一份参考架构,合作伙伴可以按照它造出装在集装箱里的 AI 集群。每个集装箱里都有 Rubin GPU、Vera CPU、网络设备、散热设备和配电模块,出厂前就完成集成和测试,客户不需要自己组装。英伟达估计,硬件部署时间可以从 6 个月缩短到 14 天。Dell、HPE 等十多家厂商是合作伙伴。
局限:「6 个月缩到 14 天」是英伟达自己的估算,目前还没有客户的实际部署数据。
来源:SiliconANGLE
06/10
英伟达 Kumo Relational:不用训练,41 项关系型任务超过监督学习
这是一个预训练的关系型基础模型,可以直接在企业数据库上做预测,一次前向推理就能得出结果。
Kumo Relational 收到预测查询后,会收集最多 10,000 条历史样例作为上下文,用来预测客户流失、需求、欺诈等结果。它不需要针对具体任务训练,不需要做特征工程,也不需要把多张表合并成一张。在 15 个数据库的 41 项任务上,它的表现超过了监督式关系深度学习模型,也超过了专家搭建的梯度提升树管线。英伟达称它可以扩展到 5000 亿行以上的数据,既能通过开源库 structured-data-models 使用,也能作为 NVIDIA NIM 使用。
局限:基准成绩来自英伟达自己的博客和论文,还没有独立复现。
来源:Hugging Face 博客 · 论文 · 文档
07/10
AWS 发布教程:用 torchtitan 在单台 Trainium 实例上训练 Qwen3
TorchNeuron 把 Trainium 注册成原生的 PyTorch 设备,所以 torchtitan 的用法基本不用改。
教程在单台 trn2.48xlarge 上用三种方式训练 Qwen3:
- 方式一:把 Transformers v5 作为 torchtitan 的建模后端,通过 AutoModelForCausalLM 运行 Hub 上的模型,直接读写已发布的 safetensors 权重
- 方式二:修改 config.model_spec,切换到 torchtitan 原生的 Qwen3 实现
- 方式三:加入 torchtitan-neuron 配方里的 NKI 混合专家(MoE)内核,也可以通过 override 注册表挂接自己写的内核
三种方式都用同样的 torchrun 命令和配置结构启动。既可以从随机初始化开始预训练,也可以微调已发布的权重。
局限:这是 AWS 的上手教程,摘录里没有吞吐量或成本数据。运行环境要求使用 Neuron 版深度学习 AMI,或者 Neuron PyTorch 训练容器。
来源:AWS Machine Learning Blog · torchtitan-neuron
08/10
VocabX:给小模型定制词表,线上推理成本降低 77%
Dharma-AI 按每个 token 的成本、而不是出现频率来重建词表。底座模型没有换,实测推理成本降低了 77%。
团队在生产环境运行一个葡萄牙语作文评分模型,它基于 Qwen3-4B 构建。这个模型沿用的通用词表,会把它最常输出的文本切成很多个 token。VocabX 按每个 token 的成本重新定制词表,在底座模型不变的情况下,把实测推理成本降低了 77%。作者认为,对只服务单一领域的模型来说,分词器可能是最大的成本杠杆之一,而且它在训练开始前就已经定下来了。
局限:这只是 VocabX 论文的结果预览,论文还没有发表。数据来自单一的线上应用,换到其他任务能省多少还不清楚。
九凤根据本期已引用来源整理。
区域与早期信号
09/10
MiniMax 转发 SGLang-Omni 实时多模态推理指南
这份教程讲的是用同一个运行时协调实时语音对话里的多个模型。MiniMax 没有说自己在用它。
10 月 21 日,MiniMax 分享了 SGLang-Omni 的教程和代码。SGLang-Omni 是一个运行时,可以在持续进行的语音对话中协调多个模型,涉及语音模型、打断处理和持久会话。
局限:报道特别说明,这条分享只是指向 SGLang 的技术工作,不表示 MiniMax 已经采用这个运行时、参与了贡献,或者把自家模型接入了它。
来源:MiniMax(X) · RuntimeWire
10/10
清华 AIR 孵化的紫荆智康上线「医生 AI 分身」多学科协同
紫荆智康发布多分身智能体协同技术,并升级了「紫荆AI医院」(Agent Hospital)。
这套系统给每位医生配一个专属的 AI 分身。在预问诊和首诊阶段,如果系统发现患者需要其他专科参与,就会把相关专科分身的意见以提醒的方式推给医生。比如一位甲亢患者同时有哮喘病史,系统就会提示相关专科的意见。各个分身的建议分开显示,意见不一致的地方会高亮,最后由人类医生做判断。这条技术路线来自清华 AIR 刘洋教授团队。
- 门诊测试:北京清华长庚医院 18 个临床科室在做门诊测试,40 余名医生常态化使用
- 效率:整体诊疗效率提升 30%
- 评测:AI 医生在 MedQA 上准确率超过 96%
- 规模:截至 2026 年 7 月,系统已构建 54 位 AI 医生
局限:目前只有一家中文媒体报道,以上数字都来自这篇报道,还没有其他来源交叉核实。
来源:量子位
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片