概览
本期共 11 条,前 3 条为今日重点;正文按板块展开。
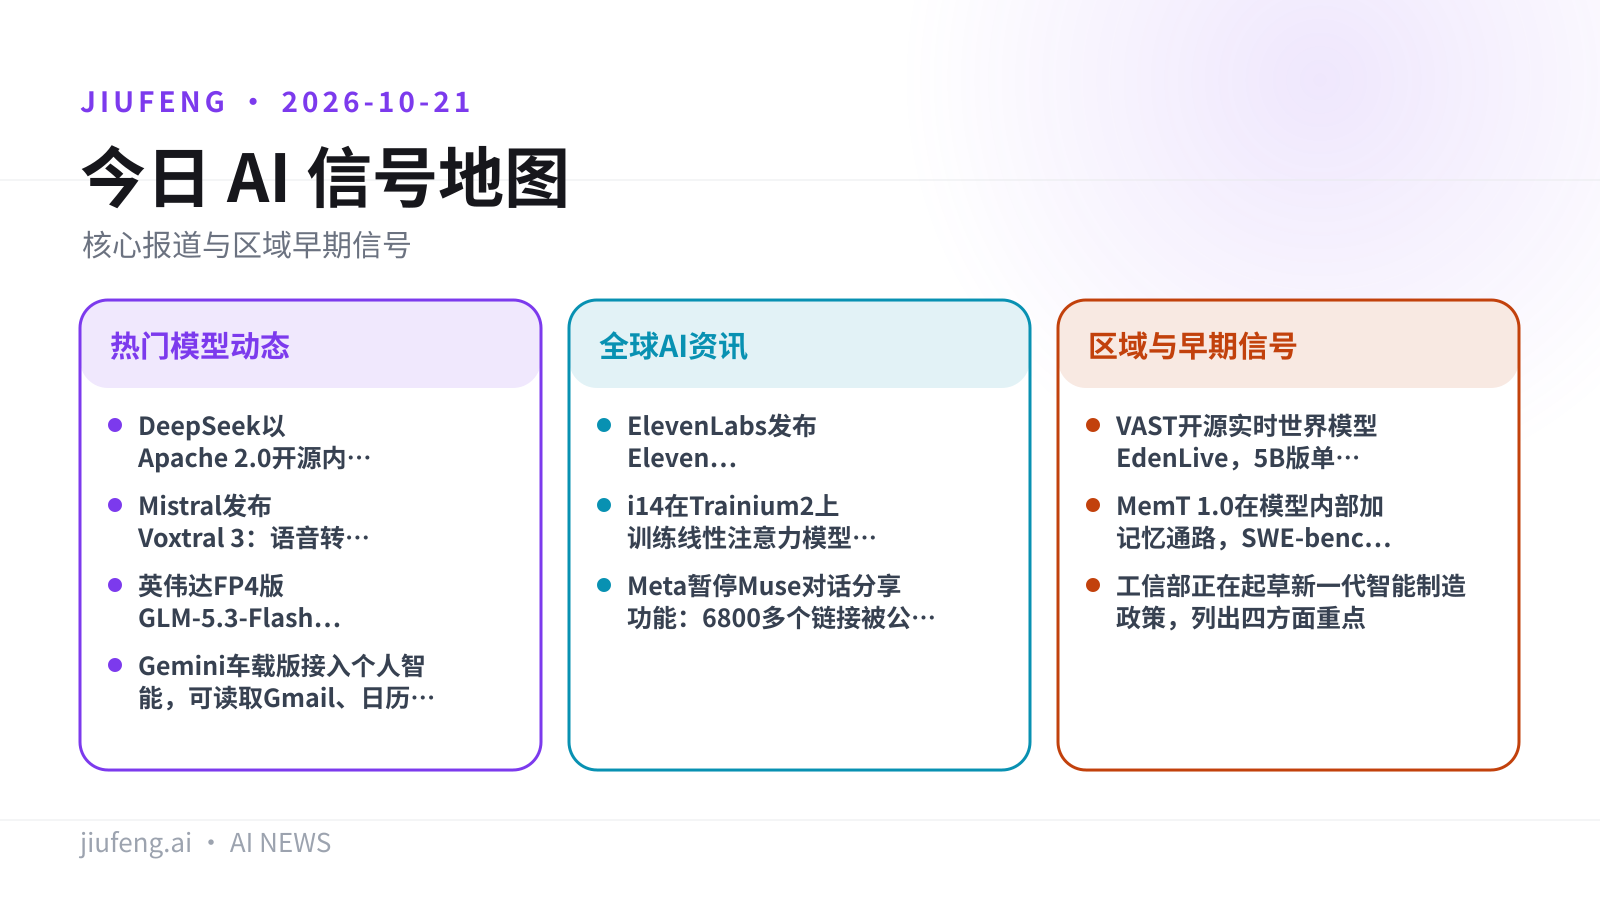
热门模型动态
- 重点 · DeepSeek 以 Apache 2.0 开源内部推理框架 DeepInfer
- 重点 · Mistral 发布 Voxtral 3:语音转写、语音合成和智能体 SDK 打包提供
- 重点 · 英伟达 FP4 版 GLM-5.3-Flash 本地运行需要两张 GPU
- Gemini 车载版接入个人智能,可读取 Gmail、日历和相册
- GPT-5.6、GPT-6、GPT-6.1 通过跨区推理在 Bedrock 加拿大区开放
全球 AI 资讯
- ElevenLabs 发布 Eleven Realtime:Big Bench Audio 98.8%,响应 0.57 秒
- i14 在 Trainium2 上训练线性注意力模型 Laplace 3B,状态固定 29.5 MB
- Meta 暂停 Muse 对话分享功能:6800 多个链接被公开发现
区域与早期信号
- VAST 开源实时世界模型 EdenLive,5B 版单张 5090 跑 720P 超过 24 FPS
- MemT 1.0 在模型内部加记忆通路,SWE-bench Verified 平均成功率 69.73%
- 工信部正在起草新一代智能制造政策,列出四方面重点
九凤根据本期已引用来源整理。
热门模型动态
01/11
DeepSeek 以 Apache 2.0 开源内部推理框架 DeepInfer
DeepSeek 开源了支撑 V4.1-Flash 线上服务的推理框架,同时发布一个复刻官方 API token 处理逻辑的配套仓库。
DeepInfer 是 DeepSeek 内部使用的推理服务框架,按 Apache License 2.0 开源。它基于 vLLM 开发,加入了优化过的计算内核、跨多芯片的分布式处理,以及加快文本生成的技术。DeepSeek 表示,之后新模型的推理代码也会开源。
同时发布的 deepseek-recipe 复刻了官方 DeepSeek API 的 token 处理流程,让自托管部署和官方 API 的行为一致。DeepSeek 在 X 上说,目标是「帮助社区降低算力成本、减少能耗」。The Decoder 认为,这会让 OpenAI、Anthropic 等西方厂商面临更大的价格压力。
局限:报道没有给出 DeepInfer 和原版 vLLM 的吞吐或延迟对比,提速和省成本的幅度目前只有官方的定性说法。框架主要面向 DeepSeek 自家模型,用在其他模型上效果如何,报道没有说明。
图片来源:GitHub;已转存至九凤 R2。
来源:The Decoder · GitHub: deepseek-ai/DeepInfer · 钛媒体
02/11
Mistral 发布 Voxtral 3:语音转写、语音合成和智能体 SDK 打包提供
Voxtral 3 是一套实时语音智能体方案,用一条流式管线完成听、想、调工具和说话。
Voxtral 3 包含以下几部分:
- 语音转写:Voxtral Small Transcribe 3,支持 50 多种语言
- 语音合成:Voxtral Mini TTS 3,支持 35 种以上语言、50 种方言,可以调整情绪
- 智能体 SDK:基于 LiveKit,对话中可以调用外部系统,比如预约、查发票
- 部署与价格:可以部署在自有基础设施上,也可以用 Mistral 的欧盟托管 API;转写每分钟 0.0035 美元起
局限:报道只给了转写的起步价。语音合成和智能体 SDK 的收费、模型参数量和许可证都没有写,需要到官方文档核对。官方页面上的多语言预约演示是厂商自己做的样例。
来源:Mistral AI · Mistral 文档 · The Decoder
03/11
英伟达 FP4 版 GLM-5.3-Flash 本地运行需要两张 GPU
英伟达在推广本地跑大模型,但它为 GLM-5.3-Flash FP4 检查点验证过的配置,都要两块卡或两台机器。
英伟达 RTX Spark 10 月 20 日在 X 上推荐了两个 FP4-Local 检查点。其中基于 Z.ai GLM-5.3-Flash 的版本 10 月 5 日就已上线,Qwen 的版本体积更小。
| 检查点 | 占用 | 英伟达验证的配置 |
|---|---|---|
| GLM-5.3-Flash FP4 | 约 166 GiB 显存 | 两张 RTX PRO 6000 Blackwell 或两台 DGX Spark |
| Qwen 对应版本 | 约 96 GiB 磁盘 | 单台 DGX Spark 或单张 RTX PRO 6000 Blackwell,需要 offload |
局限:「本地推理」仍可能需要多卡或多机。Qwen 版单卡运行要靠 offload,来源没有给速度数据。GLM 检查点 10 月 5 日就已发布,不是当天的新版本。
来源:RuntimeWire · NVIDIA RTX Spark(X)
04/11
Gemini 车载版接入个人智能,可读取 Gmail、日历和相册
Android Auto 上的 Gemini 从今天起陆续可以调用用户在多个 Google 应用里的个人信息,内置 Google 系统的汽车要再等几个月。
这次更新把 Personal Intelligence 带到车载 Gemini,可以读取 Gmail、Calendar、Maps、Photos、YouTube 和 Search 里的信息。Google 举了三个例子:开车去机场时问航班状态,Gemini 会从 Gmail 的确认邮件里找出航班信息再去查询;说「带我去看医生」,会直接导航到预约地点;说「找到我上周拍的那家洗车店并导航过去」。
局限:功能今天开始在 Android Auto 推送,内置 Google 系统的汽车要在未来几个月才支持。上面的例子都是 Google 自己给的演示。
05/11
GPT-5.6、GPT-6、GPT-6.1 通过跨区推理在 Bedrock 加拿大区开放
加拿大的两个 AWS 区域现在可以调用 OpenAI 的三代 GPT 模型,请求由 Bedrock 路由到其他支持的区域处理。
AWS 宣布,通过 Amazon Bedrock 跨区推理(CRIS),Canada (Central) 和 Canada West (Calgary) 两个区域可以调用以下模型:
- GPT-5.6:Sol、Terra、Luna
- GPT-6:Astra、Sol、Luna
- GPT-6.1:Sol
应用调用源区域的 Bedrock Runtime 端点,Bedrock 再把请求路由到支持的目标区域处理,开发者不用自己管理路由。
局限:AWS 把跨区推理定位为一种容量机制,处理可能发生在加拿大境外;按文中的推理配置说明,只有 US 地理配置(us.)会把处理限制在北美(加拿大和美国)范围内。有数据驻留要求的机构,需要按文中的说明选择配置并逐项确认。
来源:AWS Machine Learning Blog · GitHub: aws-bedrock-token-generator-python
全球 AI 资讯
06/11
ElevenLabs 发布 Eleven Realtime:Big Bench Audio 98.8%,响应 0.57 秒
ElevenLabs 推出两款实时语音到语音模型,Max 版主打准确率,Mini 版主打低成本对话。
Eleven Realtime v1 Max 在 Big Bench Audio 上得分 98.8%,响应时间 0.57 秒,面向客服等复杂任务。v1 Mini 面向自然对话,成本更低,能分辨对方是说完了,还是只在「嗯嗯」附和。两款模型都可以通过 ElevenAgents 平台和兼容 OpenAI 的 Realtime API 使用,按分钟加 token 计费,Max 比 Mini 贵。
局限:「Artificial Analysis 榜单上目前没有比它更快又更准的模型」是 ElevenLabs 自己的说法。报道没有列出具体单价,需要去官方定价页查。
来源:The Decoder
07/11
i14 在 Trainium2 上训练线性注意力模型 Laplace 3B,状态固定 29.5 MB
Laplace 3B 用线性注意力替代 KV cache,每条序列的循环状态不会随上下文变长而增大。
i14 和 AWS 借助 TorchNeuron Native 的原生 PyTorch 支持,把这个自定义架构搬到 Trainium2 上,保留了 Gated Linear Attention 设计和 Muon 优化器。
- 状态大小:每条序列 29.5 MB,与上下文长度无关
- 训练:单台 trn2.48xlarge,约 12 万 tokens/s
- 推理:1280 条并发序列,输出合计 11,544 tokens/s
局限:数据来自 AWS 和 i14 联合发布的博客,摘录里没有模型质量的评测分数。文中没有说明这个方案能否扩展到 3B 以上的规模。
来源:AWS Machine Learning Blog · GLA 论文(arXiv) · Muon 参考实现
08/11
Meta 暂停 Muse 对话分享功能:6800 多个链接被公开发现
研究人员从公开 DNS 记录里找到大量 Muse 分享链接,其中有企业营收、贷款申请等敏感内容。
安全公司 Claroc 的报告称,研究人员通过公开 DNS 记录找到 6800 多个 Muse 分享链接,内容包括一家营销公司的营收、某个工作场所的日程和一份贷款申请。Muse 发言人 Tracy Clayton 回应称,分享功能生成的页面「持有链接即可访问」,目前已暂停该功能,正在审查这份报告。
局限:Meta 只说暂停并审查,没有说明是否会撤下已经公开的链接,也没有给出恢复时间。
来源:The Verge · Ars Technica
区域与早期信号
09/11
VAST 开源实时世界模型 EdenLive,5B 版单张 5090 跑 720P 超过 24 FPS
EdenLive 根据参考画面实时重绘游戏画面,游戏规则和状态仍由上游交互系统负责。
EdenLive 是 Project Eden 系列里的实时生成式渲染器,有三类输入:参考视频决定布局、镜头和物体轨迹,目标首帧决定主体和画风,文本提示补充细节。团队用 Gemini-3.8-Flash 对 45 个长时案例做两两盲评,五个维度上 14B 和 5B 都排前两名;14B 的参考遵循 Elo 为 1704,比 AgentGarten 高约 200 分。5B 版在单张 RTX 5090 上能以超过 24 FPS 生成 720P 画面,可以连续生成几分钟。
局限:评测和速度数据都是团队自己公布的,评委是模型而不是人。报道没有写开源许可证。
来源:爱范儿
10/11
MemT 1.0 在模型内部加记忆通路,SWE-bench Verified 平均成功率 69.73%
MemT 把经验编码成模型内部可更新的状态,在编程任务上的效果和「文本经验」方案接近。
MemT 在选定的 Transformer 模块里加了一条和注意力并行的记忆计算通路。Nano 版总参数 36B、激活 3B,基座是 Qwen3.6-35B-A3B;Flash 版总参数 288B、激活 17B,基座是经过进一步后训练的 DeepSeek-V4-Flash。下表是 Nano 版的结果,每项任务独立跑三次:
| 设置(MemT-1.0-Nano) | Verified 平均成功率 % | Verified 三次全成功 % | Multilingual 平均成功率 % |
|---|---|---|---|
| 无经验基线 | 66.07 | 54.00 | 60.00 |
| 文本经验 | 69.13 | 61.80 | 63.00 |
| 原生记忆 | 69.73 | 62.80 | 63.56 |
局限:报道自己说,原生记忆的表现「和显式文本经验接近」。按表中数据,平均成功率只比文本经验高 0.6 个百分点(Multilingual 高 0.56),三次全成功比例高 1.0 个百分点。要精确删除、解释或恢复某条记忆,还需要另外的机制。
来源:量子位
11/11
工信部正在起草新一代智能制造政策,列出四方面重点
工信部在国新办发布会上表示,正在研究新一代智能制造的政策措施,推动 AI 和制造业融合。
据央视新闻,10 月 20 日国新办发布会介绍了四方面重点:一是分梯度培育基础级、先进级、卓越级、领航级智能工厂;二是研发智能工业母机、机器人、检测与控制装备;三是建设工业数据集,开发垂域大模型和工业专用模型,实施「模数共振行动」,稳妥开展工业智能体的研发与验证;四是依托金砖等机制开展国际合作。
局限:政策还在起草阶段,没有公布文件全文、实施时间和资金安排。
来源:钛媒体
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片