概览
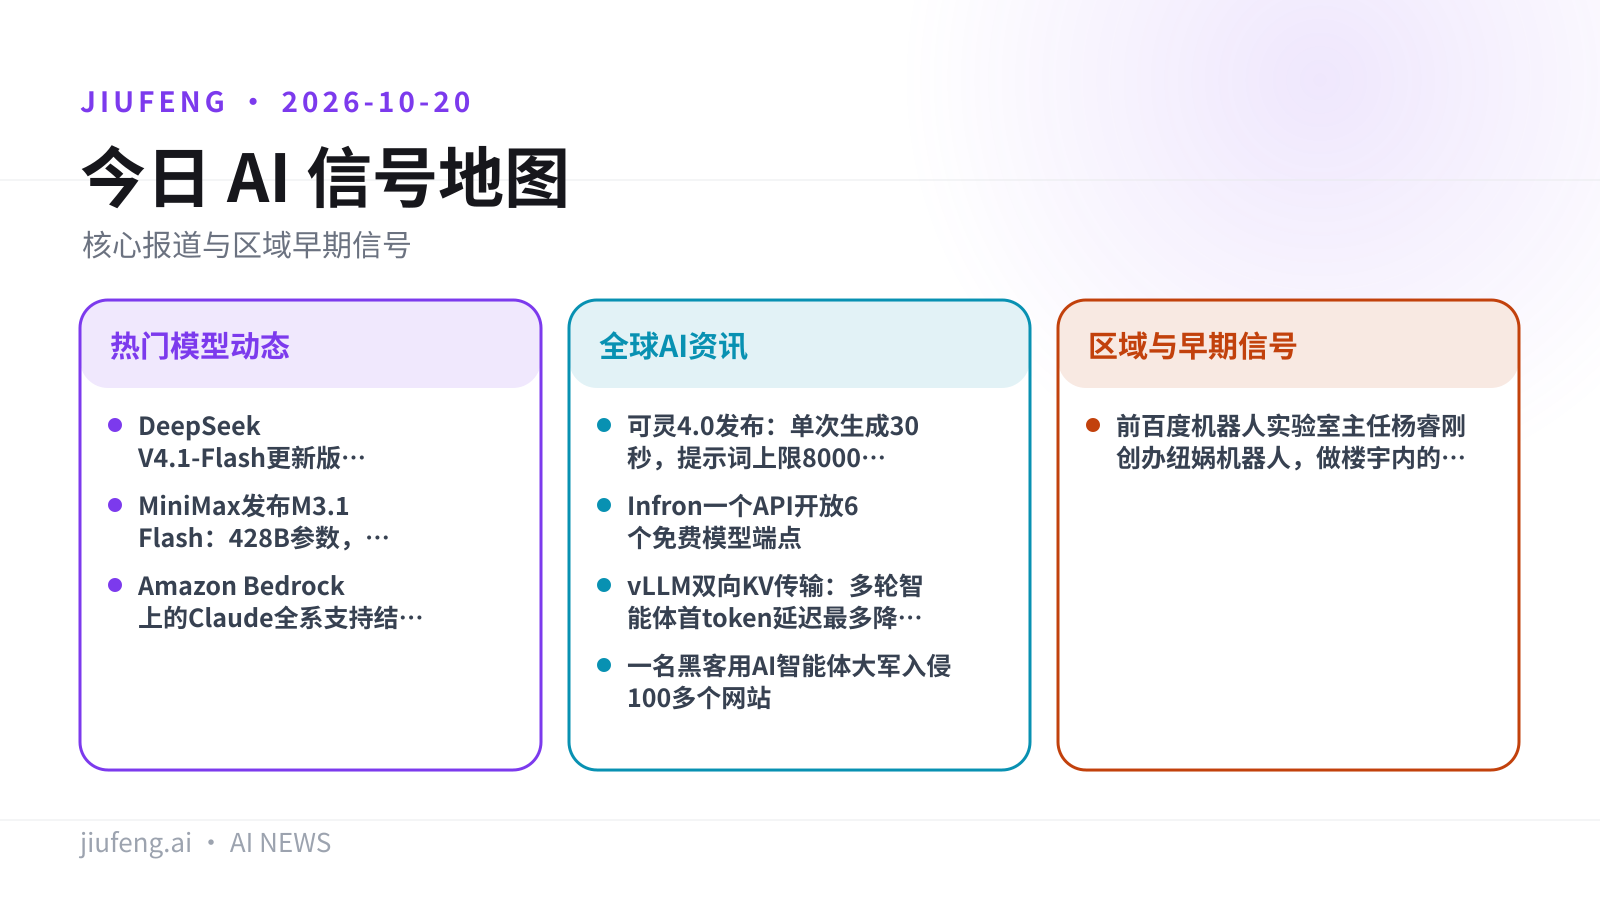
本期共 10 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · DeepSeek V4.1-Flash 更新版登顶 Arena 智能体榜开源第一
- 重点 · MiniMax 发布 M3.1 Flash:428B 参数,智能指数 42 分
- 重点 · Amazon Bedrock 上的 Claude 全系支持结构化输出
全球 AI 资讯
- 可灵 4.0 发布:单次生成 30 秒,提示词上限 8000 token
- Infron 一个 API 开放 6 个免费模型端点
- vLLM 双向 KV 传输:多轮智能体首 token 延迟最多降 3.3 倍
- 一名黑客用 AI 智能体大军入侵 100 多个网站
- Aleksander Madry 回到 OpenAI,转做 AI 安全
- 有人用 AI 编码智能体给智能电视「瘦身」
区域与早期信号
- 前百度机器人实验室主任杨睿刚创办纽娲机器人,做楼宇内的末端配送
九凤根据本期已引用来源整理。
热门模型动态
01/10
DeepSeek V4.1-Flash 更新版登顶 Arena 智能体榜开源第一
10 月 17 日更新的 V4.1-Flash 在 Arena 智能体榜的开源模型中排第 1、总榜排第 11,每个任务的中位成本是 0.2 美元。
Arena.ai 在 X 上公布了 10 月 19 日的 Agent Arena 排行快照。DeepSeek 10 月 17 日更新的 V4.1-Flash 在开源模型中排第一,在所有模型中排第 11。
- 统计样本:7,498 次智能体会话
- 净改进得分:5.13%
- 中位成本:每任务 0.20 美元
- 权重:V4.1-Flash-1017 已在 Hugging Face 公开
局限:这只是 Arena 某个时间点的快照,排名会随会话量变化。总榜第 11 说明它和闭源前沿模型之间还有差距。每任务成本是 Arena 统计的中位数,放到不同工作流里成本会不一样。
图片来源:huggingface;已转存至九凤 R2。
来源:RuntimeWire · Arena(X) · Hugging Face
02/10
MiniMax 发布 M3.1 Flash:428B 参数,智能指数 42 分
MiniMax 推出 M3 的提速降价版 M3.1 Flash,Artificial Analysis 智能指数比 M3 高 13 分,官方称智能体任务成本降低 70%。
M3.1 Flash 是 MiniMax 6 月发布的 M3 的更新版,目前处于预览阶段。
- 参数:开发者指南写的是总参数 428B,和 M3 基本持平;官方称提速来自推理时更激进的稀疏化
- 上下文与输入:最长 100 万 token,支持文本、图像和视频输入
- 推理档位:每次请求都会开启推理,从 Low 到 Max 共五档
- 速度与成本:官方称推理速度接近 M3 的 3 倍,日常高峰期输出超过 200 tok/s,智能体任务成本降低 70%
- 评测:OSWorld V2 61.7(MiniMax 自测),DeepSWE v1.1 73.7%,Humanity's Last Exam 48%
The Decoder 引用的 Artificial Analysis 数据(DeepSeek 一行指 V4.1 Flash 1017):
| 模型 | AA 智能指数 | CritPt(%) | AA-Omniscience 正确率(%) |
|---|---|---|---|
| MiniMax M3.1 Flash | 42 | 22 | 56 |
| DeepSeek V4.1 Flash | 45 | 24 | 43 |
| GLM-5.3-Flash | 42 | 15 | 28 |
| Gemini 3.8 Flash | 41 | 18 | — |
局限:OSWorld V2 分数是 MiniMax 自己测的。两个来源给出的成本降幅口径不同:官方说智能体任务便宜 70%,The Decoder 说每任务成本不到 M3 的一半。The Decoder 提到 M3.1 Flash 会开放权重,但目前还没有发布。
来源:SiliconANGLE · The Decoder
03/10
Amazon Bedrock 上的 Claude 全系支持结构化输出
在 Bedrock 上调用任何一个 Claude 模型,现在都可以要求它返回符合指定 JSON schema 的结果,不用再自己写解析和重试逻辑。
AWS 宣布,Bedrock 上的全部 Anthropic Claude 模型都支持结构化输出,bedrock-runtime 和 bedrock-mantle 两个端点都能用。无论是用 Boto3 调 bedrock-runtime API,还是用 Messages API 调 bedrock-mantle,都能拿到符合 schema 的 JSON。
这项功能基于约束解码实现。AWS 举的用例包括:从财报和合规文件中抽取字段、把临床记录解析进电子病历(EHR)、分析合同条款、给工单分流。GitHub 上有配套的示例 notebook。
局限:只能在对应 Claude 模型已上线的区域使用。公告摘录里没有给出延迟和成本数据,也没有说明 schema 的复杂度上限。
来源:AWS Machine Learning Blog · 示例 notebook(GitHub)
全球 AI 资讯
04/10
可灵 4.0 发布:单次生成 30 秒,提示词上限 8000 token
Kling AI 发布视频生成模型 4.0 版,新增立体声音频和多语言口型同步,同时推出更轻量的 Flash 版。
- 时长:单次最长生成 30 秒视频
- 关键帧:最多输入 10 张关键帧图像,用来控制转场、角色状态和情节节点
- 提示词:理解上限扩展到 8,000 token
- Omni Reference:单次生成最多使用 15 个参考素材,其中图片最多 10 张、视频最多 5 段(总长不超过 30 秒)、元素最多 7 个;分镜、线框图、白模视频和深度图视频都能作参考
新增的 Creative Recreation 功能可以把已有视频当模板,替换其中的产品或角色,也可以单独调整表情、动作、机位和背景。
局限:以上能力都来自 Kling AI 的说法。Flash 版更快、更便宜,但最高只支持 720p 和 20 秒视频。报道摘录里没有给出价格。
来源:The Decoder
05/10
Infron 一个 API 开放 6 个免费模型端点
AI 网关 Infron 把 DeepSeek V4.1 Flash、两个 Qwen3.8 27B 变体等 6 个端点的输入和输出单价都降到了 0 美元。
Infron 是 Yue Xu 联合创办的 AI 网关。它在 10 月 19 日发帖说,以下 6 个端点可以通过同一个 API 免费调用:DeepSeek V4.1 Flash、两个 Qwen3.8 27B 变体、Apodex 1.1 Mini、Ling 3.1 Flash 和 Atria: Dawn Preview。
局限:标准免费档要求账户余额至少 5 美元,所有免费端点共用每天 1,000 次的请求上限,而且不提供 SLA。更适合做实验,不适合直接用于生产。
来源:RuntimeWire · Infron(X)
06/10
vLLM 双向 KV 传输:多轮智能体首 token 延迟最多降 3.3 倍
AWS 介绍了 vLLM 预填充/解码分离部署中的双向 KV 缓存传输,下一轮对话可以复用上一轮已经算好的内容。
在预填充/解码(P-D)分离部署中,KV 缓存通常只从 prefill 节点单向传到 decode 节点。多轮对话里这会造成两种浪费:上一轮回复里生成的 token,prefill 节点拿不到对应的 KV 缓存,只能重新计算;会话状态也一直留在 decode 节点上。
双向传输让 prefill 节点能从 decode 节点取回 KV 块。vLLM 已经在 connector 层面支持双向 KV 传输,GitHub 上有一个多轮场景的示例代理 disagg_proxy_multiturn.py。AWS 在 P5en 实例上用 1P1D 部署测得的首 token 延迟(TTFT)降幅如下:
| 模型 | TTFT 最多降低(倍) |
|---|---|
| Qwen3-32B | 1.6 |
| zai-org/GLM-5-FP8 | 3.3 |
局限:表中是 AWS 在单一部署配置下测得的最大降幅。要在多轮对话之间协调 KV 复用,还需要一个能感知 KV 缓存的路由器,GitHub 上提供的是示例代理。
来源:AWS Machine Learning Blog · vLLM 文档 · 示例代理(GitHub)
07/10
一名黑客用 AI 智能体大军入侵 100 多个网站
安全公司 Norforge 披露,一名黑客用基本自主运行的 AI 智能体攻破了 100 多个网站,人工介入很少。
Norforge 是从开源项目 Cairn 中暴露出来的工作记录里发现这起攻击的。Norforge 没有公布受害方,但路透社报道称其中包括 John Deere、SharkNinja 和 Cummins。
局限:受害企业名单来自路透社,Norforge 本身没有点名。报道摘录没有披露攻击用了哪些模型,也没有说造成了多大损失。
来源:The Verge
08/10
Aleksander Madry 回到 OpenAI,转做 AI 安全
前 OpenAI Preparedness 团队负责人 Madry 离开几个月后回归,将和首席科学家 Jakub Pachocki 一起研究高能力 AI 的安全风险。
Madry 10 月 19 日在 X 上发帖说,之前的离职最后变成了一段休假。他的看法也变了:AI 能力越来越强,眼下更需要在安全方向投入。回到 OpenAI 后,他会和 Pachocki 合作研究高能力 AI 的安全与安防风险。
局限:帖子和报道摘录都没有说明他的具体职位、团队规模或研究计划。
来源:RuntimeWire · Aleksander Madry(X)
09/10
有人用 AI 编码智能体给智能电视「瘦身」
有开发者用 vibe coding 改造智能电视:去掉系统广告、关掉观看追踪、给启动器提速,开源项目 dumbtv 就是其中之一。
TechCrunch 报道,有开发者在分享用 AI 编码智能体改造电视的方案,包括去掉系统推送的广告、加快应用启动器、重新设计主屏幕、关闭追踪功能。dumbtv 在 GitHub 页面上写明了它的目标:电视只该做你花钱买的那些事——你的应用、你的 HDMI 输入,此外什么都不要。不要电视自带的广告,不要观看追踪,不要你没要求过的更新。
dumbtv 不替换电视系统,也不解锁 bootloader。按项目页面的说明,它适用于 Fire OS 和 Android TV / Google TV 设备(包括 Sony、TCL、Philips、Hisense、Xiaomi 和 Shield)。
局限:项目页面写明 Samsung、LG、Roku 等品牌目前没有可行路径。端到端实测过的只有一款 Fire TV Edition 电视(Fire OS 7.7.1.7)。
来源:TechCrunch · dumbtv(GitHub)
区域与早期信号
10/10
前百度机器人实验室主任杨睿刚创办纽娲机器人,做楼宇内的末端配送
2026 年初成立的纽娲机器人想让配送机器人自己进小区、进单元楼、坐电梯,把东西送到住户门口,部署时不需要提前测绘建图。
创始人杨睿刚是上海交通大学特聘教授、IEEE 会士,曾在美国肯塔基大学任教 17 年,后来加入百度,担任机器人与自动驾驶实验室主任。钛媒体援引公开资料称,全国物流无人车保有量超过 3.5 万台,200 多个城市开放了路权,中通的无人车队每天运送 20 多万件包裹。但从进小区、上电梯到送到门口这一段,现在还是靠人。
- 自营试点:8 月 1 日在浙江桐庐开设了自营的人机混合驿站
- 海外 PoC:和阿联酋 K2 合作的 PoC 已经落地阿布扎比的一栋高层公寓
- 合作规模:K2 现有几千台无人车,计划每台车至少配两个机器人;另有俄罗斯客户准备买回去测试
- 年内规划:公司计划年底前在三个点位跑 PoC(不含桐庐)
局限:这是一篇创始人访谈,「不建图、不改造楼宇」是公司自己定的目标。海外合作目前还在 PoC 阶段。眼下只有中文来源。
来源:钛媒体
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片