概览
本期共 10 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · GPT-6.1 Sol 迁移 COBOL 测试准确率最高 97.9%
- 重点 · 美国国土安全部禁止联邦民事机构使用 DeepSeek
- 重点 · Unsloth 把 DeepSeek V4.1-Flash-1017 压到 250GB
- Mercury 3 扩散语言模型达到 1068 tok/s,自测 12 项中 8 项领先 Haiku 5.5
全球 AI 资讯
- PyTorch 2.15 的 MPS 后端支持 FP8,Mac 上解码更快
- SageMaker Studio 新用户可用 GitHub 账号直接登录
区域与早期信号
- 小米 MiMo-V2.6-Pro 上线 WorkBuddy
- Claude 与 Gemini Carbon 新模型内测反馈曝光
- 北大与启元机器人推出 HIL-UMI,后训练纠错不再依赖真机
- 无锡 Stars Micro System 发布 PCIe 6.0 交换芯片 C82-4G
热门模型动态
01/10
GPT-6.1 Sol 迁移 COBOL 测试准确率最高 97.9%
OpenAI 发布一组面向 COBOL、Fortran、Visual Basic 等老语言的编程评测,新模型在自家测试上大幅领先上一代。
OpenAI 10 月 19 日在 X 上公布这项更新,定位是能力更新,没有推出单独产品;技术说明称开发者可通过 OpenAI API 用这些模型做编程任务。量子位转引的数据称,COBOL 支撑着超过 40% 的银行系统、80% 的线下刷卡交易和 95% 的 ATM 交易。
| 模型与推理档位 | COBOL 迁移准确率(%) |
|---|---|
| GPT-6.1 Sol(low) | 86.6 |
| GPT-6.1 Sol(更高档位) | 97.9 |
| GPT-5.6 Sol | 5.4 |
另据 RuntimeWire,在「用老语言实现 SQLite」的评测中,GPT-6 Astra 通过了 72.1% 的 COBOL 测试。
局限:迁移结果用的是 OpenAI 自己设计的隐藏测试,属于自评。RuntimeWire 指出,这些结果只说明模型在 OpenAI 自家评测上有进步,生产环境中的安全性和企业采用情况都还没有答案。
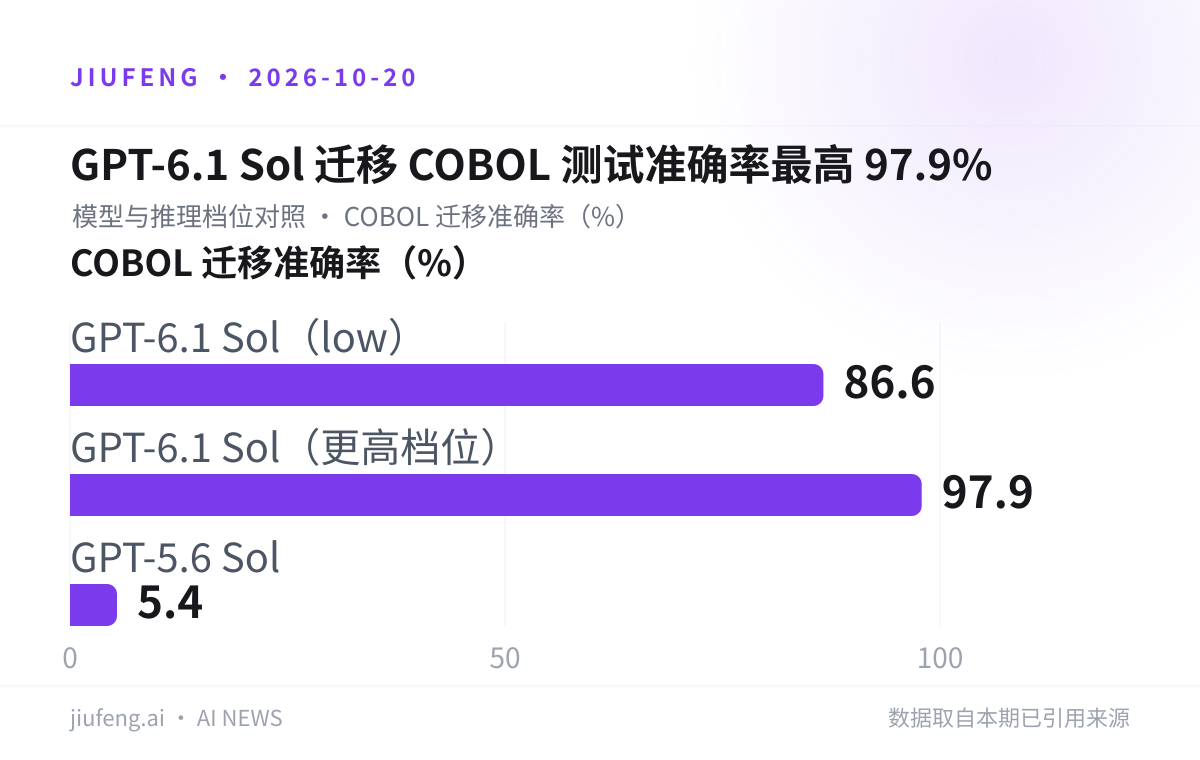
九凤根据本期已引用来源整理。
来源:OpenAI · RuntimeWire · 量子位
02/10
美国国土安全部禁止联邦民事机构使用 DeepSeek
美国联邦民事机构必须移除现有 DeepSeek 产品、不得再采购,禁令也覆盖基于 DeepSeek 构建的第三方服务。
据 The Decoder 援引《华尔街日报》报道,美国国土安全部(DHS)下令禁止联邦民事机构使用 DeepSeek 的 AI 技术。范围包括其关联公司的产品,以及基于 DeepSeek 实现构建的第三方服务。命令的依据是 2018 年一部涉及联邦采购供应链安全的美国法律。
据《纽约时报》此前报道,美国政府今年夏天曾考虑针对中国开放权重模型采取行动,选项包括制裁、贸易黑名单,以及规定联邦机构可以使用哪些模型。
局限:通知没有设定移除期限,也没有说明具体的安全担忧。「基于 DeepSeek 构建」怎么界定、OpenRouter 这类 AI 网关是否在禁令范围内,目前都不清楚。
来源:The Decoder
03/10
Unsloth 把 DeepSeek V4.1-Flash-1017 压到 250GB
Unsloth 发布 DeepSeek 552B 模型的 1-bit GGUF 版本,内存 128GB 以上的机器可以本地运行。
Unsloth AI 10 月 19 日发布 DeepSeek V4.1-Flash-1017 的 GGUF 量化版本。
- 最小版本:1-bit,下载体积 250.4GB
- 8-bit 版本:508.4GB
- 内存要求:至少 128GB
- 88.2%:Unsloth 公布的一致性指标
局限:88.2% 衡量的是在单一测试集上与原模型的 token 一致率,不是通用基准准确率。250GB 的下载量加上 128GB 以上的内存要求,意味着本地运行仍只适合高端机器。
来源:RuntimeWire · Unsloth(X)
04/10
Mercury 3 扩散语言模型达到 1068 tok/s,自测 12 项中 8 项领先 Haiku 5.5
Inception 的新一代扩散模型并行生成答案,主打速度,在自家对比表中多数项目领先 GPT-6 Luna 和 Claude Haiku 5.5。
Mercury 3 不逐个 token 生成,而是并行写出答案。
- 速度:Inception 称在 NVIDIA GPU 上达到每秒 1068 个 token(未披露具体 GPU 型号)
- 上下文:100 万 token
- 规模:参数量未披露,官方称是 Mercury 1 的 40 倍以上
- 评测:12 项基准中 8 项领先 GPT-6 Luna 和 Claude Haiku 5.5(medium 设置);SWE-Bench Atlas 得 51.08,领先两者约 18 分
| 模型 | DeepSWE v1 |
|---|---|
| Claude Haiku 5.5 | 51.62 |
| Mercury 3 | 46.31 |
局限:所有分数都由 Inception 自行报告。模型只通过 API 提供,不开放权重,也没有量化版本;DeepSWE v1 是它表现最差的一项,落后 Haiku 5.5 5.31 分。
来源:MarkTechPost
全球 AI 资讯
05/10
PyTorch 2.15 的 MPS 后端支持 FP8,Mac 上解码更快
Hugging Face 的 PyTorch 团队介绍 2.15 版 MPS 后端的改进:新增 FP8,语言模型解码走更快的路径。
在 PyTorch 2.15 中,FP8 开始支持 MPS。语言模型解码时,线性层和 softmax 有了更快的执行路径;新的 Metal 内核用来处理音频、视频和训练负载中开销意外偏高的部分。
团队的做法是在 MPS 上跑 Hugging Face Hub 的语言、图像和视频模型,找出短板后提交到 PyTorch 上游,越来越多地用专用 Metal 内核替代 MPSGraph。
局限:改进只针对 Mac 上的 MPS 后端。博客写到,2026 年初在 MPS 上跑小模型仍常遇到算子不支持、性能断崖和内存异常增长等问题;各类负载的实际提速幅度,要看具体模型和算子。
图片来源:huggingface;已转存至九凤 R2。
来源:Hugging Face Blog · GitHub
06/10
SageMaker Studio 新用户可用 GitHub 账号直接登录
AWS 简化 SageMaker AI 新用户的开通流程:注册后几步就能进入已配置好的 Studio 环境。
新用户可以用已有的 Amazon、Apple、GitHub、Google 账号或邮箱登录。不需要先建完整的 AWS 账户,多数用户也不用绑信用卡。AWS Free Tier 额度最多 200 美元:新用户先获 100 美元,另有机会再赚 100 美元,可用于模型定制、训练任务、Studio notebook 和端点部署。
AWS 还提到,今年早些时候 Studio 环境的创建时间已从 2 分钟缩到约 20 秒,并且可以从 Hugging Face 模型页一键跳转到 Studio。
局限:新流程只面向新客户。「免信用卡」只适用于多数用户,不是全部。
区域与早期信号
07/10
小米 MiMo-V2.6-Pro 上线 WorkBuddy
小米称 AA 智能指数开源第一的 MiMo-V2.6-Pro,今天接入了 WorkBuddy。
小米技术官方 10 月 20 日宣布,MiMo-V2.6-Pro 正式上线 WorkBuddy,支持 1M 上下文、多智能体分工协作,以及图像、视频、音频、文本的全模态联合理解。9 月 22 日发布时公布的 Artificial Analysis 智能指数 v4.3.2 成绩如下:
| 模型 | AA 智能指数 |
|---|---|
| Claude Fable 5.1 | 53 |
| GPT-6 Astra | 53 |
| MiMo-V2.6-Pro | 46 |
| GLM-5.3 | 45 |
| Kimi K3 | 44 |
| MiMo-V2.5-Pro | 26 |
另据小米公布的数据,Pro 版在 DeepSWE v1.1 上从 48.8 升到 65.7;RL 训练历时不到 6 天,成本约 262 万美元。
局限:上线消息没有说明 WorkBuddy 中的计费和可用范围;评测数据来自 9 月发布时小米自己的说明。小米也承认,与顶级闭源模型相比仍有差距。
来源:IT之家
08/10
Claude 与 Gemini Carbon 新模型内测反馈曝光
据社交平台转述,Anthropic 和 Google 都在内测新模型。
量子位汇总 X 上的说法:新版 Claude 在推理和直觉上更好,修 bug 时会找出导致它的那一类根本问题,并询问是否一并修复。Google 测试了代号 Argon、Barium、Carbon 的一系列 Gemini 4 模型,其中 Carbon 在内部编程平台 Jetski 上向员工开放了数日。员工反馈它编程强于 Argon,「感觉与 Opus 5.5 相当」。
局限:信息来自匿名内测用户在 X 上的转述,报道未提及官方表态,也没有任何基准分数;报道中的员工自己也说,Carbon「还需要更多测试」。本条为中文媒体单源。
来源:量子位
09/10
北大与启元机器人推出 HIL-UMI,后训练纠错不再依赖真机
董豪团队把具身后训练中关键的人工纠错环节,搬到了无本体采集设备上。
据雷锋网报道,传统的 HG-DAgger 需要机械臂实际运行、操作员在旁盯守,快出错时再接管纠正,又贵又慢。HIL-UMI 针对这一点,在不依赖机器人本体的前提下完成后训练里的「纠错」环节。
局限:本条仅依据中文媒体单源报道,成功率等量化结果未经本站核实;报道称「国内外还没有团队做出可行方案」,这是报道方的判断。
来源:雷锋网
10/10
无锡 Stars Micro System 发布 PCIe 6.0 交换芯片 C82-4G
无锡厂商发布自称国内首款的 PCIe 6.0 交换芯片,同时推出 800G AI 网卡和多模 RAID 芯片。
据 Pandaily 报道,Stars Micro System 发布的 C82-4G 最多支持 144 条通道,速率 64 GT/s。同场还发布了 800G 多协议 AI 网卡和多模 RAID 芯片。
局限:「国内首款」是厂商自己的说法。报道没有给出第三方测试、价格或量产时间。
来源:Pandaily
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片