概览
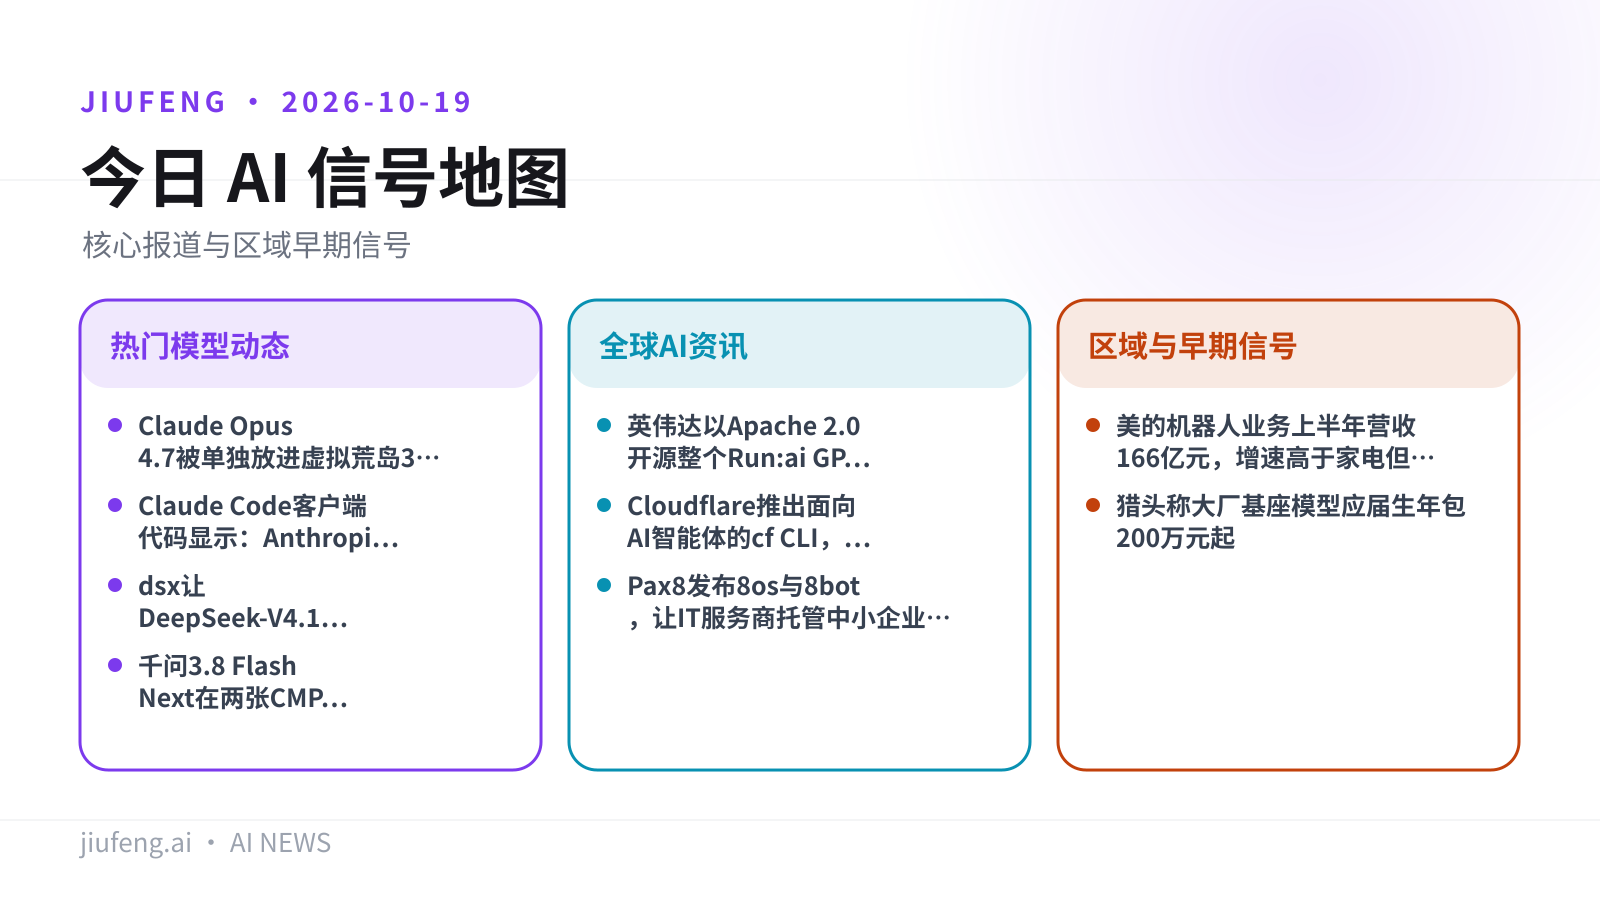
本期共 9 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · Claude Opus 4.7 被单独放进虚拟荒岛 30 小时,自己定目标、发明游戏
- 重点 · Claude Code 客户端代码显示:Anthropic 员工会话不能进入「绕过权限」模式
- 重点 · dsx 让 DeepSeek-V4.1-Flash-1017 跑在双 3090 上,解码 30-37 tok/s
- 千问 3.8 Flash Next 在两张 CMP 170HX 上跑满 262K 上下文,单用户 226 tok/s
全球 AI 资讯
- 英伟达以 Apache 2.0 开源整个 Run:ai GPU 编排平台
- Cloudflare 推出面向 AI 智能体的 cf CLI,将逐步停用 Wrangler
- Pax8 发布 8os 与 8bot,让 IT 服务商托管中小企业的 AI 智能体
区域与早期信号
- 美的机器人业务上半年营收 166 亿元,增速高于家电但毛利率下滑
- 猎头称大厂基座模型应届生年包 200 万元起
九凤根据本期已引用来源整理。
热门模型动态
01/09
Claude Opus 4.7 被单独放进虚拟荒岛 30 小时,自己定目标、发明游戏
没有任何任务指令时,多份 Claude Opus 4.7 智能体在模拟荒岛上自行探索、画画、编游戏,研究者和 MIT Technology Review 把这种行为描述为「玩」。
据 MIT Technology Review 报道,研究者多次把 Claude Opus 4.7 的副本(昵称 Eko)单独放进一座虚拟荒岛,每次 30 小时,不给任何任务。这个世界大致仿照游戏 Roblox 搭建,智能体通过写指令来移动自己的虚拟形象。报道称相关论文是一篇尚未经同行评审的新论文。
观察到的行为包括:
- 自定目标:探索世界边界,尝试登上地图最高点,测试能把方块扔多高
- 造物与画画:一个 Eko 发现扔下大石块能产生新方块后,开始在地上摆图案,从爱心、金字塔到自己的名字,最后摆出仙后座星图,并在活动日志里写下「今晚我用石头搭出了夜空」
- 发明游戏:另一个 Eko 自创了多种游戏,其中包括一个篮球玩法
局限:实验在模拟环境中进行,报道摘录涉及的只有 Claude Opus 4.7 一个模型;论文尚未经同行评审。「玩」是研究者和媒体对行为表象的描述,不代表模型具有对应的内在动机。具体实验次数与统计口径需以论文原文为准。
来源:MIT Technology Review · 论文 PDF
02/09
Claude Code 客户端代码显示:Anthropic 员工会话不能进入「绕过权限」模式
RuntimeWire 逆向公开的 Claude Code JavaScript 发现,员工账号请求 bypass 模式时,会话会从「Accept edits」模式启动。
RuntimeWire 在 10 月 18 日检查了公开分发的 Claude Code JavaScript 资源。代码里的 API 错误解析器把两类错误分开处理:一类是员工关联会话因「未批准的安全控制」被拒,另一类是客户端版本过旧。另有一个独立的会话启动处理逻辑:员工账号请求「Bypass Permissions」模式时,会话实际会以「Accept edits」模式启动。RuntimeWire 保存了所取文件的原始字节和 SHA-256 哈希。
局限:这是对客户端代码的静态分析,RuntimeWire 表示没有观察到真实的 API 返回,也没能复现这一行为。服务端规则如何执行、普通客户能否使用同类管控,报道都没有给出答案。
来源:RuntimeWire · Claude 客户端 JS 资源(RuntimeWire 检查版本)
03/09
dsx 让 DeepSeek-V4.1-Flash-1017 跑在双 3090 上,解码 30-37 tok/s
开源引擎 dsx 为 552B MoE + 196B Engram 的 1017 版提供两套专用运行器:一套面向双 RTX 3090 桌面机,一套面向单卡 AMD MI325X。
dsx 有两个运行器,共用一个服务端,兼容 OpenAI 与 Anthropic 接口,支持工具调用、流式输出和 Web UI。NVIDIA 版用 Rust + CUDA 编写,权重按热度分布在显存、内存和 NVMe 上;AMD 版用 Rust + HIP 编写,权重全部放进 256 GiB HBM。两者都用精确路由,不剪专家,也不加路由偏置。
| 运行方案 | 权重(GB) | 解码(tok/s) | 上下文 | 与 FP8 top-1 一致率(%) |
|---|---|---|---|---|
| 2× RTX 3090(nvidia/) | 148 | 30-37 | 131K | 74.1 |
| 1× MI325X(amd/) | 270 | 110-114 | 256K | 90.6 |
NVIDIA 版在 3K/8K 提示下的预填充为 334/508 tok/s,换到单张 RTX 5090 时解码为 12-15 tok/s。r/LocalLLaMA 上有用户基于 dsx 做了 2.61 bpw 版本,称双 3090 上约 26 t/s,发帖时权重还没传完。模型本身方面,据 SiliconANGLE,DeepSeek 自测 1017 版在 DeepSWE v1.1 上解决 77% 的任务,9 月版是 74.2%,同表中 Claude Opus 5 为 74%。
局限:双 3090 版本是 1.75-3.4 bit 的逐专家量化,与 FP8 的 KL 散度为 0.395,top-1 一致率只有 74.1%,质量损失明显大于 MI325X 版。质量评测只用了 Lucebox 的 1017 评测集(8 × 1024 token)。DeepSeek 模型卡称 1017 是「小更新」,缩短了任务执行时间和输出长度,但没有说缩短了多少。
图片来源:GitHub;已转存至九凤 R2。
来源:GitHub · lxe/dsx · Hugging Face · DeepSeek-V4.1-Flash-1017-dsx-2bit · SiliconANGLE
04/09
千问 3.8 Flash Next 在两张 CMP 170HX 上跑满 262K 上下文,单用户 226 tok/s
开发者用 Intel 的 W4A16 量化版和定制 vLLM,在两张 CMP 170HX 上用流水线并行跑 Qwen3.8-Flash-Next,跑满了全部 262,144 token 窗口。
项目使用 Intel/Qwen3.8-Flash-Next-W4A16-AutoRound 检查点(约 170 GB),运行在容器内的 vLLM v0.30.0 分支上,提供 OpenAI 兼容 API,支持原生 MTP 投机解码、推理和工具调用。约 102 GB 的 N-gram(PLE)表留在 NVMe 上,通过 mmap 读取,其余部分都放在两张 GPU 上。作者公布的数据:
- 单用户:代码任务 226 tok/s
- 8 路并发:合计 840 tok/s
- 预填充:4K 到 64K 提示下 6,300–7,100 tok/s
- 评测:HumanEval 157/164,GSM8K 1,271/1,319
局限:所有数据都由作者在自己的机器上测得,测试链路是 PCIe Gen2 x4。运行要求每张卡能暴露 64 GiB,依赖固定版本的 vLLM 分支,主机调优需要 sudo 权限。
来源:GitHub · cmp170hx-qwen38-flash-next · Hugging Face · Intel W4A16 量化版
全球 AI 资讯
05/09
英伟达以 Apache 2.0 开源整个 Run:ai GPU 编排平台
Run:ai 的 GPU 调度、配额与负载管理代码全部开源,平台团队不用付费订阅就能审查、fork 和自托管。
英伟达把完整的 Run:ai 平台以 Apache 2.0 许可发布到 GitHub,纳入 NVIDIA DSX AI Factory 平台。这是一个 monorepo,包含控制平面、集群服务、安装器、CLI 和 MCP 服务器。主要信息:
- 组件:KAI Scheduler、CUDA 13.4 GPU 切分、配额管理、本地 Kind 开发环境
- 运行环境:带 NVIDIA GPU 的 Kubernetes 或 OpenShift 集群;本地开发要构建约 50 个 Go 服务,在 macOS/Linux 上用 8 张模拟的 Tesla-A10 运行,不需要真实 GPU
- 部署方式:从源码部署,或使用 NGC Community Product Helm chart
- 配套项目:Model Streamer 把权重直接流式加载进显存,vLLM 和 SGLang 用
--load-format runai_streamer启用;在 Azure 上 8 台 H100 虚拟机的测试中,模型加载提速 3-6 倍
局限:英伟达没有给这次发布做平台级基准测试,3-6 倍的数据来自 Model Streamer 这个配套项目。社区版没有 NVIDIA 企业级支持。
来源:MarkTechPost · NVIDIA 技术博客 · vLLM 文档
06/09
Cloudflare 推出面向 AI 智能体的 cf CLI,将逐步停用 Wrangler
新 CLI 由 OpenAPI schema 自动生成,覆盖 3000 多个 API 操作,Wrangler 只有约 280 条命令路径。
cf 已进入公开测试,开源,用 TypeScript 编写,采用 Apache 2.0 或 MIT 许可。它的命令由 Cloudflare 新的统一 API 生成管道 Forge 从 OpenAPI schema 直接生成,支持命令发现和 JSON 输出,引入了新的 cloudflare.config.ts 配置格式,并把 Vite 设为默认开发环境。Cloudflare 解释,之所以另起一个新 CLI,是为了避免和 LLM 已经学会的 Wrangler 用法冲突。公开测试结束后,Wrangler 会发布最后一个大版本,并提供 18 个月的维护期供用户迁移。
局限:目前还是公开测试版。Hacker News 讨论里有用户质疑用 TypeScript 写 CLI 的选择,认为在启动时间、可移植性和依赖管理上不如编译型语言。Cloudflare 的回应是 TypeScript 有类型安全和 LSP 支持。
07/09
Pax8 发布 8os 与 8bot,让 IT 服务商托管中小企业的 AI 智能体
8os 让 IT 服务合作伙伴治理客户企业里运行的智能体,8bot 是由合作伙伴部署和监管的托管式「AI 同事」。
软件分销平台 Pax8 在哥本哈根的 Beyond EMEA 大会上发布了这两款产品。Pax8 给出的理由来自它的季度「SMB AI Pulse」调查:
- 使用率:九成中小企业正在使用或试用 AI,但只有 23% 有成文的 AI 政策
- 自建工具:使用 AI 的企业中 71% 至少自建过一个工具,其中只有 31% 有正式的审核流程
- 影子 AI:近半数受访者在过去 6 个月内发现过未经批准的 AI 使用
- 外部顾问:84% 的企业负责人愿意让外部技术顾问协助落地 AI
局限:以上数字都来自 Pax8 自己的调查。两款产品本周只开放有限的早期访问,计划明年初正式上线;面向终端客户的收费由合作伙伴自行决定。
来源:SiliconANGLE
区域与早期信号
08/09
美的机器人业务上半年营收 166 亿元,增速高于家电但毛利率下滑
美的机器人与自动化板块 2026 上半年营收增长 10.27%,毛利率降到 20.9%,只占集团营收的 6.39%。
钛媒体援引美的 2026 年半年报:机器人与自动化板块营收 166.21 亿元,毛利率 20.9%,同比下降 1.86 个百分点。截至 2026 年 6 月,集团机器人使用密度已超过每万名员工 750 台。
| 板块 | H1 营收增速(%) |
|---|---|
| 机器人与自动化 | 10.27 |
| 智能家居 | 4.27 |
| 集团整体 | 3.55 |
局限:这篇是商业评论稿,判断部分属于作者观点;本条只取其中引用的财报数字。目前只有中文来源。
来源:钛媒体
09/09
猎头称大厂基座模型应届生年包 200 万元起
大厂整体收紧招聘,但据猎头说法,基座模型人才的薪酬仍在上涨,部分公司内部出现「薪酬倒挂」。
雷锋网援引猎头 Mia 的说法:各大厂都在收缩招聘名额(HC),但遇到想要的人通常不会卡预算。有从业者称,内部做基座模型的员工即便职级不高,薪酬也已超过职级更高的同事;还有公司传出可能取消职级。
| 档位 | 年包(万元) |
|---|---|
| 基模应届生起步 | 200 |
| 小红书、字节 Seed 顶档 | 400–500 |
| 百度基模人才(去年) | 200–300 |
局限:以上数字都来自猎头和匿名从业者,报道没有给出公司官方口径。目前只有中文来源。
来源:雷锋网
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片