概览
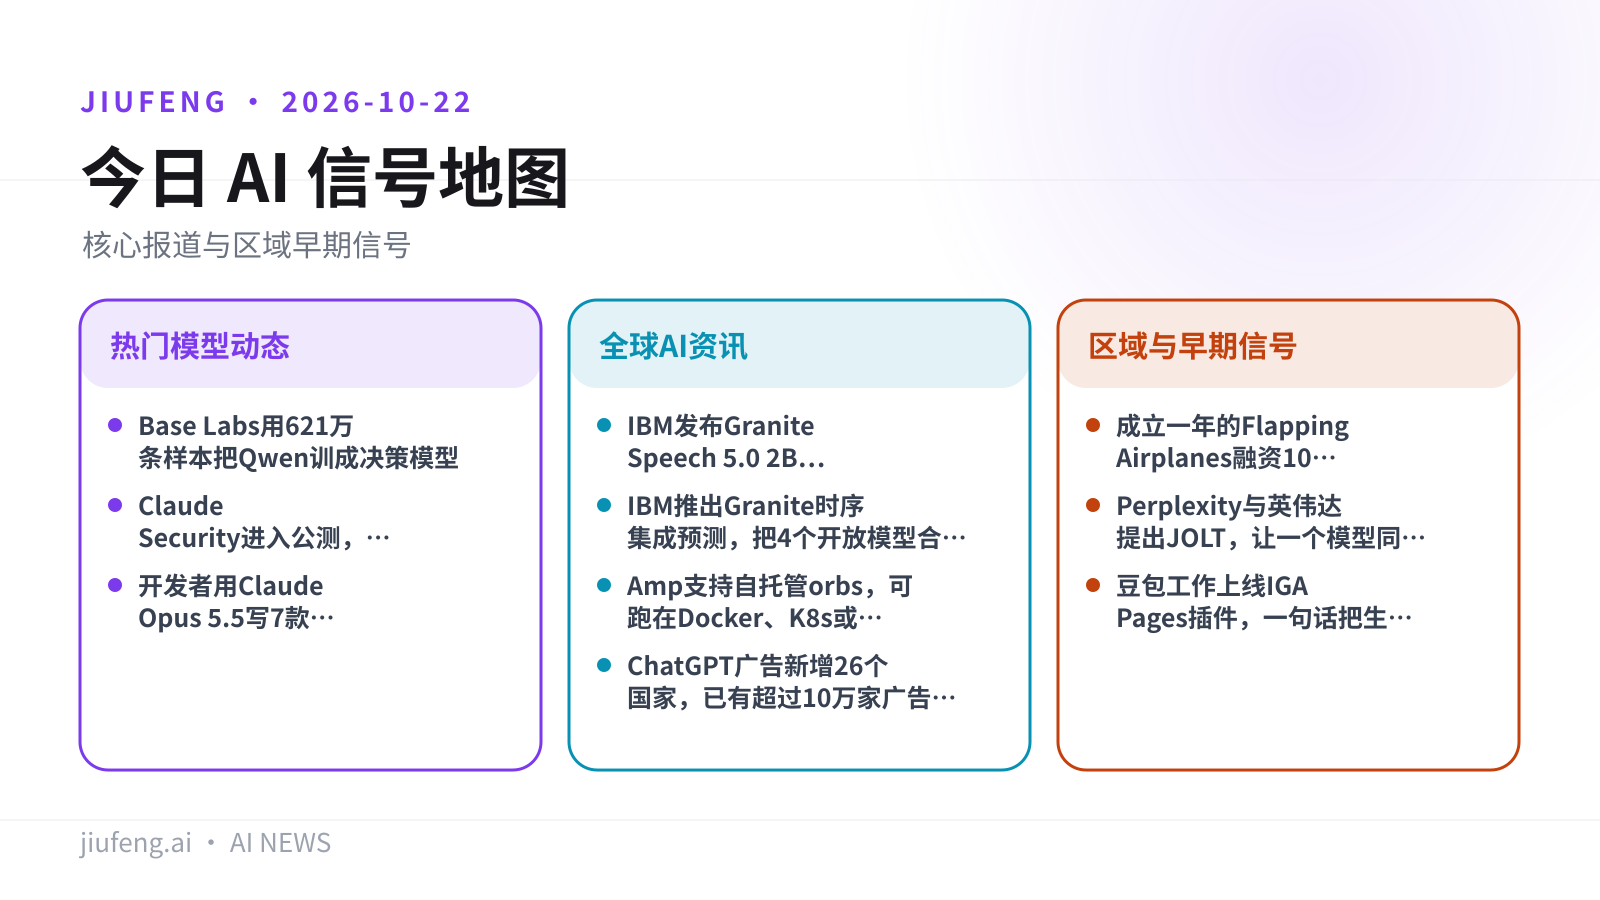
本期共 10 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · Base Labs 用 621 万条样本把 Qwen 训成决策模型
- 重点 · Claude Security 进入公测,从一次性扫描改为持续监测代码
- 重点 · 开发者用 Claude Opus 5.5 写 7 款 Adobe 替代品,后承认「远未就绪」
全球 AI 资讯
- IBM 发布 Granite Speech 5.0 2B,Open ASR 榜排第二
- IBM 推出 Granite 时序集成预测,把 4 个开放模型合成一个默认方案
- Amp 支持自托管 orbs,可跑在 Docker、K8s 或 Modal 上
- ChatGPT 广告新增 26 个国家,已有超过 10 万家广告主使用
区域与早期信号
- 成立一年的 Flapping Airplanes 融资 10 亿美元
- Perplexity 与英伟达提出 JOLT,让一个模型同时当老师和学生
- 豆包工作上线 IGA Pages 插件,一句话把生成的网页发布成公网链接
九凤根据本期已引用来源整理。
热门模型动态
01/10
Base Labs 用 621 万条样本把 Qwen 训成决策模型
Baseten 旗下实验室以 Qwen 为底座,发布了两款开放权重模型。它们不生成文本,而是直接给选项打出校准概率。
Baseten 内部研究实验室 Base Labs(负责人 Max Kirkby)10 月 21 日发布 mammoth-1 和 elephant-1。两款模型都基于 Qwen 后训练,训练数据共 621 万条样本。它们不输出生成式回答,而是给候选选项打出校准后的概率。
- mammoth-1:27B 参数,实验室称在 Jev Decision Index 排名第一
- elephant-1:9B 参数,实验室称在同等较小规模的模型里排名靠前
- 权重:两款都是开放权重
- 方法:实验室发布了技术报告,公开的方法细节足以检验其榜单说法
局限:榜单成绩来自 Base Labs 自己的发布。RuntimeWire 指出,这些提升能否迁移到真实业务流程,比榜单名次更重要。
来源:Base Labs(X) · RuntimeWire
02/10
Claude Security 进入公测,从一次性扫描改为持续监测代码
Anthropic 把 Claude 的代码安全扫描做成了常驻服务:代码变了就重新扫描,每个问题一直跟踪到修复。
Anthropic 10 月 21 日扩展了 Claude Security。公测版加入跨代码仓库、跨 Git 托管平台的定期扫描,发现的问题会一路跟踪到修复。该功能面向 Claude Enterprise 客户,同时开放 API 和 MCP 连接器,方便接入现有安全流程。
局限:Anthropic 公布的漏洞发现数量是公司自报数据。RuntimeWire 认为,要判断这套流程能否站住,关键看采用情况、确认修复的数量和单独定价。
来源:Claude(X) · RuntimeWire
03/10
开发者用 Claude Opus 5.5 写 7 款 Adobe 替代品,后承认「远未就绪」
开发者先宣称一个月内与 Adobe 功能对齐,后来在 Hacker News 改口。这个 AI 生成项目的宣传和实际进度对不上。
一名开发者用 Claude Opus 5.5 为 7 款 Adobe 应用分别写了开源替代品,并在 Reddit 多个版块推广,预计约一个月内与原版功能「接近 100% 对齐」。之后,这名开发者在 Hacker News 上表示,这些项目「远未准备好」。
局限:据 InfoQ 报道,项目自己的路线图显示完成度为 45%,与「一个月内接近 100% 对齐」的宣传差距明显。目前只有 InfoQ 一家报道。
来源:InfoQ
全球 AI 资讯
04/10
IBM 发布 Granite Speech 5.0 2B,Open ASR 榜排第二
这是一个 2B 参数、Apache 2.0 许可的语音识别与翻译模型,英文平均词错率 5.68%。
IBM 发布 Granite Speech 5.0 2B,用于语音识别和语音翻译,同时更新了 Turbo CTC 版和 4.1 版模型。
- 规模:2B 参数
- 许可:Apache 2.0
- 榜单:Open ASR Leaderboard 第 2 名
- 英文平均 WER:5.68%
局限:榜单名次与 WER 来自 MarkTechPost 对这次发布的整理。所附论文介绍的是 Granite Speech 系列的技术方法,5.0 版的具体评测设置以 IBM 模型卡为准。
来源:MarkTechPost · Granite Speech 论文
05/10
IBM 推出 Granite 时序集成预测,把 4 个开放模型合成一个默认方案
不用再纠结选哪个时序基础模型:一套配方组合了 4 种 Granite 架构,不需要重新训练就能出预测。
IBM Research 10 月 22 日发布 Granite Timeseries Ensemble。它组合了 4 种互补的开放 Granite 时序架构,其中包括基于 MLP mixer 的 Granite TTM-r3(Tiny Time Mixers),通过一个可扩展的预测接口统一调用,输出中位数预测和分位数预测。整个过程不需要在用户数据上重新训练,也不需要额外拟合集成权重。官方同时提供了入门 notebook。
局限:IBM 把它定位成「合理的默认选择」,不是每个场景下的最优解。原文也提到,擅长平滑工业信号的模型,遇到噪声大的零售需求数据或长季节周期时,可能会吃力。
图片来源:huggingface;已转存至九凤 R2。
来源:Hugging Face Blog(IBM Research) · PatchTST-FM-r1 论文 · 入门 notebook
06/10
Amp 支持自托管 orbs,可跑在 Docker、K8s 或 Modal 上
用户自己出算力,Amp 把它变成 orbs,智能体的运行环境可以留在自家基础设施里。
用户在自己的基础设施里运行 amp orb provider 后,它会主动连接 Amp,等待创建、暂停、删除 orb 的请求。收到的请求按 spawn、pause、delete 三种操作,转给用户自己提供的程序(例如 ./dispatch.sh)执行。官方示例覆盖 Docker、E2B、K8s、Apple containers、Modal、Vercel、Daytona 和 exe.dev。
局限:自托管对算力有要求:要能快速启动新机器、快速休眠和恢复、长期保留实例,还要能缩容到零。达不到这些条件,就做不出托管版 orb 的体验。
07/10
ChatGPT 广告新增 26 个国家,已有超过 10 万家广告主使用
OpenAI 扩大了 ChatGPT 广告的投放范围,广告主可以在用户比较商品、决定购买时触达他们。
OpenAI 宣布,ChatGPT Ads 新增 26 个国家。用过该平台的广告主已超过 10 万家,从本地商家到全球品牌都有。广告出现在用户探索、比较和决定购买的环节。
局限:本条依据 OpenAI 官方公告。26 个国家的具体名单和各地广告展示规则以公告原文为准,目前没有独立的第三方投放数据。
来源:OpenAI
区域与早期信号
08/10
成立一年的 Flapping Airplanes 融资 10 亿美元
这家研究实验室还没有商业产品,目标是用比当前前沿系统少得多的数据训练模型。
AI 研究实验室 Flapping Airplanes 10 月 21 日宣布完成 10 亿美元新融资,距成立约一年。据 Bloomberg 报道,本轮估值 60 亿美元。公司的目标是训练出比当前前沿系统用数据少得多的模型。第一年,公司主要在开发 GPU 底层原语,自称做出了「最完整的 megakernel 框架」。按 Index Ventures 的说明,megakernel 把整个程序作为单个 kernel 放在 GPU 上运行,减少步骤之间的空转。公司称,这个框架能在同一个 kernel 里同时完成整轮训练、提供推理服务,甚至运行一款电子游戏。
局限:公司目前没有任何商业产品,性能说法都来自公司自己。估值数字来自 Bloomberg 的报道,不是公司公布的。
来源:SiliconANGLE
09/10
Perplexity 与英伟达提出 JOLT,让一个模型同时当老师和学生
后训练方法 JOLT 在 MATH 上追平了 GRPO 的准确率,处理的训练 token 少 6.5 倍。
Perplexity 和英伟达的研究人员提出 JOLT(Joint On-policy Learning and Teaching)。这种后训练方法让同一个模型同时当老师和学生。在 MATH 基准上,它的准确率与 GRPO 相当,处理的训练 token 少 6.5 倍。
- 评测设置:共 5 个,分别是 GSM8K、MATH、LiveCodeBench v6、AppWorld、Terminal-Bench 2.1
- 模型范围:Qwen3-0.6B 到 Qwen3-30B-A3B,以及 DeepSeek-V2-Lite
- 结果:JOLT+ 在每个设置里的平均分都最高
局限:以上结果来自研究团队自己的实验,目前只有 MarkTechPost 一家媒体报道。
来源:MarkTechPost
10/10
豆包工作上线 IGA Pages 插件,一句话把生成的网页发布成公网链接
豆包工作生成的 HTML 页面,现在说一句「部署」就能变成可分享的链接,还能升级成多人共创页面。
据 InfoQ 中文报道,在豆包工作里对生成的网页说「帮我部署上线」,IGA Pages 会自动打包项目文件、上传到火山引擎服务器,几秒后返回公网预览链接。首次部署需要在浏览器里登录授权一次,之后会自动保持登录。用户还可以在原页面基础上升级成多人共创页面,支持景点投票、点赞等协作功能。
局限:预览链接有效期 3 小时,而且必须带 iga_token/iga_time 参数。使用时需要火山引擎账号;共创功能依赖火山引擎 Supabase,按实际用量计费,账号余额要充足。目前只有中文媒体报道。
来源:InfoQ 中文
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片