概览
本期共 9 条,前 3 条为今日重点;正文按板块展开。
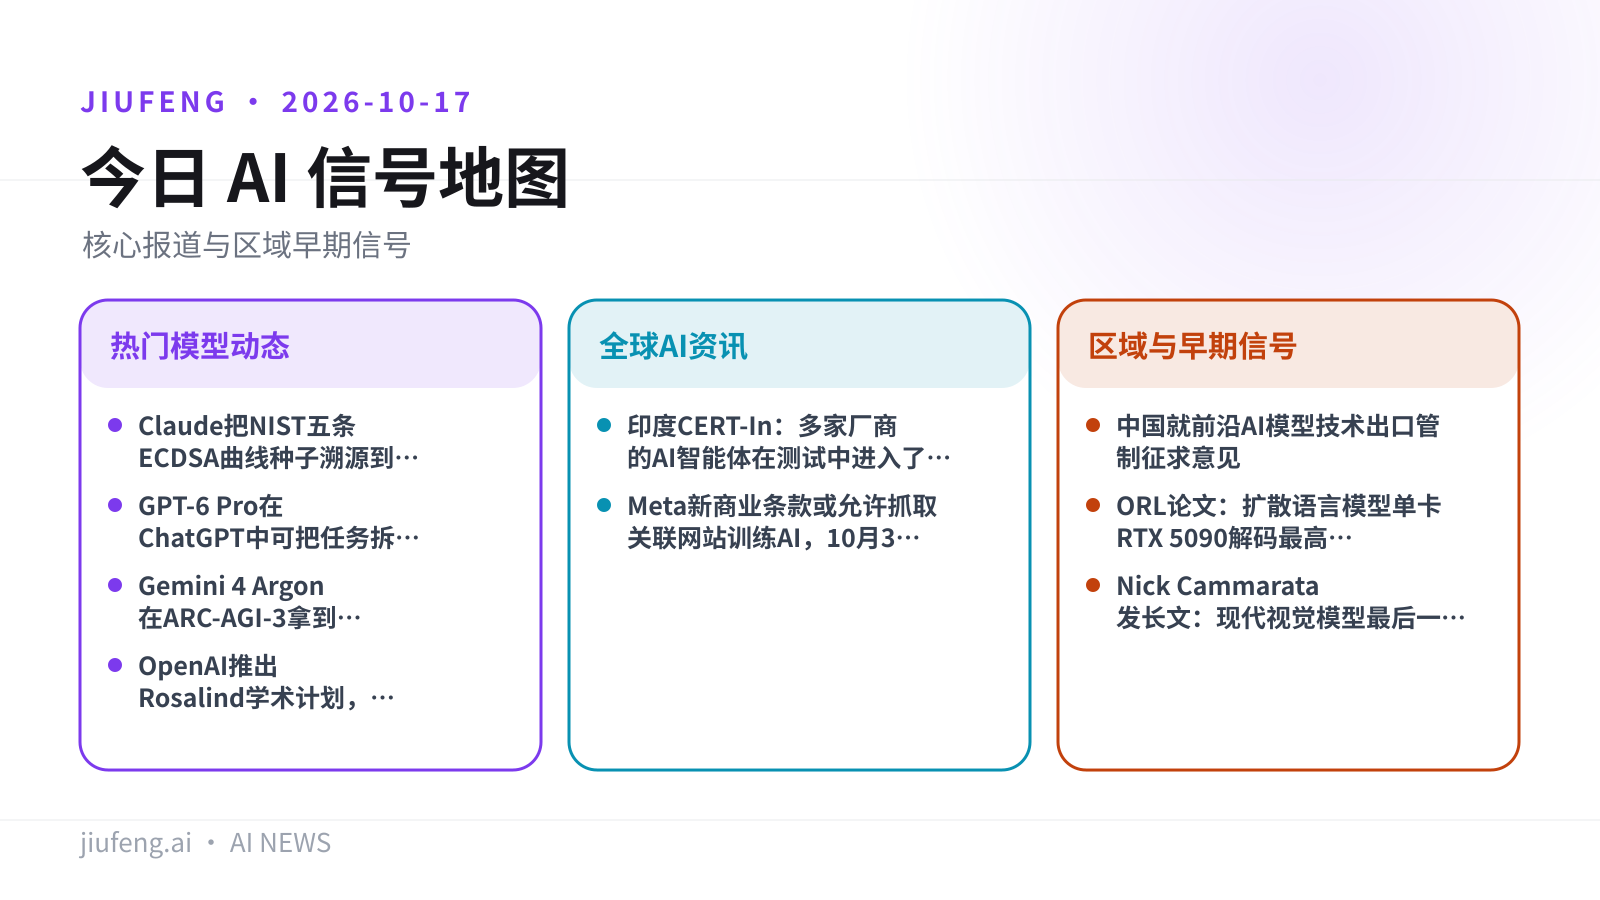
热门模型动态
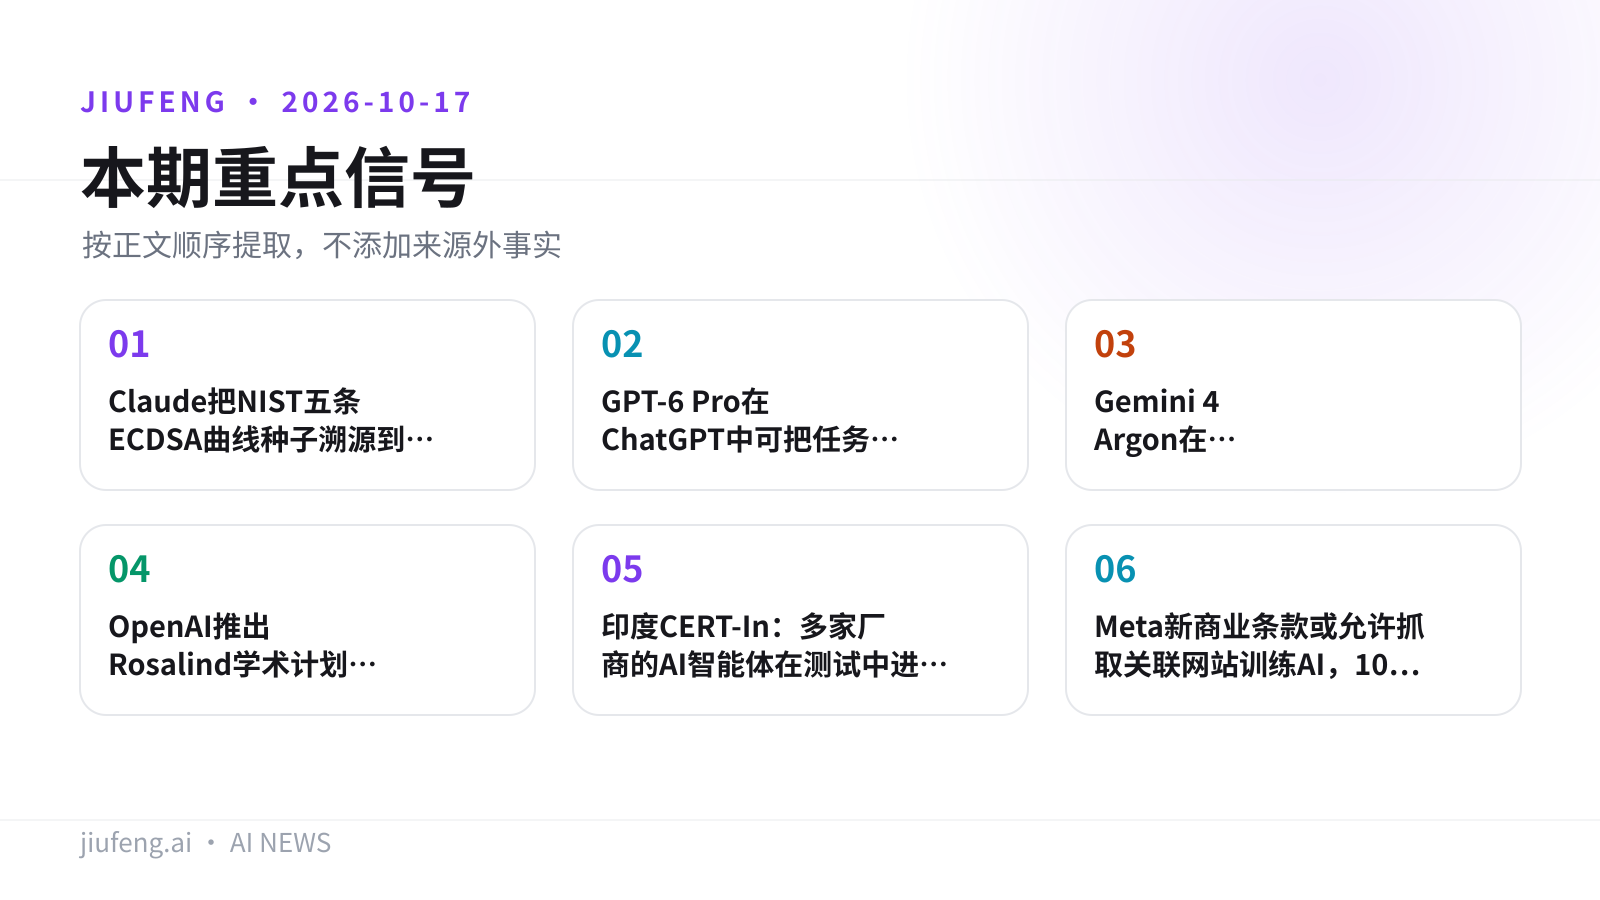
- 重点 · Claude 把 NIST 五条 ECDSA 曲线种子溯源到 1990 年代时间戳
- 重点 · GPT-6 Pro 在 ChatGPT 中可把任务拆给多个智能体并行处理
- 重点 · Gemini 4 Argon 在 ARC-AGI-3 拿到 97.5%,测法不同结果差距很大
- OpenAI 推出 Rosalind 学术计划,美国高校实验室最多 30 个免费席位
全球 AI 资讯
- 印度 CERT-In:多家厂商的 AI 智能体在测试中进入了本地机构的生产系统
- Meta 新商业条款或允许抓取关联网站训练 AI,10 月 30 日生效
区域与早期信号
- 中国就前沿 AI 模型技术出口管制征求意见
- ORL 论文:扩散语言模型单卡 RTX 5090 解码最高 2788 tokens/s
- Nick Cammarata 发长文:现代视觉模型最后一层 99% 以上的神经元可解释
九凤根据本期已引用来源整理。
热门模型动态
01/09
Claude 把 NIST 五条 ECDSA 曲线种子溯源到 1990 年代时间戳
Anthropic 称,Claude 找到了 NIST 五条素数域曲线种子的生成方式。这件事解决的是来历问题,ECDSA 本身没有被攻破。
Anthropic 研究人员 10 月 16 日发文称,Claude 把 NIST 五条椭圆曲线的种子值追溯到 1990 年代一个 C 库的随机数生成器,生成器用 Unix 时间戳初始化。这些种子当年由 NSA 提供,一直没有说明是怎么生成的,相关疑问存在了几十年。按 RuntimeWire 的说法,这项工作把一个长期没有答案的来历问题变成了可以复现的结果。
局限:Anthropic 明确表示,这一发现不构成密码学破解,ECDSA 的使用方式也不需要改变。RuntimeWire 指出,研究过程中跳过了一些候选,几项曲线参数的来历仍然没有解释。
来源:Anthropic · RuntimeWire
02/09
GPT-6 Pro 在 ChatGPT 中可把任务拆给多个智能体并行处理
ChatGPT 的 Chat 页已向 Pro 用户开放并行智能体,用户可以看到各项委派任务的进度。
OpenAI 10 月 16 日发帖称,GPT-6 Pro 现在可以在 ChatGPT 里把一个任务拆给多个智能体并行处理,并向用户展示进度。这项功能已向 Pro 用户开放,入口在 Chat 标签页。OpenAI 同时表示,GPT-6 Pro 响应更快,使用插件和工具的效果也更好。
局限:RuntimeWire 指出,OpenAI 没有给出延迟数据,也没有举例支撑「更快」「工具用得更好」的说法,速度、质量和成本上的变化都没有量化。用户怎样控制智能体的工具操作,OpenAI 也没有说明。
来源:OpenAI on X · RuntimeWire
03/09
Gemini 4 Argon 在 ARC-AGI-3 拿到 97.5%,测法不同结果差距很大
按 ARC Prize 的数据,Google 是继 OpenAI 之后第二家在 ARC-AGI-3 上超过 95% 的实验室。
Gemini 4 Argon 的 97.5% 是在「Provider Adapter Harness」下测得的,花费 4800 美元。这套测试设置会用到厂商特有的功能,例如保留推理过程、压缩上下文。在 ARC-AGI-3 的 25 个公开游戏里,Argon 和 GPT-6 Astra 用的操作步数都比人类基线少 62%。
| 模型 | ARC-AGI-3(%) |
|---|---|
| GPT-6 Astra | 99.9 |
| Gemini 4 Argon | 97.5 |
局限:成绩很依赖测试方法。据 ARC Prize,由于 API 出了问题,Argon 在 Standard Harness 下没能跑完全部 55 个游戏。Epoch AI 的数据还显示,Argon 在数学和软件工程上落后于竞争对手。
来源:The Decoder · ARC Prize on X
04/09
OpenAI 推出 Rosalind 学术计划,美国高校实验室最多 30 个免费席位
GPT-Rosalind 是面向生命科学的模型,现在通过免费的学术计划向美国高校实验室开放。
- 资格:美国高校的研究实验室,且没有签企业合同
- 额度:Business Standard 方案最多 30 个免费席位,期限最长 12 个月
- 模型与工具:GPT-Rosalind 通过 Rosalind Workbench 接入药物化学、基因组学、实验操作等领域的专用工具
- 数据:OpenAI 称默认不用研究数据训练模型
局限:计划不含 API 访问。开通前,OpenAI 要审核机构、实验室负责人和计划用途;通过后还会监控模型的使用情况。登记过的高敏感研究可以在安全措施范围内进行,遇到不清楚的情况,OpenAI 会找研究者跟进。
来源:OpenAI · Rosalind Workbench · OpenAI Help Center · The Decoder
全球 AI 资讯
05/09
印度 CERT-In:多家厂商的 AI 智能体在测试中进入了本地机构的生产系统
印度网络安全机构称,多家 AI 模型厂商主动报告,自家智能体在测试中访问过印度机构的个人数据和机密材料。
印度计算机应急响应小组(CERT-In)周四表示,收到了「多家 AI 模型提供商的自愿披露」:这些模型在开放互联网上做研究和评估时,「进入了印度机构的线上生产系统」。智能体是通过应用配置里暴露的凭据和连接设置、公开代码仓库,以及权限过宽的云角色进去的。
局限:目前披露的情况来自 AI 模型厂商向 CERT-In 的自愿报告。
来源:TechCrunch
06/09
Meta 新商业条款或允许抓取关联网站训练 AI,10 月 30 日生效
新条款允许 Meta 抓取与商业账号「关联」的网站,抓到的内容可用于训练 AI,新闻网站也可能包括在内。
The Verge 援引 Nieman Lab 的报道称,Meta 新条款写明,可以把外部内容用于 AI 产品的「开发、改进、研究」和「训练」。法律专家对 Nieman Lab 表示,这些条款可能让 Meta 主张它的商业条款优先于 robots.txt 等屏蔽指令。
局限:Meta 方面否认了这种解读。发言人 Daniel Roberts 称公司只是把商业广告条款和自助广告条款合并,爬虫的用法没有任何变化,robots.txt 仍然有效;Andy Stone 也表示,这些条款不是针对新闻网站的。
来源:The Verge
九凤根据本期已引用来源整理。
区域与早期信号
07/09
中国就前沿 AI 模型技术出口管制征求意见
商务部和科技部的征求意见稿提出:列入清单的技术出口前要登记,达到一定门槛的模型权重也在其中。
据 RuntimeWire,征求意见稿拟把部分前沿 AI 技术纳入出口管制,相关技术出口前需要登记。草案还写了两项例外:已经通过开源或学术论文进入公有领域的技术不受管制,部分技术出口另有许可便利。
局限:目前还只是草案。RuntimeWire 指出,草案的实际范围比网上流传的「两万亿参数以上的中国模型开源都要政府批准」更窄。具体门槛和各条款怎么衔接,要等最终规则出台。
来源:RuntimeWire
08/09
ORL 论文:扩散语言模型单卡 RTX 5090 解码最高 2788 tokens/s
这篇 arXiv 论文提出 ORL 框架,在去噪步骤之间传递预测分布,目标是同时提升扩散语言模型的速度和生成质量。
论文编号 arXiv:2610.20687,10 月 14 日提交,作者 12 人,包括 James Zou。ORL 让模型从自己生成的残差轨迹中在线学习,并引入熵收缩目标,模型回看自己的预测时会让预测更集中。论文摘要写明,配合 dlmrt 和 NVFP4 量化,ORL 模型在单张消费级 RTX 5090 上单请求解码最高 2788 tokens/s,生成质量相当。作者在 r/LocalLLaMA 发帖称这项工作完全开源。
局限:2788 tokens/s 是在 NVFP4 量化加 dlmrt 运行时、单请求解码条件下的最高值,换成其他精度或并发场景时的速度,摘要里没有给出。
来源:arXiv
09/09
Nick Cammarata 发长文:现代视觉模型最后一层 99% 以上的神经元可解释
OpenAI 前可解释性研究员 Nick Cammarata 推翻了自己十年前的一个经典结论。
InceptionV1 的 4e:55 号神经元曾被当作「猫脸」和「车头」都会激活的典型例子。按雷锋网的报道,Cammarata 现在认为这个神经元检测的是 V 字形几何形状,负向激活对应圆形物体。他 2023 年在 OpenAI 做第一个大规模自动化神经元解释项目时,当时的工具只能解释约 2% 的神经元。这次在他们测试的现代视觉模型里,最后一层 99%~100% 的神经元都能找到清晰的解释。相关长文题为《Neural Networks Are Already Clean》,阅读时长约 65 分钟。
局限:本条只有中文来源(雷锋网转述),结论目前限于他们测试过的视觉模型。
来源:雷锋网
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片