概览
本期共 8 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · Meta 发布 Muse Wonder 两个版本,Full 版智能指数 56 分
- 重点 · GPT-6 Sol、Luna、Astra 在 Bedrock 开通东南亚与台湾全球跨区推理
全球 AI 资讯
- 重点 · 微软研究:清空对话历史能帮智能体跳出「想法盆地」
- AWS Ray LLM 容器支持多节点推理,prefill 与 decode 分开部署
- SageMaker 用 llama.cpp 容器部署决策模型,直接返回选项概率
- Deepgram 想把语音 AI 搬到离线笔记本上
区域与早期信号
- 千问发布 QwenGyre,用于训练超长程智能体任务的在线强化学习框架
- CodeScene 用 Claude Opus 三周重构 30 万行 C 代码
热门模型动态
01/08
Meta 发布 Muse Wonder 两个版本,Full 版智能指数 56 分
Meta 新前沿模型 Muse Wonder Full 进入第一梯队,智能体任务涨幅最大,但单次调用成本接近上代三倍。
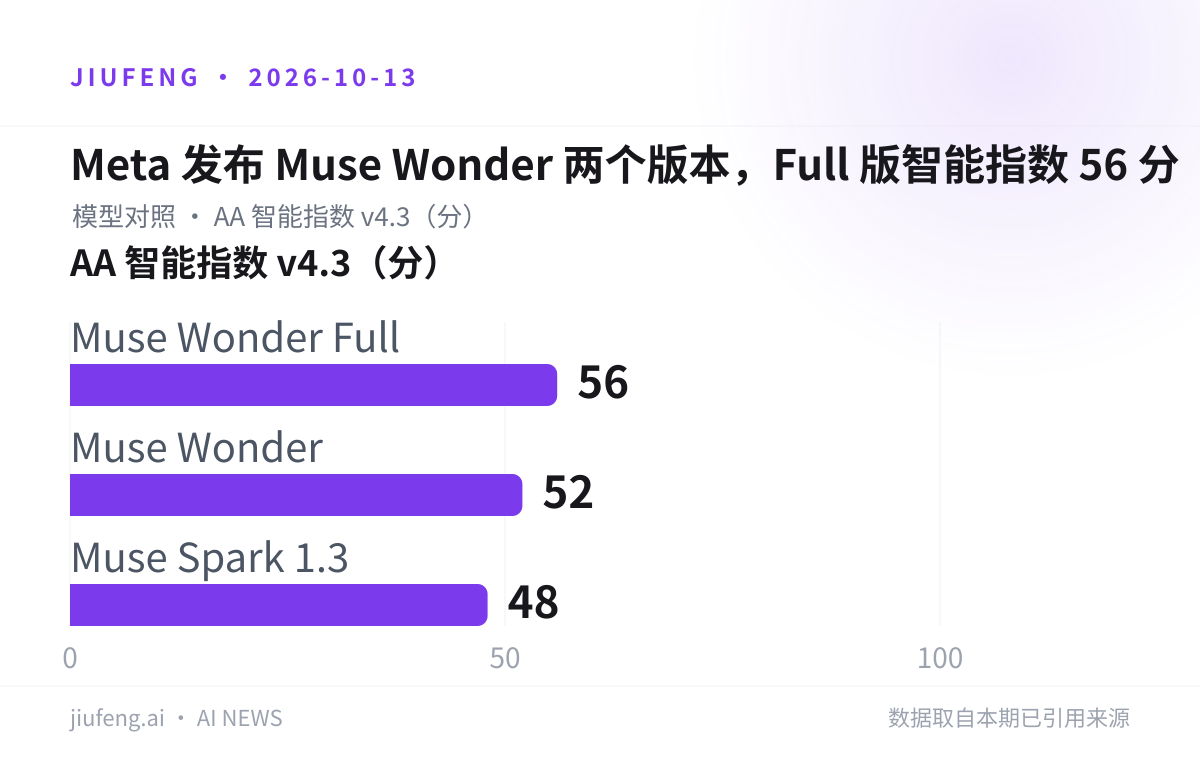
Meta 发布前沿模型 Muse Wonder,分为 Muse Wonder 与 Muse Wonder Full 两个版本。据 The Decoder 报道,两者在 Artificial Analysis Intelligence Index v4.3 上分别得到 52 分和 56 分,上一代 Muse Spark 1.3 为 48 分。
| 模型 | AA 智能指数 v4.3(分) |
|---|---|
| Muse Wonder Full | 56 |
| Muse Wonder | 52 |
| Muse Spark 1.3 | 48 |
涨幅集中在智能体类评测:Terminal-Bench 4.0 成绩从 33% 升至 57%。Muse Wonder Full 在 10 项基准中的 6 项进入前三。Vals AI 也在其指数榜单上公布了 Muse Wonder 的成绩。
局限:两个版本每次 API 调用的成本都接近 Muse Spark 1.3 的三倍。报道中「追平头部前沿模型」的结论部分依据 Meta 官方公布的基准成绩。
九凤根据本期已引用来源整理。
来源:The Decoder · Vals AI Index
02/08
GPT-6 Sol、Luna、Astra 在 Bedrock 开通东南亚与台湾全球跨区推理
新加坡、雅加达、泰国、马来西亚、台北五个 AWS 区域,现在可以通过全球跨区推理调用 OpenAI GPT-6 系列。
AWS 官方博客说明,单区域推理在需求超过本地容量时会被限流,全球跨区推理(global cross-Region inference)可以把请求分发出去,突破本地容量限制。各模型的开放范围如下:
| 模型 | 可发起调用的源区域 |
|---|---|
| GPT-6 Sol | 新加坡、雅加达、泰国、马来西亚、台北 |
| GPT-6 Luna | 新加坡、雅加达、泰国、马来西亚、台北 |
| GPT-6 Astra | 仅亚太(新加坡) |
调用统一走 bedrock-runtime 端点,可以使用 Converse API、OpenAI 兼容 API 或编码客户端。文中还介绍了 IAM 权限配置,以及如何从源区域监控推理。
局限:全球跨区推理会把请求路由到源区域以外处理,用 SCP 按区域限制访问的组织需要相应调整策略。aws-samples 提供了一份针对 Bedrock 跨区推理的示例 SCP:对 Bedrock 调用类操作做豁免,并以推理配置文件 ARN 作为条件。
图片来源:GitHub;已转存至九凤 R2。
来源:AWS Machine Learning Blog · aws-samples SCP 示例
全球 AI 资讯
03/08
微软研究:清空对话历史能帮智能体跳出「想法盆地」
长时间运行的研究型智能体会被不断累积的上下文锁在局部解空间里,多给算力也难以跳出。
Microsoft Research 研究了「Autoresearch agents」,即反复提出方案、评估、再根据反馈改进的 AI 系统。同一个智能体在同一任务上独立运行 8 次,最终分数停在 68.3 到 100.0 之间。论文称,即使大幅增加算力,这种差距也依然存在。
研究者把所有运行产生的方案投到一张二维图上,相似的方案彼此靠近。结果显示,单次运行的方案几乎都集中在一小块区域,作者称之为「想法盆地」。他们提出的 Fork-and-Flush 方法通过清空对话历史,让智能体重新探索。
局限:这项研究以 arXiv 论文形式发布,68.3–100.0 的分化来自对同一任务的 8 次运行,样本规模有限。
来源:The Decoder · arXiv 论文
04/08
AWS Ray LLM 容器支持多节点推理,prefill 与 decode 分开部署
AWS 演示用多节点 Ray LLM 深度学习容器,把一个大模型拆到两个 GPU 节点上运行。
这篇教程在 Amazon EKS 上把一个 LLM 部署到两个 GPU 节点:prefill 和 decode 各占一个节点,对外共用一个 OpenAI 兼容端点。容器预装了以下组件:
- Ray Serve LLM:分布式推理服务层
- NVIDIA Inference Transfer Library(NIXL):负责节点间的推理数据传输
- Elastic Fabric Adapter(EFA):AWS 的高速网络栈
AWS 列出的多节点适用场景有三类:单卡放不下的基础模型或开放权重模型、单个副本吞吐不够,以及想把推理两个阶段拆开来优化性能。
局限:这是部署教程,需要用户自建 EKS 集群和 GPU 节点。示例只演示了两节点的 prefill/decode 分离拓扑。
来源:AWS Machine Learning Blog · NIXL(GitHub)
05/08
SageMaker 用 llama.cpp 容器部署决策模型,直接返回选项概率
同一个量化模型可以走两条路:生成文本,或者不解码、直接对固定选项输出概率。
AWS 用 llama.cpp 深度学习容器在 SageMaker AI 上部署决策模型,部署方式分两条:
- 文本生成:通过 InvokeEndpoint 提供 OpenAI 兼容的 chat completions
- 结构化决策:构建子镜像替换默认运行时,接入 SemIf(原名 OpenJev),不用解码答案 token,直接返回各个声明选项的概率
- 硬件:示例代码同时提供 CPU 和 GPU 部署方案
这类模型适合请求路由、选择智能体动作、分配策略结果等需要从固定选项中打分的场景。这篇文章属于 AWS 专用推理容器系列,前几篇讲的是 WhisperX 和 vLLM-Omni。
局限:结构化决策路径需要用户自己构建并维护子镜像,不能直接使用默认的 DLC 镜像。
来源:AWS Machine Learning Blog · llama.cpp(GitHub)
06/08
Deepgram 想把语音 AI 搬到离线笔记本上
Deepgram 透露正在推进语音 AI 在个人设备和隔离网络笔记本上运行。
Deepgram 今年早些时候已把 Flux 模型扩展到 10 种语言。公司技术项目经理 Nick Mann 介绍,Deepgram 有 45 名研究员,外部客户有数万家,研究和服务都需要大量算力与数据。
局限:这是一场访谈,在戴尔 AI Leadership Symposium 期间录制,原文附有披露说明。访谈没有给出离线笔记本版本的发布时间、硬件要求或模型规格。
来源:SiliconANGLE
区域与早期信号
07/08
千问发布 QwenGyre,用于训练超长程智能体任务的在线强化学习框架
QwenGyre 让持续数小时、累计上百万 token 的智能体任务也能拿来做在线强化学习训练。
QwenGyre 把 GPU 划分成多个计算单元。一批任务结束后,空出来的单元马上转去训练,仍在运行的任务保留进度和状态。框架用 Token-in Token-out 记录每段输出生成时的真实上下文,按共享前缀组织成轨迹树;超时但部分完成的任务也能通过 Partial Scoring 提供反馈。
- NL2RepoBench:每次 rollout 约 70 万 token,训练 48 步后通过率从 52.5% 升至 58.5%
- 训练速度:相同 GPU 预算下,端到端速度是 Async 方案的 1.78 倍,训练分数和 Async、Colocate 接近
- 跨任务验证:在 Qwen3.6-122B 上,NL2RepoBench、DeepSWE、TerminalBench 三类任务都实现了端到端提速
局限:以上数据都来自千问官方。报道没有提到是否开源,也没有附上论文或代码链接。
来源:IT之家
08/08
CodeScene 用 Claude Opus 三周重构 30 万行 C 代码
编码智能体花约 4000 美元的 token,把一个开源反编译项目的 Code Health 从 5.6 提到 10.0。
CodeScene 公布了一项案例:重构对象是《街头霸王 III:三度冲击》的开源反编译项目,规模约 30 万行 C 代码。三周里,智能体在 726 个文件中提交了 2903 次,修改 252055 行代码。
质量判断靠 CodeHealth MCP Server 提供的确定性评分。正确性靠回放轨迹测试框架:每次修改后逐帧比较回滚状态哈希。工作过程中,智能体自己积累出一套重构手册,包含 22 个方案和 82 条辅助说明。团队大部分工作用的是 Claude Opus,并称在识别和记录模式上,Claude Code 搭配 Opus 明显好于 Codex 搭配 Sol;换用较小的模型时,文件评分常常停滞不前。
局限:有从业者质疑这一结果的适用范围,问题包括这些改动是否已经合并、是一次性合并还是分多次合并,以及在开源代码上做的实验能否推广到真正创造收入的生产代码。
来源:InfoQ 中文
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片