概览
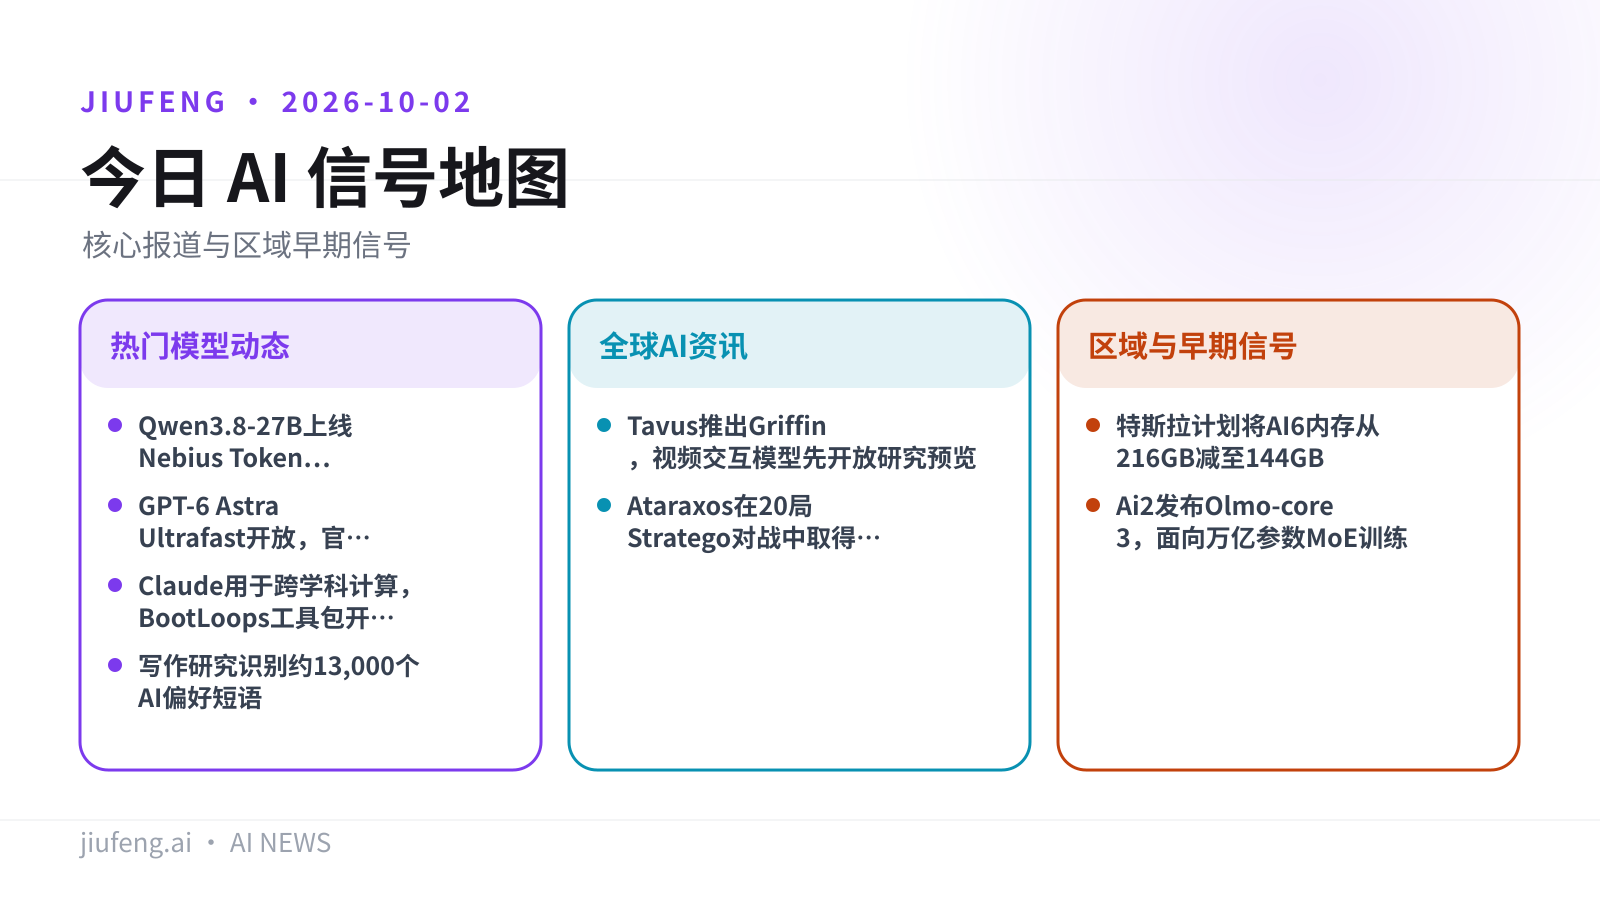
本期共 8 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · Qwen3.8-27B上线Nebius Token Factory
- 重点 · GPT-6 Astra Ultrafast开放,官方称生成速度最高为标准档8倍
- 重点 · Claude用于跨学科计算,BootLoops工具包开放代码
- 写作研究识别约13,000个AI偏好短语
全球AI资讯
- Tavus推出Griffin,视频交互模型先开放研究预览
- Ataraxos在20局Stratego对战中取得15胜
区域与早期信号
- 特斯拉计划将AI6内存从216GB减至144GB
- Ai2发布Olmo-core 3,面向万亿参数MoE训练
九凤根据本期已引用来源整理。
热门模型动态
01/08
Qwen3.8-27B上线Nebius Token Factory
270亿参数的Qwen3.8-27B新增托管推理入口,共享API目前定位于测试。
Nebius于9月28日宣布Qwen3.8-27B已在Token Factory上线,阿里千问团队于9月30日转发介绍这一接入方式。模型权重自8月起已经开放,本次变化是增加托管访问渠道,用户无需自行搭建推理服务。
局限:Nebius端点页面将共享API标为适合测试、并非生产用途,且可用性可能变化;现有材料未给出足以比较价格、速度或客户采用规模的数据。
图片来源:huggingface;已转存至九凤 R2。
来源:RuntimeWire · Nebius公告 · Qwen模型卡
02/08
GPT-6 Astra Ultrafast开放,官方称生成速度最高为标准档8倍
NVIDIA称,运行于Blackwell GPU的Ultrafast现已面向API及符合条件的ChatGPT Work、Codex用户提供。
NVIDIA于10月1日介绍,Ultrafast通过模型推理优化利用Blackwell架构能力,比较指标为token生成速度。官方给出的相对速度如下:
| Astra模式 | 相对token生成速度(倍) |
|---|---|
| Standard | 1(比较基准) |
| Ultrafast | 最高8 |
局限:8倍是厂商公布的最高值,指标范围是token生成,并非整个编码任务的完成时间;ChatGPT Work和Codex访问仍受用户资格限制,具体接入与价格需查阅官方指南。
来源:NVIDIA AI Blog · OpenAI Ultrafast指南
03/08
Claude用于跨学科计算,BootLoops工具包开放代码
物理学家Matthew Schwartz公开科研计算工具包,Anthropic介绍了Claude使用它的研究案例。
Anthropic在10月1日的文章中介绍,哈佛物理学家Matthew Schwartz将科研计算中使用的软件和协议整理为BootLoops,目标是帮助模型完成定量科学中的精确计算。Schwartz称,Claude借助该工具把数学物理方法用于生态学、遗传学等领域的问题,项目代码已在GitHub开放。
局限:BootLoops是Schwartz的项目,支持不同模型,并非Anthropic产品;Schwartz强调,计算在技术上正确不代表研究具有科学价值,选题与结果判断仍需领域专家。
来源:RuntimeWire · Anthropic研究文章 · BootLoops代码
04/08
写作研究识别约13,000个AI偏好短语
Graphite研究发现,前沿模型的文字仍保留可统计的词语与句式偏好。
据TechCrunch报道,营销公司Graphite比较了前沿模型与人类文本,把在AI文本中出现频率至少为人类文本两倍的短语定义为一种写作特征,共识别出约13,000个。报道还指出,模型文本保留了偏爱对照句式的习惯。
局限:这些频率差异描述的是研究样本中的文本特征;所给报道摘录未提供样本规模、语料构成或据此识别单篇文章的准确率。
来源:TechCrunch
全球AI资讯
05/08
Tavus推出Griffin,视频交互模型先开放研究预览
Tavus称,48%的测试参与者在一分钟视频通话后将Griffin判断为真人。
Griffin在实时接收和生成视频的同时处理语音、表情、语调、手势与停顿,Tavus将其称为“Human Interaction Model”。据The Decoder转述,在Tavus所称由NVIDIA独立开展的音视频交互拟人程度测试中,各对象得分如下:
| 测试对象 | 拟人程度得分(分) |
|---|---|
| 真人 | 3.92 |
| Griffin | 3.83 |
| 此前最佳AI模型 | 2.80 |
局限:48%的辨认结果来自Tavus自己的研究,NVIDIA测试的独立性表述也来自该公司;目前仅有Griffin-Lite向部分测试者开放研究预览,更强版本需等待安全问题得到处理。
来源:The Decoder
06/08
Ataraxos在20局Stratego对战中取得15胜
研究团队报告,Ataraxos对阵四届世界冠军Pim Niemeijer取得15胜、1负、4平。
来自卡内基梅隆大学、纽约大学、斯坦福大学和MIT的团队在发表于Nature的论文中介绍了Ataraxos,The Decoder报道称训练成本低于8,000美元。Stratego双方棋子的身份对对手隐藏,此次结果来自一场正式的20局系列赛,团队已公开代码。
局限:作者将“首次达到超人水平”的表述限定为其所知范围。
来源:The Decoder · Ataraxos代码
区域与早期信号
07/08
特斯拉计划将AI6内存从216GB减至144GB
据IT之家转述,马斯克计划降低芯片内存容量,为Optimus量产储备内存供应。
马斯克表示,特斯拉将调整AI5与AI6的内存配置,其中报道明确列出了AI6的调整数值:
| AI6配置 | RAM容量(GB) |
|---|---|
| 原计划 | 216 |
| 调整后计划 | 144 |
局限:容量下降约33%,但马斯克称带宽保持不变,并预计对Optimus性能的影响“可以忽略”;这属于其对计划配置的判断,所给材料仅有中文媒体转述,未提供实际运行测试。
来源:IT之家
08/08
Ai2发布Olmo-core 3,面向万亿参数MoE训练
Olmo-core 3重做开放MoE训练系统,发布对象是训练框架。
Ai2于10月1日在Hugging Face介绍Olmo-core 3,称其设计目标是在保持计算效率的同时,把混合专家模型训练扩展到万亿参数范围。该框架是下一代Olmo的核心系统之一,代码已在GitHub提供。
局限:万亿参数是框架的扩展目标,所给摘录没有披露对应规模的实际训练吞吐或成本;公告同时指出,MoE仍需在GPU内存中保存完整模型,并在训练中更新参数。
来源:Ai2发布文章 · Olmo-core代码
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片

