概览
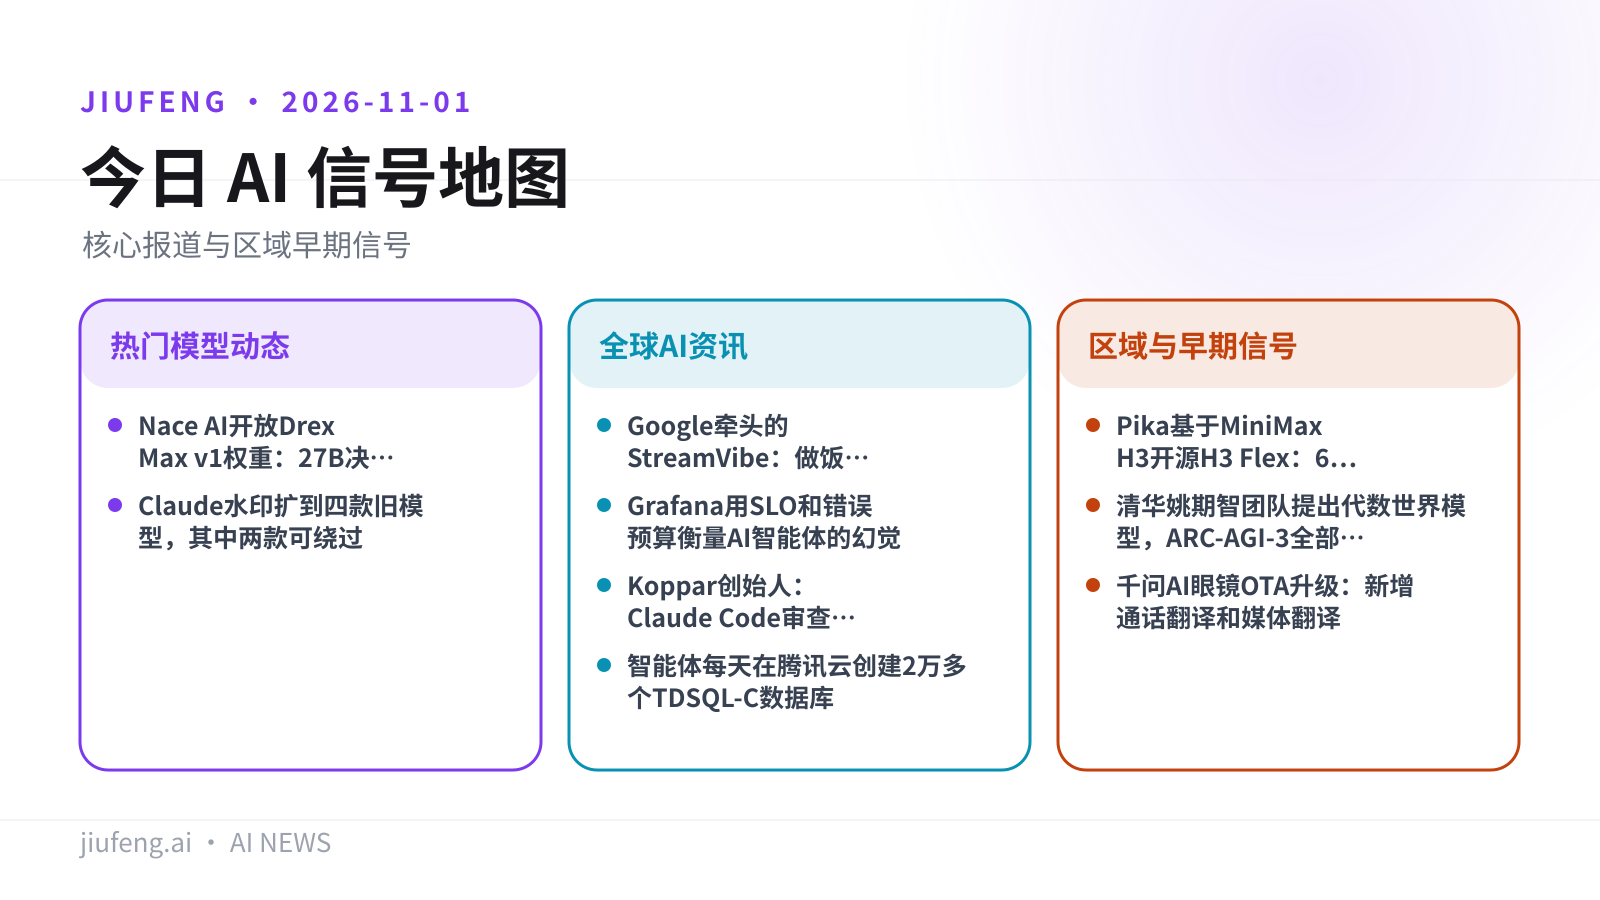
本期共 9 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · Nace AI 开放 Drex Max v1 权重:27B 决策模型,Mac 上可本地跑
- 重点 · Claude 水印扩到四款旧模型,其中两款可绕过
全球 AI 资讯
- 重点 · Google 牵头的 StreamVibe:做饭、装家具时只在需要时开口的视频智能体
- Grafana 用 SLO 和错误预算衡量 AI 智能体的幻觉
- Koppar 创始人:Claude Code 审查发现了电气检查漏掉的 LTE 调制解调器板错误
- 智能体每天在腾讯云创建 2 万多个 TDSQL-C 数据库
区域与早期信号
- Pika 基于 MiniMax H3 开源 H3 Flex:6 步去噪同时生成音视频
- 清华姚期智团队提出代数世界模型,ARC-AGI-3 全部 183 关通关
- 千问 AI 眼镜 OTA 升级:新增通话翻译和媒体翻译
九凤根据本期已引用来源整理。
热门模型动态
01/09
Nace AI 开放 Drex Max v1 权重:27B 决策模型,Mac 上可本地跑
Nace AI 开放了旗下能力最强的决策模型 Drex Max,路由、分类和策略检查都能在本地机器上完成。
这次放出了 bf16 权重、Q8_0 GGUF、affine Q4 checkpoint,以及 llama.cpp 和 Ollama 的分支。
- 规模:稠密 27B 参数,多模态
- 许可证:Nace.AI Open RAIL-M
- 上下文:262,144 token(默认 16,384)
- 输出:每题最多 255 个选项
- 硬件:bf16 用 NVIDIA H100,8-bit 用 48GB L40S;Apple Silicon 24GB 以上跑 affine Q4,48GB 跑 Q8_0 GGUF;CPU 可用 llama.cpp 和 Ollama
- 成绩:Decision Index v0.4 得分 67.52;InfographicVQA 97.3,Tools 类 81.9
局限:Decision Index 分数由 Nace AI 自报。报道里 Drex v2.0 的 61.25 分是 v0.3.1 版指数的成绩,和 Drex Max 的 v0.4 分数版本不同,不能直接对比。
图片来源:huggingface。
来源:有原始出处 Hugging Face:drex-max-v1-Q8_0 · MarkTechPost
02/09
Claude 水印扩到四款旧模型,其中两款可绕过
Anthropic 给 Mythos 5、Opus 4.7、Opus 4.6 和 Sonnet 4.6 加上文本水印,但在 Opus 4.6 和 Sonnet 4.6 上,水印只在默认设置下生效。
Anthropic 在发给 API 客户的邮件里说,将给 Claude Mythos 5、Claude Opus 4.7、Claude Opus 4.6 和 Claude Sonnet 4.6 加水印,目的是赶上欧盟《AI 法案》12 月的期限。Claude Opus 5.5 等较新的模型已经带水印,Amazon Bedrock 上可能晚几天上线。
Anthropic 称,水印是一种「用词上不可察觉的模式」,不改变含义、质量和可读性,不增加字符或 token,不影响价格和请求/响应格式,对输出速度影响很小,也不包含用户、组织或对话的信息。水印可以用一个处于私测阶段的检测 API 验证。
局限:The Decoder 报道,在 Opus 4.6 和 Sonnet 4.6 上,水印只在默认采样设置下生效,API 用户改一个采样参数就能避开。
来源:单一报道 The Decoder
全球 AI 资讯
03/09
Google 牵头的 StreamVibe:做饭、装家具时只在需要时开口的视频智能体
研究团队想让视频助手听懂「遇到困难就帮我」这类模糊请求,测试结果显示现有模型离这一点还很远。
来自 Google、斯坦福、牛津和几所美国大学的研究者发布了 StreamVibe。论文指出,现有视频助手是为「水开了告诉我」这类明确指令设计的,很少能察觉用户没说出口的意图,也难以记住哪些步骤已经做完,因此会重复建议或回应太晚;用户中途改要求时,它们还常常照着最初的指令走。StreamVibe 把任务中的用户意图分成三类:明说的、没说出口的、中途变化的。
局限:这是研究原型,不是产品。The Decoder 的总结是,测试首先说明了「何时开口」对今天的模型有多难,参评模型没有一个做好。
来源:有原始出处 arXiv 论文 · The Decoder
04/09
Grafana 用 SLO 和错误预算衡量 AI 智能体的幻觉
Grafana Labs 把 SRE 常用的 SLO 和错误预算用到智能体行为上,把幻觉、任务完成度、毒性和成本变成可以持续监控的指标。
做法分两步。第一步是评估:逐次检查每次交互是否有依据、是否完成了请求、是否含有毒内容、是否泄露个人信息、是否受到提示词注入影响,可以用 LLM 当裁判,也可以用正则这类确定性检查。第二步把评估结果转成 SLI,对照 SLO 衡量。Grafana 举的例子是:30 天内 95% 的对话被判定完成了用户请求,剩下的 5% 就是错误预算。Grafana 不主张合成一个单一的「质量分」,而是每个维度分别设目标。
局限:这是方法建议,原文没有给出生产环境的效果数据。用 LLM 当裁判时,评估本身也可能出错。
来源:多家媒体报道 InfoQ 中文 · InfoQ(英文)
05/09
Koppar 创始人:Claude Code 审查发现了电气检查漏掉的 LTE 调制解调器板错误
一块 AI 设计的 LTE 调制解调器板通过了 Koppar 的电气检查,但 1-2 小时的 Claude Code 审查加上人工目检,又找出了天线、元件和布局问题。
Koppar 创始人 Abijah Kajabika 说,送去制板的是修订后的版本,审查发现的问题已全部修正,物料清单也已更正。他预计 11 月 5-6 日拿到组装好的板子和散装模组,之后手工焊接、上台测试,计划在下一周公布结果。
局限:板子还没造出来,也没测过,实际性能尚未验证。RuntimeWire 11 月 1 日更正过报道:初版说射频走线和 SIM 位置没有改动,创始人澄清所有修正都已应用。
来源:有原始出处 GitHub:koppar-lte-modem · RuntimeWire
06/09
智能体每天在腾讯云创建 2 万多个 TDSQL-C 数据库
腾讯云称,由智能体创建的 TDSQL-C 实例每天超过 2 万个,增长超过 80 倍。
腾讯云给出的数字:智能体每天创建超过 20,000 个 TDSQL-C 数据库实例,增长超过 80 倍,活跃实例超过 100 万。报道还提到,WorkBuddy 用户李宁目前运行约 50 个智能体,计划一年内增加到 200 个。
局限:数字由腾讯云自报,未经第三方核实。
来源:单一报道 Pandaily
区域与早期信号
07/09
Pika 基于 MiniMax H3 开源 H3 Flex:6 步去噪同时生成音视频
Pika 开放两套 LoRA 适配器和推理代码,把 MiniMax H3 的 50 步去噪蒸馏到 6 步。
- 输入:文本、首尾帧、多模态参考
- 输出:原生 480P、768P,约 5-15 秒视频,带同步立体声
- 接入:ComfyUI 工作流、Hugging Face Diffusers
- 训练:先在内部音视频数据上做监督微调,再用投影分布匹配蒸馏(PDMD)把 50 步压到 6 步,最后用奖励反馈学习和 DPO 训练 LoRA
- 托管推理:8 张 B300 生成 5 秒 768P 音视频,总耗时从 3.409 秒降到 2.129 秒,约快 1.6 倍
- 榜单:DesignArena 文生视频榜第 8,是该榜排名最高的开源视频模型
局限:1080P/2K/4K 增强和五类音轨分离(对白、配乐、音效、拟音、环境声)只通过 Pika API 服务提供,不在开源范围内。五项质量指标领先是 Pika 自己公布的对比。本条依据雷锋网的中文报道。
来源:单一报道 雷锋网
08/09
清华姚期智团队提出代数世界模型,ARC-AGI-3 全部 183 关通关
AWM 把游戏里的对象、关系和规则抽象成代数结构,能证明某一关「不可能」通关,并说出还差几步。
清华大学姚期智、袁洋团队提出了代数世界模型(AWM)。研究人员把 ARC-AGI-3 的 sc25 关卡改成步数不够、无法通关。在 12 次类似测试里,GPT-6 Astra 和 Claude Opus 5.5 加起来只有 5 次判断出「不可能」,其中 4 次给出的最少步数还是错的。基于 Opus 5.5 的 AWM 试了两次就证明这一关无解,并指出再多一步就能赢。使用 Opus 5 时,AWM 通关全部 183 关,得分 99.9%,平均动作数是人类基准的 43%。
局限:「不可能」测试只有 12 次,样本小。本条依据量子位的中文报道。
来源:单一报道 量子位
09/09
千问 AI 眼镜 OTA 升级:新增通话翻译和媒体翻译
千问 AI 眼镜可以实时翻译电话、线上会议,以及外语播客、网课和影片。
11 月 1 日的 OTA 升级新增通话翻译和媒体翻译(译文同步显示在千问 AI 穿戴 App 上),还加强了嘈杂环境下的语音识别。千问 AI 眼镜 G1 今年 3 月开售,之后推出了旗舰款 S1;10 月发布的 N1 系列支持换电池,Pro 版支持眼动交互和全天候健康监测,2899 元起。
局限:报道没有列出支持的语种和延迟数据,也没有说明哪些型号能收到这次升级。本条依据 IT之家的中文报道。
来源:单一报道 IT之家
本文由 AI 根据文中所附信源整理,经自动事实核查后发布,发布前未经人工逐篇审核;如与原文不一致,以原始出处为准。了解本日报的制作方式或报告错误:关于本日报