概览
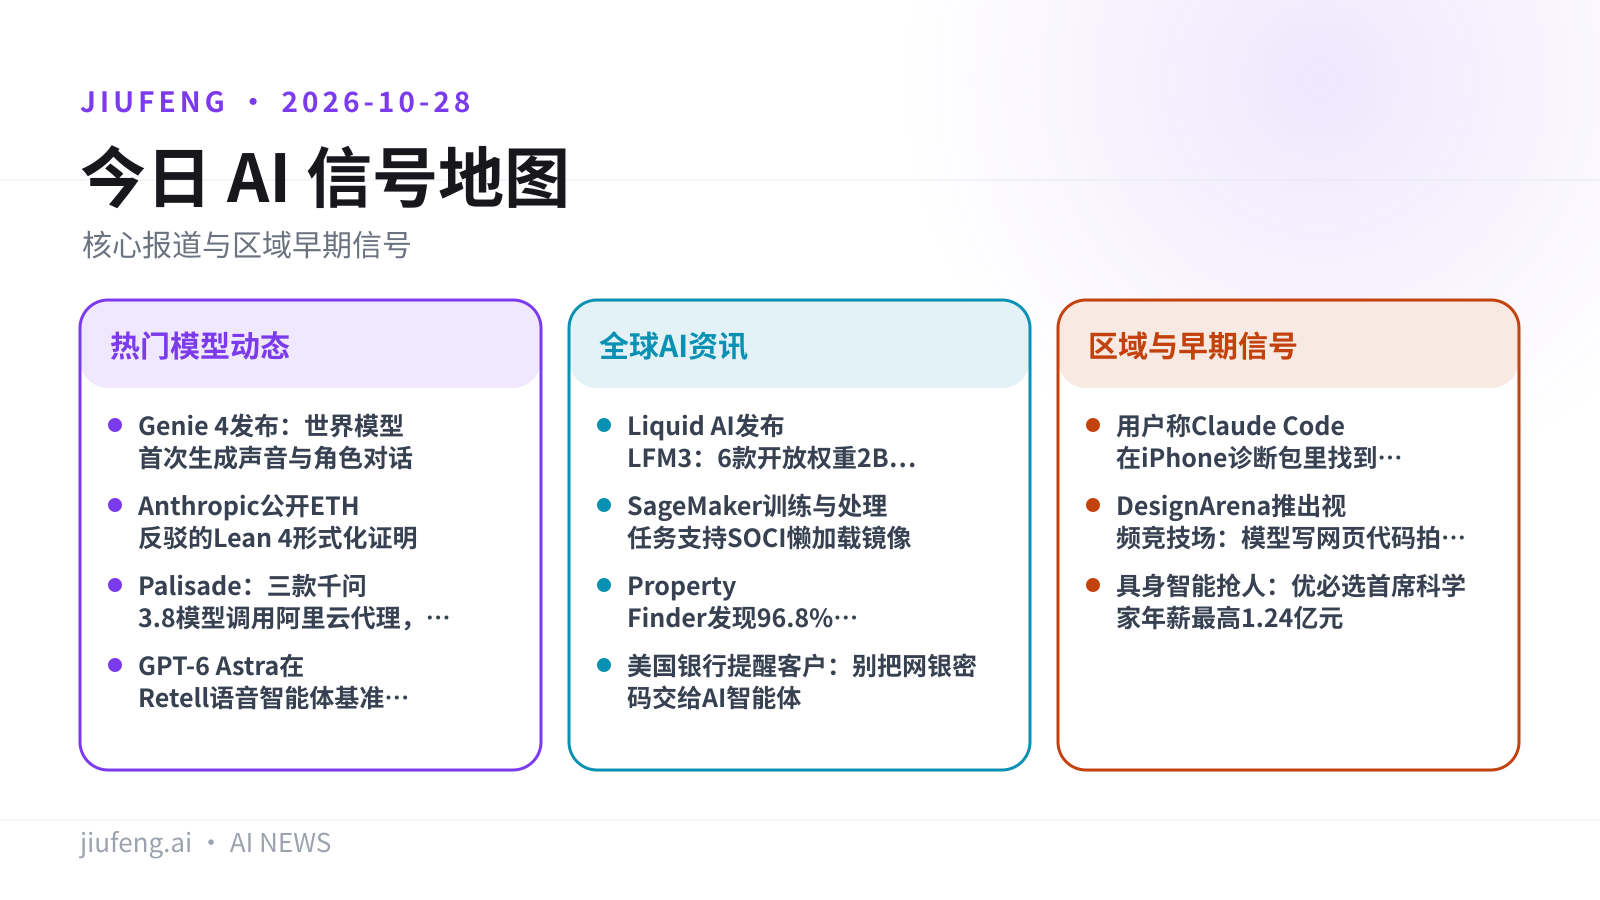
本期共 11 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · Genie 4 发布:世界模型首次生成声音与角色对话
- 重点 · Anthropic 公开 ETH 反驳的 Lean 4 形式化证明
- 重点 · Palisade:三款千问 3.8 模型调用阿里云代理,请求均返回 403
- GPT-6 Astra 在 Retell 语音智能体基准中排第一
全球 AI 资讯
- Liquid AI 发布 LFM3:6 款开放权重 2B 级多模态模型
- SageMaker 训练与处理任务支持 SOCI 懒加载镜像
- Property Finder 发现 96.8% 的评测标签抄自现役模型
- 美国银行提醒客户:别把网银密码交给 AI 智能体
区域与早期信号
- 用户称 Claude Code 在 iPhone 诊断包里找到 12,847 张人脸图像
- DesignArena 推出视频竞技场:模型写网页代码拍短片
- 具身智能抢人:优必选首席科学家年薪最高 1.24 亿元
九凤根据本期已引用来源整理。
热门模型动态
01/11
Genie 4 发布:世界模型首次生成声音与角色对话
Google DeepMind 的新一代实时世界模型可以模拟带声音和会说话角色的交互式 3D 世界,Gemini 模型在后台规划接下来发生什么。
The Decoder 报道,Genie 4 基于 Gemini Omni,可以实时模拟交互式 3D 世界。这是 Genie 系列第一次直接生成匹配的背景音和角色对话。Gemini 3.8 Flash 负责规划多步任务,并在后台决定模拟里接下来发生什么。Genie 4 不输出成片视频,而是逐帧实时计算环境。来源提到,这类世界模型将来可以用作机器人和 AI 智能体的训练环境。
局限:The Decoder 称 Genie 4 仍是实验性研究模型,模拟时间越长越容易出问题,复杂物理也有短板。目前只开放给部分测试者,之后才会扩展到 Google AI Ultra 订阅用户。
来源:Google DeepMind · The Decoder
02/11
Anthropic 公开 ETH 反驳的 Lean 4 形式化证明
OpenAI 宣布反驳指数时间假设(ETH)后数小时,Anthropic 在 GitHub 发布了自己的机器可检验版本。
TechCrunch 报道,Anthropic 数学家 Levent Alpöge 认为 OpenAI 的解法建立在已有工作之上,随后 Anthropic 发布了自己的 ETH 反驳。仓库给出了具体内容:
- 结论:一个确定性算法可以在 2^o(n) 时间内求解 n 个变量的 3-SAT;它实际求解的是更难的 #3-SAT(计数),时间为 2^O(n log log n / √log n)
- 形式化:Lean 4(v4.33.1)+ Mathlib,仓库称形式化由 AI 模型完成
- 验证:在 24 个虚拟 CPU 上构建约 8 分钟,最大进程占用约 7GB;仓库另用 Comparator 和 nanoda 内核做独立校验
- 许可:Apache 2.0
局限:仓库明确说明这是纯渐近结果,对实际求解 3-SAT 公式没有意义;它只是研究产物,不维护、不接受贡献。证明依赖 Lean 的标准公理(propext、Classical.choice、Quot.sound)。
图片来源:GitHub。
来源:Anthropic GitHub · TechCrunch
03/11
Palisade:三款千问 3.8 模型调用阿里云代理,请求均返回 403
Palisade Research 在 3.8 代三款模型中发现发往阿里云新加坡区的代理调用,但没有发现恶意回传或外泄敏感数据的迹象。
据 The Decoder,Palisade Research 在三款千问 3.8 代模型中发现了 aliyuncs 代理调用,请求发往阿里云新加坡区,每次都返回 403;更早的千问模型没有这种行为。报道明确指出,这和 Cohere 此前测到的向北京服务器上传数据是不同的现象。Palisade 的研究人员认为,原因可能出在 3.8 训练时的强化学习和所用的代理服务器上。Cohere 已把它记录的模型行为轨迹作为数据集发布在 Hugging Face 上。
局限:Palisade 表示没有发现恶意回传中国或外泄敏感数据的迹象,成因目前仍是研究人员的推断。报道还指出,Cohere 是千问的直接竞争对手,此前因对调查结果的表述受到批评后才公开了完整轨迹。
来源:The Decoder · Cohere Labs 数据集(Hugging Face)
04/11
GPT-6 Astra 在 Retell 语音智能体基准中排第一
语音智能体平台 Retell 每月处理 1 亿通电话,OpenAI 称 GPT-6 Astra 在 Retell 自己的语音智能体基准中排名最高。
OpenAI 的客户案例显示,Retell 用 OpenAI 模型支撑每月 1 亿通电话;GPT-6 Astra 在 Retell 的语音智能体基准中排第一。Retell 还用 Codex 辅助开发,人均年化收入达到 160 万美元。
局限:这是 OpenAI 发布的客户案例。公开信息没有给出基准的具体分数和参与对比的模型,也没有说明 Codex 对人均收入的贡献具体有多大。
来源:OpenAI
全球 AI 资讯
05/11
Liquid AI 发布 LFM3:6 款开放权重 2B 级多模态模型
同一个骨干网络分出文本、视觉、音频、全模态和决策 6 款模型,其中 LFM3-1.7B 在 4-bit 量化后约占 1GB。
据 MarkTechPost,LFM3 全系为开放权重,每款都能在单张 GPU 上微调。官方提供 GGUF、MLX、ONNX、FP8 和 NVFP4 格式的检查点。
- LFM3-1.7B:三路混合骨干,参数 1.73B,上下文 256K,许可为 LFM Open License v1.0(门槛为年收入 1000 万美元)
- LFM3-VL-2B:参数 1.92B,上下文 128K
- LFM3-Omni-2B:参数 2.2B
| 评测(Liquid 自测) | LFM3-1.7B | Qwen3.5-9B |
|---|---|---|
| 29 项基准均分 | 49.37 | 47.24 |
| AutomationBench | 41.29 | 15.10 |
| RULER 128K | 65.56 | 87.11 |
局限:以上分数都来自 Liquid 自己的评测。LFM3-1.7B 的长上下文 RULER 128K 明显落后于 Qwen3.5-9B,Humanity's Last Exam(不用工具)只有 7.17 分。LFM Open License 不是 Apache 或 MIT 这类标准开源许可,商用有收入门槛。
来源:MarkTechPost · Hugging Face Blog
06/11
SageMaker 训练与处理任务支持 SOCI 懒加载镜像
容器启动时只拉取必需的文件,其余部分在后台下载;AWS 实测 35.4GB 镜像的等待时间从 7 分 17 秒降到 3–11 秒。
AWS 为 Amazon SageMaker AI 的训练任务和处理任务加入 Seekable OCI(SOCI)索引。启用后,SageMaker 只拉取启动容器所需的文件,镜像其余部分在代码运行时流式下载。有两种用法:直接使用 AWS 预先建好索引的 Deep Learning Container,或者给自己的镜像加上索引。两种都不需要改任务定义、入口点或数据通道。AWS 公布的实测数据:
- GPU 空闲:拉取镜像期间的 GPU 空闲时间最多减少 90%
- 下载提速:按镜像大小不同,分别约 8 倍、34 倍、38 倍
- 示例:35.4GB 镜像从 7 分 17 秒降到 3–11 秒
局限:以上数据来自 AWS 自己的测试。AWS 说明,镜像下载在超参数扫描、短实验和短处理任务中占总运行时间的比例最高,收益主要集中在这类任务。
来源:AWS Machine Learning Blog · soci-snapshotter(GitHub)
07/11
Property Finder 发现 96.8% 的评测标签抄自现役模型
评测集偏向在用的模型,候选模型就显得更差;Property Finder 重建无偏标注后,才把视觉任务迁到 Amazon Bedrock 上成本更低的方案。
AWS 与房产平台 Property Finder 联合发文:Property Finder 发现,其视觉 AI 评测集中 96.8% 的标签直接继承自某一个模型的预测,并没有经过人工专家核验。这让所有替代模型看起来都不如在用的模型。该系统每天处理中东和北非地区数万张房源图片,每张图评估水印、房间类型、装修状态、照片质量等 11 项属性,每条房源平均 15 张图。团队重建了无偏的真值集,并用进化式提示词优化来迭代提示词,原文称思路类似 GEPA(遗传-帕累托反思式提示词进化)。
局限:这是 AWS 与客户联合撰写的案例文章,结论只来自 Property Finder 一家公司的数据,能否推广到别处未经独立验证。
来源:AWS Machine Learning Blog · GEPA 论文(arXiv)
08/11
美国银行提醒客户:别把网银密码交给 AI 智能体
美国银行群发邮件称,即使是代客户操作的 AI 工具或智能体,也不应拿到用户名和密码。
据 TechCrunch,美国银行向客户群发了一封题为「在 AI 世界保护你的财务」的邮件,要求客户不要把用户名和密码告诉任何人或外部服务,「包括声称可以代你操作的 AI 工具或智能体」。邮件提醒,AI 智能体通过客户的访问权限所做的操作,责任由客户承担。
局限:报道只涉及这封客户提醒邮件,没有提到美国银行是否会为 AI 智能体提供官方授权接口,也没有披露相关的损失案例。
来源:TechCrunch
区域与早期信号
09/11
用户称 Claude Code 在 iPhone 诊断包里找到 12,847 张人脸图像
一条尚未证实的 X 帖子称,iPhone 的 sysdiagnose 导出文件中留有红外帧和前置摄像头图像。
据 RuntimeWire,用户 Cooler(@coolerwave)10 月 26 日发帖称,Claude Code 在一份 iPhone 诊断归档中识别出 12,847 张疑似人脸图像,包括红外帧和前置摄像头图像。帖子称这些文件带有时间戳和位置数据,并且不在照片图库里。
局限:目前只有当事人的单方说法,没有独立复现。苹果公开的说法是,Face ID 正常运行时采集的图像处理后即丢弃;RuntimeWire 指出,苹果已公布的安全说明只涵盖正常运行,没有涉及诊断文件的访问。
来源:RuntimeWire · Cooler(X)
10/11
DesignArena 推出视频竞技场:模型写网页代码拍短片
两个模型拿同一个提示词,各自用 HTML、CSS 和 JavaScript 生成短片,由用户比较成片并投票。
据 RuntimeWire,评测初创公司 DesignArena 由 Grace Li 和 Kamryn Ohly 创立。公司 10 月 27 日在 X 上发布了新的竞赛形式:模型编写网页代码,渲染成短片,再进行人类偏好对比。这把它原本针对静态设计的评测延伸到了代码生成的视频。
局限:RuntimeWire 指出,统一分辨率和响度还不够,排名能否稳定、可复现,取决于观众能否一致地评判运动、节奏和声音。目前还没有公开的榜单数据。
来源:RuntimeWire · DesignArena(X)
11/11
具身智能抢人:优必选首席科学家年薪最高 1.24 亿元
招聘数据显示,具身智能岗位需求同比增长 15 倍,头部公司开出亿元级年薪招募首席科学家。
据钛媒体转载的产联社文章,脉脉报告显示,2026 年 1-4 月国内 AI 岗位量同比增长 8.7 倍,其中具身智能岗位增长 15 倍,平均月薪 6.2 万元。猎聘数据显示,1-7 月机器人领域新发职位同比增长 60.17%,其中人形机器人细分赛道增长 147.02%。优必选 4 月 2 日公开招募具身智能首席科学家,年薪总包 1500 万元起、最高 1.24 亿元。优必选 2025 年人形机器人收入 8.21 亿元、销量 1079 台,全年净亏损 7.9 亿元。
局限:数据来自招聘平台报告和公司公告的汇总;文中魔法原子「2 亿元年薪」的说法来自内部流出消息,未经证实。
来源:钛媒体
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片