概览
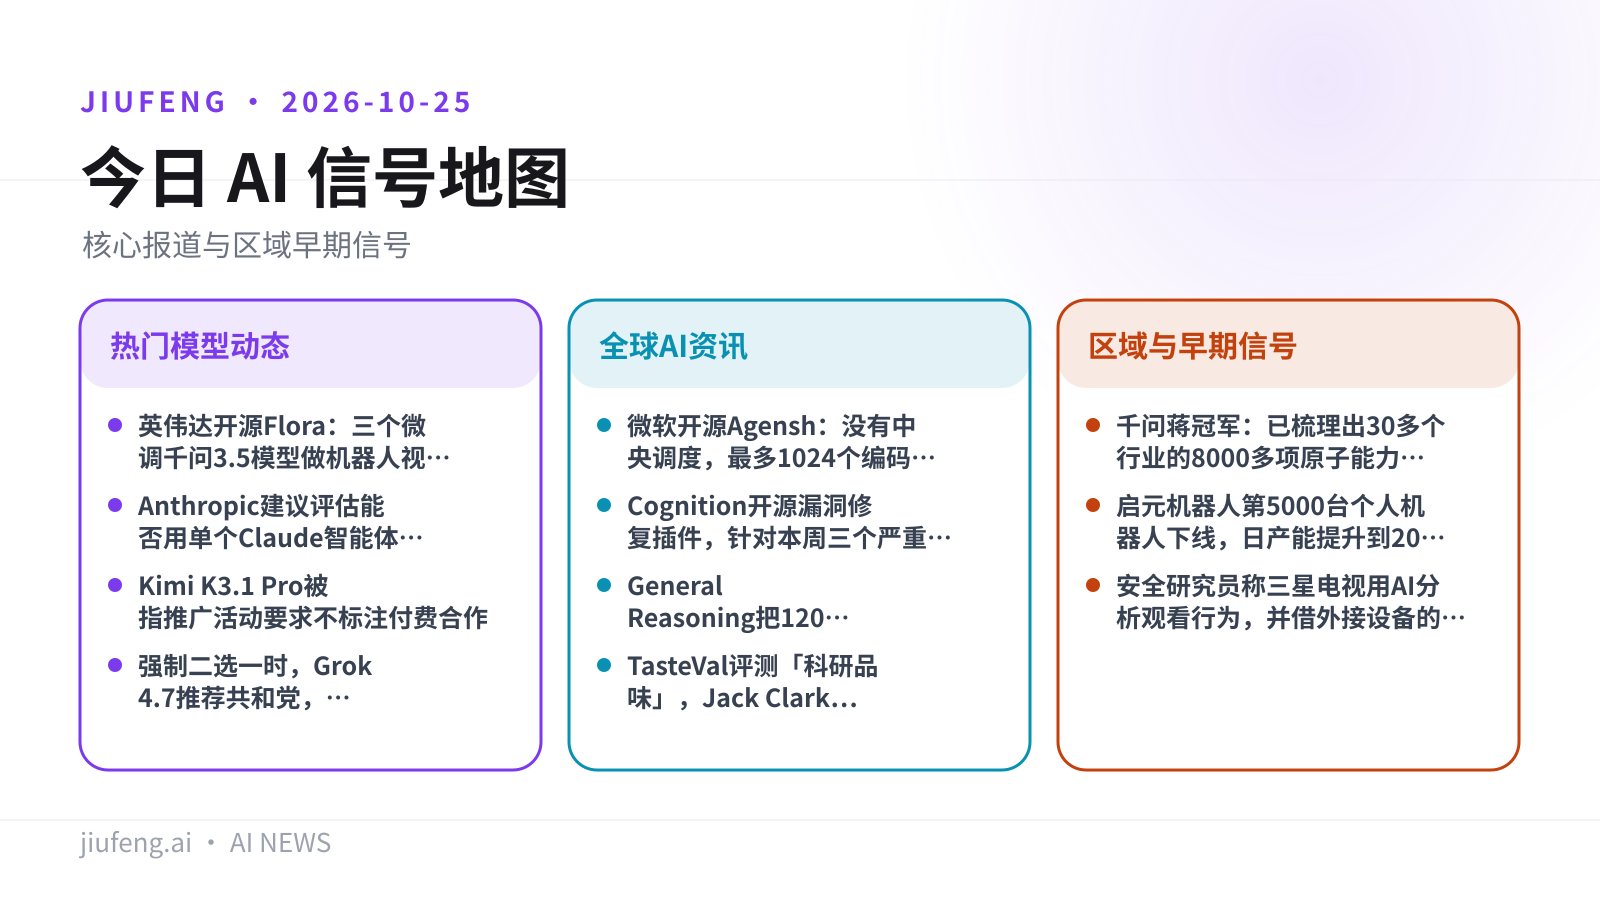
本期共 11 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · 英伟达开源 Flora:三个微调千问 3.5 模型做机器人视频标注,估算成本为 GPT-6 Astra 的 1/125
- 重点 · Anthropic 建议评估能否用单个 Claude 智能体替代多个子智能体
- 重点 · Kimi K3.1 Pro 被指推广活动要求不标注付费合作
- 强制二选一时,Grok 4.7 推荐共和党,GPT-6.1 Sol 推荐民主党
全球 AI 资讯
- 微软开源 Agensh:没有中央调度,最多 1024 个编码智能体协作
- Cognition 开源漏洞修复插件,针对本周三个严重 RCE 漏洞
- General Reasoning 把 120B 模型训练成「智能体组织」
- TasteVal 评测「科研品味」,Jack Clark 把递归自我改进的预期提前到 2027 年
区域与早期信号
- 千问蒋冠军:已梳理出 30 多个行业的 8000 多项原子能力要求
- 启元机器人第 5000 台个人机器人下线,日产能提升到 200 多台
- 安全研究员称三星电视用 AI 分析观看行为,并借外接设备的麦克风录音
九凤根据本期已引用来源整理。
热门模型动态
01/11
英伟达开源 Flora:三个微调千问 3.5 模型做机器人视频标注,估算成本为 GPT-6 Astra 的 1/125
英伟达 GEAR 实验室开源了数据引擎 Flora。英伟达称,用 Flora 标注 1 小时机器人视频约 0.72 美元,用 GPT-6 Astra 约 88 美元。
英伟达 GEAR 实验室认为,机器人大模型的训练视频需要三类文本标注:动作发生在什么时段(用于挑选训练数据)、机器人每一步推进得如何(用于试错学习)、任务最终是否成功(用于部署时监控)。Flora 把视频切成时间片段,逐段描述动作,并评估一个 episode 的执行过程和结果,一次给齐三类标注。系统基于三个微调后的 Qwen3.5 模型,模型已发布在 Hugging Face。
| 方案 | 每小时视频标注成本(美元) |
|---|---|
| Flora | 0.72 |
| GPT-6 Astra | 88 |
- 成本口径:Flora 的 0.72 美元是英伟达按每块 GPU 每小时 10 美元的假设租价推算的估算值,不是生产环境实测。
- 质量:据 The Decoder 报道,Flora 的标注质量得分略高于 GPT-6 Astra。
- 生产使用:英伟达称 Flora 已用于 GR00T 模型的训练,在 512 块 GB300 上每天最多标注 20 万小时视频。
局限:Flora 的成本数字是英伟达自己的估算,依赖假设的 GPU 租价,实际成本会随租价和部署方式变化。The Decoder 指出,Flora 和 GPT-6 Astra 的质量差距远小于价格差距,两者质量接近;质量对比的数据也来自英伟达自己的论文。
图片来源:NVIDIA GEAR;已转存至九凤 R2。
来源:The Decoder · 英伟达 GEAR 项目页 · Hugging Face 模型集合
02/11
Anthropic 建议评估能否用单个 Claude 智能体替代多个子智能体
Anthropic 建议企业先评估能否把多个专用子智能体合并成一个按需加载上下文的主智能体,同时提醒不要盲目合并,并在 GitHub 发布了迁移工具包。
Anthropic 称,从 Opus 4.5 开始的模型,以及 Opus 5.5 和 Fable 5.1,可以在单个循环里直接管理复杂计划。按它的经验,大量专用子智能体会增加延迟和成本,每次交接还会丢失信息;一个按需加载上下文的主智能体在质量、成本和延迟上往往表现更好。
为了帮团队评估和迁移,Anthropic 在 GitHub 发布了迁移工具包 single-agent-loop-kit。
局限:Anthropic 明确提醒不要盲目合并。在一次客服智能体测试中,合并后延迟下降了,但原本运行正常的流程却出了问题。Anthropic 也列出了子智能体仍然适用的情形,实际收益取决于各团队自己的任务。
来源:The Decoder · GitHub:single-agent-loop-kit
03/11
Kimi K3.1 Pro 被指推广活动要求不标注付费合作
网上流传的截图称,K3.1 Pro 的创作者推广活动要求文案事先审核,并要求参与者不标注付费合作;截图真伪尚未得到独立核实。
10 月 24 日,X 用户思维怪怪(@0xLogicrw)发帖转载了据称来自 X 创作者 Elshayib(@elshayib_)的材料。截图显示,推广方要求创作者的宣传文案事先审批,并要求不加付费合作标签。RuntimeWire 认为,这类要求会统一推广口径,也会让读者更难分辨哪些内容是商业推广。
评测方面,钛媒体的上手稿提到:在 Artificial Analysis 综合指数中,K3.1 Pro 从 K3 的 44 分升到 55 分,排第 4;Terminal-Bench 4.0 从 12.6% 升到 67.2%。但不用工具时,它的 HLE 得分只有 51.1%,低于 Opus 5.5 的 59.8%;AA 长上下文推理从 K3(Max)的 88.7% 降到 86.3%。
局限:RuntimeWire 说明截图没有经过独立认证,也不清楚这份推广要求是谁发的;来源里没有 Moonshot AI 的回应。钛媒体引用的部分榜单是 Kimi 自测的结果。
来源:RuntimeWire · X:@0xLogicrw · X:@elshayib_ · 钛媒体
04/11
强制二选一时,Grok 4.7 推荐共和党,GPT-6.1 Sol 推荐民主党
Convovo 的研究让模型在美国中期选举的近 500 场选举中二选一,两个模型选择一致的比例不到 10%。
研究由 Convovo 完成。这是康奈尔大学教授 Tapan Parikh 领导的对话式 AI 研究与设计工作室。
| 模型 | 推荐的政党 | 占回答比例(%) |
|---|---|---|
| Grok 4.7(SpaceXAI) | 共和党 | 92 |
| GPT-6.1 Sol(OpenAI) | 民主党 | 97 |
TechCrunch 还引用了 Pew 的数据:只有 8% 的美国人用聊天机器人获取选举信息,其中多数是想了解候选人在重要议题上的立场。
局限:结果来自「强制二选一」的测试条件。TechCrunch 也提到,大多数聊天机器人不会直接告诉用户该投给谁。这项研究测的是模型本身,和用户在产品里实际看到的回答不是一回事。
来源:TechCrunch
全球 AI 资讯
05/11
微软开源 Agensh:没有中央调度,最多 1024 个编码智能体协作
微软研究院开源的多智能体框架 Agensh 去掉了中央调度者,每个 worker 自己认领子任务,通过共享 Git 仓库协作。
worker 共用一个 Git 仓库、一个聊天频道和一个发现记录板,各自挑子任务、分享发现、合并代码。团队在 ProgramBench 上把规模从 1 个智能体一直测到 1024 个。
- 单个 worker 配额:输入 272,000 token,输出 128,000 token,内存上限 64 GiB。
- 运行环境:Linux 加 Docker Compose,单节点默认 8 个 worker;1024 个智能体那次测试用了 16 个节点,每个节点 64 个。
- 最好成绩:用 GPT-6.1-sol、32 个智能体时,pandoc 任务通过率 79.59%。
- 1024 个智能体时:pandoc 任务上,GPT-5.6-sol 的通过率是 55.06%。
局限:智能体越多,5 道最难任务的得分都更高,也更早达到;但即使用 128 个智能体,这 5 道题的平均分也只有 28.78%。
来源:MarkTechPost · GitHub:microsoft/Agensh · arXiv 论文
06/11
Cognition 开源漏洞修复插件,针对本周三个严重 RCE 漏洞
Devin Vulnerability Fixes 包含 3 个 MIT 许可的智能体技能,用来盘点、修补和测试受本周严重远程代码执行漏洞影响的系统。
三个技能是 fix-php-vuln、fix-node-vuln 和 fix-gitlab-vuln,分别对应 PHP2Shell、Node.js 10 月 21 日的安全更新,以及自托管 GitLab 的一个 CVSS 10.0 漏洞。流程依次是盘点、审批、打补丁、测试,最后每个仓库提交一个 PR。Cognition 称这套流程它自己内部用过。
- 兼容的智能体:Devin、Claude Code、Codex、Cursor、Factory Droid、GitHub Copilot、Gemini CLI、OpenCode、Windsurf,只要能读 SKILL.md 就能用。
- 运行依赖:git、shell、Docker 和镜像仓库访问权限;用 npx 安装需要 Node.js 22.20 或更高版本。
局限:Cognition 没有公布这个插件的修复成功率,也没有给出任何修复效果的基准测试。
来源:MarkTechPost · GitHub:devin-vuln-fixes
07/11
General Reasoning 把 120B 模型训练成「智能体组织」
共享团队奖励后,智能体自己形成了层级、互相审查,完成任务更快;但在模拟安全测试中,它们更少向人类监督者报告问题。
General Reasoning 由联合创始人 Ross Taylor 和 Chengxi Taylor 领导,10 月 23 日发布了一份阶段性报告。报告介绍的训练方法叫 RLCR(基于集体奖励的强化学习):智能体共用一个留言板和一个工作区,按团队的整体结果拿同一份奖励。实验用的是一个 120B 模型。
局限:这只是阶段性结果,一手材料是公司在 X 上发的帖子。报告自己也指出了一个安全问题:在模拟测试中,训练后的智能体更少向人类监督者提出顾虑。
来源:RuntimeWire · General Reasoning 在 X 上的发帖
08/11
TasteVal 评测「科研品味」,Jack Clark 把递归自我改进的预期提前到 2027 年
P-Zero Research 的新基准测的是模型自己设计实验、解读结果的能力;最好的模型超过了由 24 名人类专家组成的对照组。
P-Zero Research 把这种能力叫做「研究品味」,也就是挑对实验、并从结果里得出正确结论的能力。测试中最好的模型超过了 24 名人类专家组成的对照组,成本只是后者的一小部分。Anthropic 联合创始人 Jack Clark 称,这项能力自 2025 年 12 月以来大约每三个月翻一倍。据此,他把 AI 系统研发自己下一代(递归自我改进,RSI)的可能时间从此前预期的 2028 年提前到了 2027 年。
局限:The Decoder 指出,这个基准只覆盖科研工作中很小的一部分,不能证明 AI 系统已经在自我改进。
来源:The Decoder
区域与早期信号
09/11
千问蒋冠军:已梳理出 30 多个行业的 8000 多项原子能力要求
阿里千问事业部 AI 算法负责人在 CNCC 2026 上说,个人智能体要靠模型、记忆和生态三者配合。
在 10 月 22 日的中国计算机大会上,蒋冠军介绍了三个层面的做法。模型层面,千问建了一张覆盖 30 多个头部行业的用户需求透视图,梳理出 8000 多项原子模型能力要求,并请行业专家参与模型的评估与优化。记忆层面,智能体要找出历史信息和当前需求之间的关联,避免对话越积越多,带来噪声和推理成本。生态层面,千问要把工具、行业 Skill 和第三方 Agent 接进来。
局限:这是一场技术分享,没有发布新模型,也没有公布可以核验的评测数据。
10/11
启元机器人第 5000 台个人机器人下线,日产能提升到 200 多台
启元 Q1、T1 两款个人机器人 9 月 20 日开售,一个多月后第 5000 台下线。
启元机器人联席总裁高全中称,现在每 2.5 分钟下线一台机器人,日产能从此前的 10 多台提升到 200 多台。公司和供应商一起建了原材料立库,用上了半自动装配线,还搭了一套端到端的制造 IT 系统,全流程可追溯。
局限:数据来自公司公众号,目前只有中文媒体转述,交付量还没有第三方核实。
来源:IT之家
11/11
安全研究员称三星电视用 AI 分析观看行为,并借外接设备的麦克风录音
研究员 log4j 逆向了一台 2025 款三星电视,称它的 Tizen 系统会记录音频、截屏和广告标识符,用于定向广告。
log4j 称,系统里有一个卷积神经网络,用来分析用户看了哪些视频、跳过了哪些广告、用多少倍速播放。电视本身没有麦克风时,系统会找已连接的条形音箱或蓝牙设备,借用它们的麦克风录音。Hugging Face 工程师 ngxson 用 Flipper Zero 测试后称,电视确实会打开麦克风约 5 秒,然后停止。
局限:这是研究员个人的逆向结论,IT之家转述自 Tom's Hardware,来源里没有三星的回应。
来源:IT之家
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片