概览
本期共 10 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · Claude Haiku 5.5 OSWorld 升至 72.4%,Artificial Analysis 小模型榜第一
- 重点 · GPT-6 开始进入 ChatGPT 聊天页,OpenAI 称 Codex 与 Work 合计 4000 万活跃用户
- 重点 · Scale AI 发布视觉推理基准 HSS,最好的模型 GPT-6 Astra 只答对 53.6%
全球 AI 资讯
- Architect 推出 Liquid Inference,每次 LLM 请求都实时拍卖
- 微软给 Copilot 开放本地文件和跨系统操作,主打「混合智能」
- 英伟达等提出 PivotOPD,训练多轮智能体避开并纠正关键早期错误
- AWS 放出 DevOps Agent 诊断后的自动修复方案
- Meta 用新 AI 工具查找暗中导流到儿童性虐待内容的广告
区域与早期信号
- 雷锋网复盘云栖:Qwen3.8-Flash 每次推理只激活 6B 参数
- 阶跃终端 10 月 13 日发布首款智能体手机 STEPX Neo
热门模型动态
01/10
Claude Haiku 5.5 OSWorld 升至 72.4%,Artificial Analysis 小模型榜第一
早报发布时还没有的评测数据现在有了:Haiku 5.5 的电脑操作能力比上代高得多,token 单价最多降 90%,但输出 token 消耗也明显更高。
据 The Decoder 报道,Haiku 5.5 在 OSWorld 电脑操作测试上的得分从 Haiku 4.5 的 15.7% 升到 72.4%,token 价格最多降低 90%,智能体编程等方面胜过 OpenAI 的低价模型 GPT-6 Luna。Haiku 5.5 已上线 AWS、Google Cloud 和 Azure。Anthropic 同时把 Sonnet 5.5 的缓存读取价格减半,并开始给订阅用户发放每月 API 额度。
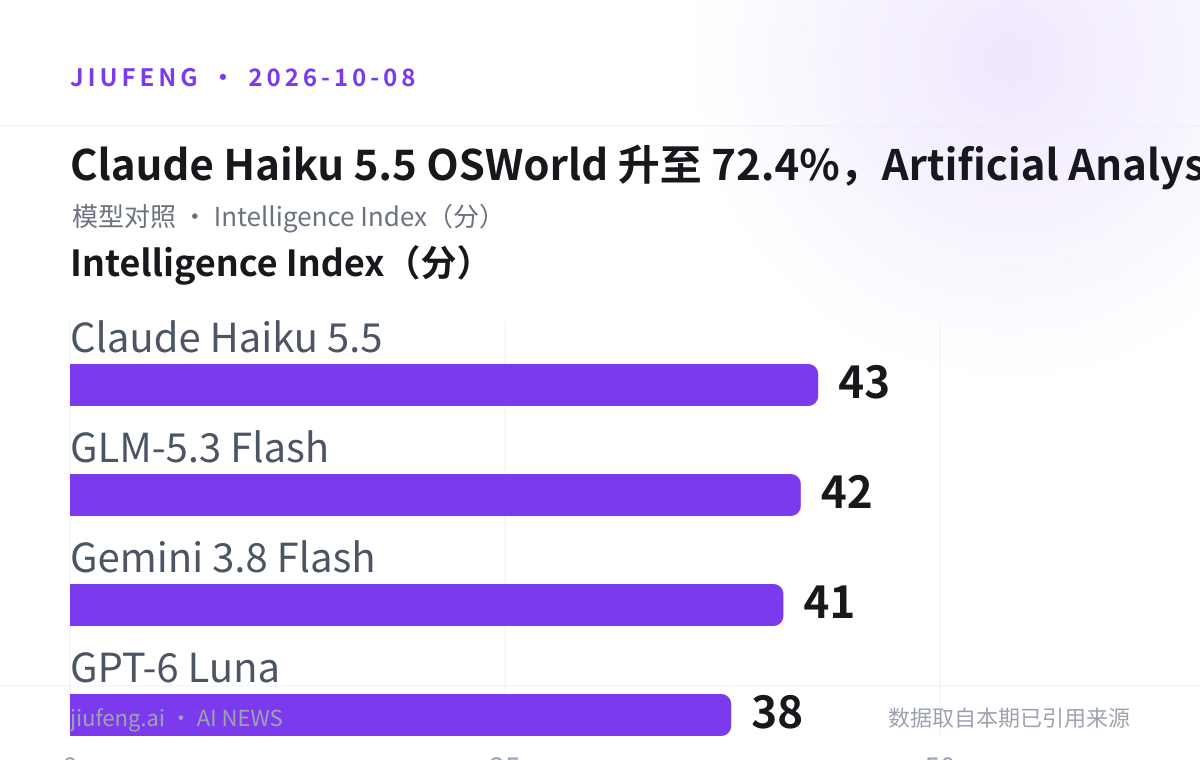
10 月 8 日,评测平台 Artificial Analysis 公布了 Intelligence Index 小模型档的排名:
| 模型 | Intelligence Index(分) |
|---|---|
| Claude Haiku 5.5 | 43 |
| GLM-5.3 Flash | 42 |
| Gemini 3.8 Flash | 41 |
| GPT-6 Luna | 38 |
局限:Artificial Analysis 指出,Haiku 5.5 的 token 消耗高得多,最高推理档位下每项任务约输出 16.2 万个 token。The Decoder 还提到它换了新 tokenizer,所以「最多降 90%」不等于实际账单能降这么多,要按自己的负载测算。Haiku 5.5 与 Claude Sonnet 5.5 在该指数上仍差 13 分。
九凤根据本期已引用来源整理。
来源:The Decoder · Anthropic
02/10
GPT-6 开始进入 ChatGPT 聊天页,OpenAI 称 Codex 与 Work 合计 4000 万活跃用户
GPT-6 向 ChatGPT 的 Chat 标签页推送当天,OpenAI 公布了智能体产品的合并用户数。
10 月 7 日,GPT-6 开始在 ChatGPT 的 Chat 标签页推送。OpenAI 产品负责人 Thibault Sottiaux 当天在 X 上说,Codex 和 ChatGPT Work 合计活跃用户达到 4000 万,付费账户还会增加一次「存量用量重置」(banked usage reset)。
- 此前口径一:今年 6 月,OpenAI 称 Codex 周用户超过 500 万
- 此前口径二:8 月 25 日的采访中,Sottiaux 称 ChatGPT Work 用户达到 2000 万
局限:4000 万是 OpenAI 自报的数字,把两款产品加在一起,帖子也没说统计窗口。RuntimeWire 指出,前后几个数字的统计口径不同,所以既推不出 Work 用户翻倍,也推不出 Codex 用户涨了 8 倍,同样看不出用户是否在反复使用。
来源:RuntimeWire · Thibault Sottiaux on X · OpenAI
03/10
Scale AI 发布视觉推理基准 HSS,最好的模型 GPT-6 Astra 只答对 53.6%
在开放式视觉推理题上,最好的模型比人类低近 40 个百分点。
Scale AI 与 Elorian 于 10 月 7 日发布 Humanity's Sixth Sense(HSS)。它测的是从图像和视频中做推断的能力,共 288 张图片和 234 段视频,题目要求自由作答。数据集已放到 Hugging Face。Elorian 联合创始人兼 CEO Andrew Dai 曾在 Google Brain 和 DeepMind 工作。
| 参测对象 | 正确率(%) |
|---|---|
| GPT-6 Astra(最高) | 53.6 |
| 25 个模型中位数 | 30.9 |
| 20 名人类参与者 | 93.1 |
局限:答案由模型评审打分。Scale 称,换用三家厂商的评审模型给其中 5 个模型重新打分后,排名不变,一致率超过 95%。RuntimeWire 指出,这次合作也是在公开检验 Elorian 自己的「视觉思考」主张:它认为现有视觉语言模型先把图像转成语言再推理,这种方式很脆弱。结果还显示,单靠增加推理时间可能纠正不了模型认不出线索、空间关系和社交情境的问题。
图片来源:huggingface;已转存至九凤 R2。
来源:RuntimeWire · Scale AI on X · Hugging Face 数据集
全球 AI 资讯
04/10
Architect 推出 Liquid Inference,每次 LLM 请求都实时拍卖
推理服务商对每个请求出价,买方按自己设定的规则付最低价。
Architect Financial Technologies 上线了 Liquid Inference,这是一个交易所式的 LLM 推理路由。服务商针对具体模型挂出报价,每个请求都会在所有报价该模型的服务商之间拍卖,满足买方规则的最低报价中标。开发者只要换掉 base URL,原有代码不用改。
局限:Architect 是交易公司,不是 AI 实验室,运营 AX 永续期货交易所。它今年 5 月收购了一家美国指定合约市场(DCM),打算上架 GPU 算力期货,目前还在等监管审查。实际成交价和延迟表现暂时没有第三方数据,报道来源只有 MarkTechPost 一家。
来源:MarkTechPost
05/10
微软给 Copilot 开放本地文件和跨系统操作,主打「混合智能」
Windows 上的 Copilot 将能读取本地文件、在整个系统里执行操作,并组合使用本地和云端模型。
在 10 月 7 日的 Windows 与 Surface 发布会上,微软演示了升级后的 Copilot:可以读取 PC 上的本地文件,并在整个系统里执行操作。微软把这套思路叫作 Hybrid Intelligence,即应用组合使用本地和云端模型。Copilot 执行副总裁 Jacob Andreou 用视频演示了让 Autopilot 帮忙报税。
局限:报税演示是预先录好的视频,不是现场操作。Andreou 称,Hybrid Intelligence 驱动的功能会在接下来几个月里陆续进入 Copilot。Windows 与 Surface 负责人 Pavan Davuluri 称,新的 Windows 搜索体验今年秋季起登陆 Windows 11 PC。目前只有 The Verge 一家报道来源。
来源:The Verge
06/10
英伟达等提出 PivotOPD,训练多轮智能体避开并纠正关键早期错误
这是一种 on-policy 蒸馏方法,针对多轮任务里「早期一步走错、后面全盘皆输」的问题。
英伟达与普林斯顿大学、马里兰大学的研究人员提出 PivotOPD,用 on-policy 蒸馏训练多轮 LLM 智能体,一方面避免早期的关键性错误(pivotal mistakes),另一方面在出错后能够恢复。在 ALFWorld、WebShop 和基于搜索的问答三个基准上(Qwen3-1.7B/8B 学生模型),它与 13 个基线方法相比取得了最好的平均成绩。
- ALFWorld:1.7B 学生模型 73.7%,8B 学生模型 93.0%
- 关键错误恢复率:72.7%
- SWE-Bench Verified(单独实验):以 Nemotron-3.5-SFT 为学生模型,从 62.8% 升到 66.0%;对照为标准 OPD 的 63.0% 和教师模型的 73.0%
局限:这是研究方法,不是可以直接调用的产品。SWE-Bench Verified 实验只和标准 OPD 及教师模型比过,不在 13 个基线的对比里。以上结果来自论文团队自己的实验,暂时没有第三方复现。
来源:MarkTechPost
07/10
AWS 放出 DevOps Agent 诊断后的自动修复方案
智能体只负责诊断、不直接改生产资源,修复交给一条独立的受控工作流。
AWS DevOps Agent 会根据关联的指标、日志和应用拓扑分诊故障,给出根因分析和修复建议。出于安全考虑,企业通常让它停留在「只观察和报告」模式。AWS 这篇文章演示了如何用 Lambda Durable Functions、EventBridge 和 Amazon Bedrock 搭一条自动修复工作流,接住诊断之后的修复环节。示例代码已在 aws-samples 仓库公开。
局限:这是博客里的参考实现,不是托管功能。智能体本身仍然只诊断不改动,自动修复的权限边界和审批要自己设计、自己验证。
来源:AWS Machine Learning Blog · GitHub 示例仓库
08/10
Meta 用新 AI 工具查找暗中导流到儿童性虐待内容的广告
有些广告和账号表面正常,实际把用户引到站外的非法内容,Meta 上线了专门识别这类情况的 AI 工具。
Meta 周三公布,2026 年上半年它在 Facebook 和 Instagram 上处理了 3320 万条儿童性剥削内容,其中超过 97% 在用户举报前就被系统发现。在印度,同期处理 530 万条,主动发现率超过 98%。新 AI 工具用来识别外表正常、实际把人引向站外有害内容的广告和账号。
局限:以上数字都是 Meta 自报,没有第三方审计。目前只有 TechCrunch 一家报道来源。
来源:TechCrunch
区域与早期信号
09/10
雷锋网复盘云栖:Qwen3.8-Flash 每次推理只激活 6B 参数
阿里给出的下一阶段思路是一边扩大规模,一边改架构降低成本。
据雷锋网的云栖大会观察,8 月发布的 Qwen3.8 参数量已达 2.4T,是两年前 Qwen2.5 旗舰(72B)的约 33 倍。Qwen3.8-Flash 用了稀疏注意力、线性注意力和外接记忆:
- 激活参数:每次推理只激活 6B
- 训练成本:降到上一代的九分之一
- 输入价格:每百万 token 降到上一代的四分之一
- 长上下文:超长上下文的预填充吞吐提高 8.6 倍
局限:这些数字都来自阿里自己的演讲,没有第三方复核。Qwen4 之后的参数路线此前已经报道过,这篇没有新的发布时间表。目前只有中文来源。
来源:雷锋网
10/10
阶跃终端 10 月 13 日发布首款智能体手机 STEPX Neo
阶跃终端预告了第一款「大模型原生」智能体手机。
阶跃终端将于 10 月 13 日在上海举办「Ready Builder One」发布会,推出首款大模型原生智能体手机 STEPX Neo。官方称这款手机的模型、系统和硬件都是围绕智能体打造的,发布会上还会公布生态合作的最新进展。
局限:这是发布预告,规格、价格和搭载的模型版本都还没公布。稿件由阶跃终端提供、量子位授权转载,属于厂商口径,目前只有中文来源。
来源:量子位
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片