概览
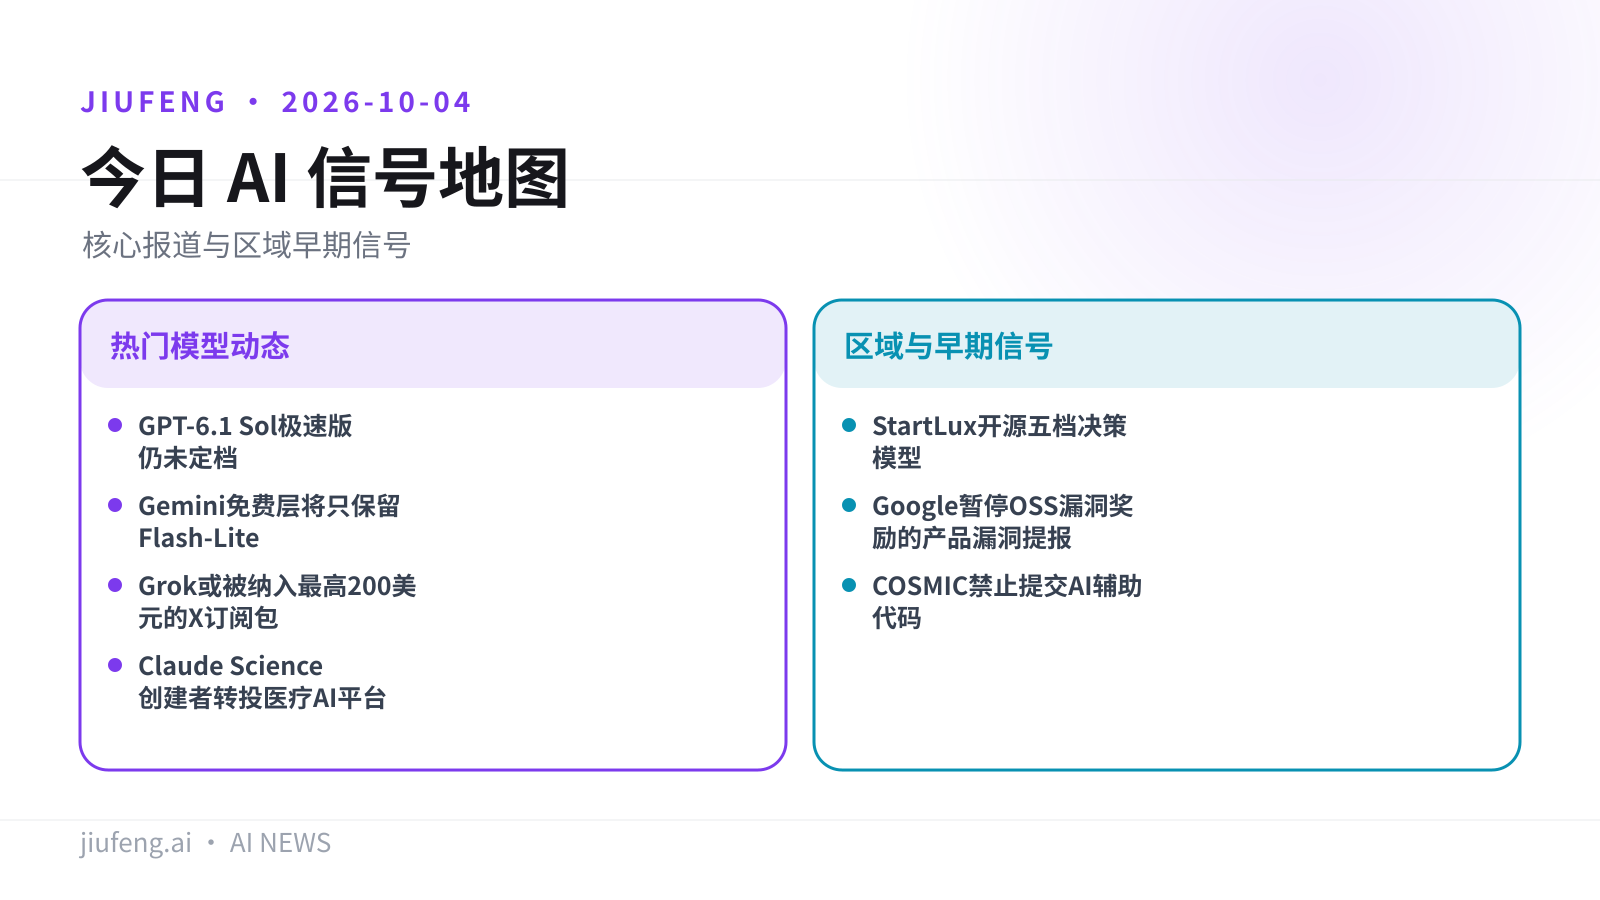
本期共 8 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · GPT-6.1 Sol 极速版仍未定档
- 重点 · Gemini 免费层将只保留 Flash-Lite
- 重点 · Grok 或被纳入最高 200 美元的 X 订阅包
- Claude Science 创建者转投医疗 AI 平台
- 测试称部分中国模型回避敏感政治问题
区域与早期信号
- StartLux 开源五档决策模型
- Google 暂停 OSS 漏洞奖励的产品漏洞提报
- COSMIC 禁止提交 AI 辅助代码
九凤根据本期已引用来源整理。
热门模型动态
01/08
GPT-6.1 Sol 极速版仍未定档
OpenAI 再次确认 GPT-6.1 Sol 的 Ultrafast 档会推出,但尚未给出上线日期或价格。
OpenAI 产品与工程负责人 Tibo Sottiaux 在 10 月 4 日回复开发者时称“6.1 coming soon”,上下文指向 GPT-6.1 Sol Ultrafast。GPT-6.1 Sol 已于 9 月 29 日面向 ChatGPT Work、Codex 和 API 用户上线,标准 API 输入与输出价格分别为每百万 token 2 美元和 10 美元,缓存输入为每百万 token 0.10 美元。
局限:OpenAI 此前称 Ultrafast 在 Codex 中的 token 生成速度最高可达标准档的 8 倍,但截至该回复,尚未公布实际发布日期或 Ultrafast API 定价。
『来源:RuntimeWire · OpenAI 发布公告 · OpenAI API 文档』
02/08
Gemini 免费层将只保留 Flash-Lite
Google 计划把个人免费用户收缩至 Flash-Lite,Flash 与 Pro 将转入付费档。
The Decoder 报道称,Google 将从 2026 年 10 月起调整 Gemini 个人账户档位:免费用户只能使用 Flash-Lite,AI Plus 月费 4.99 美元用户可使用 Flash-Lite 和 Flash,Pro 则要求 AI Pro 或 AI Ultra。调整前,免费层可访问 Gemini 3.6 Flash,并可获得不同额度的 Gemini 3.1 Pro。
| 订阅档位 | 月费(美元) | 可用模型 |
|---|---|---|
| 免费 | 0 | Flash-Lite |
| AI Plus | 4.99 | Flash-Lite、Flash |
| AI Pro | 19.99 | Flash-Lite、Flash、Pro |
| AI Ultra | 99.99 或 199.99 | Flash-Lite、Flash、Pro |
局限:报道指出,多数普通用户未必知道自己正在运行哪一档模型。
『来源:The Decoder』
03/08
Grok 或被纳入最高 200 美元的 X 订阅包
一段测试界面录屏显示,X 正试图把 Grok、社交订阅与 Cursor 放进共享 AI 用量池。
RuntimeWire 报道的录屏列出 Premium、Plus、Super、Ultra 四档网页订阅,月费从 8 美元到 200 美元,并标注共享 AI 使用额度。页面还列出首月折扣:Premium 首月 4 美元、Plus 首月 15 美元,优惠截至 10 月 9 日。
| 档位 | 网页月费(美元) | 网页年费(美元) |
|---|---|---|
| Premium | 8 | 80 |
| Plus | 30 | 300 |
| Super | 100 | 1,000 |
| Ultra | 200 | 2,000 |
局限:录屏发布者称方案仍在开发中,条款可能变化;页面没有说明各档具体包含多少 Cursor 使用额度,且 App Store 价格与网页价格不同。
『来源:RuntimeWire · X Premium FAQ』
04/08
Claude Science 创建者转投医疗 AI 平台
参与 Claude Science 的工程师 Alec Tarashansky 宣布加入 OpenEvidence,计划把科研工作流经验带入医生工具。
Tarashansky 于 10 月 3 日表示,他已加入 OpenEvidence,从事医疗 AI 工作。他此前参与的 Claude Science 是 Anthropic 在 6 月 30 日推出的 beta 科研工作台,可将 Claude 连接到 60 多个科学工具与数据源。
局限:这是一名产品创建者的职业变动,不是 Claude Science 的版本发布;报道未披露其在 OpenEvidence 的具体产品、上线日期或临床验证数据。
『来源:RuntimeWire · Anthropic Claude Science』
05/08
测试称部分中国模型回避敏感政治问题
Aleph Alpha 的测试报告称,其抽样测试中的多家中国模型仅有 17% 至 41% 的回答被评为“平衡”。
The Decoder 报道称,Aleph Alpha 设计的测试覆盖天安门、台湾和新疆等 967 个手选敏感话题,测试对象包括阿里 Qwen、DeepSeek 和月之暗面 Kimi。该公司自己的 AI 评分系统将 17% 至 41% 的回答评为平衡,其余回答被归为重复官方立场、回避或拒答;报道还称 DeepSeek V4 Pro 对约三分之二的问题直接拒答。
局限:该基准由 Aleph Alpha 开发并用其自身 AI 系统评分,报道同时指出该公司面向政府销售“主权 AI”,与中国模型存在商业竞争关系;结果不等同于独立的全面模型评测。
『来源:The Decoder · Nemotron Cascade 2 论文』
九凤根据本期已引用来源整理。
区域与早期信号
06/08
StartLux 开源五档决策模型
StartLux 发布 0.8B 至 27B 五档决策模型,并公布了针对 Jev 的自测对比。
钛媒体转载的项目材料显示,StartLux-Decision 提供 0.8B、2B、4B、9B、27B 五种规格,以及原始权重、Q8_0、Q4_K_M、BF16 格式。项目方称,27B 版本在 Decision Index 0.2.1 获 63.88 分,较 Jev 1.13 的 57.91 分高 5.97 分;在七套测试中的平均准确率为 91.82%。
| 版本 | 参数量 | 单卡 H200 短请求耗时(毫秒) |
|---|---|---|
| StartLux-Decision | 0.8B | 12.2 |
| StartLux-Decision | 2B | 15.5 |
| StartLux-Decision | 9B | 35.7 |
| StartLux-Decision | 27B | 102.3 |
局限:Chinese-language source。上述评测与时延均为项目方公布或自测,Decision Index 对照使用的是 9 月 28 日公开榜单快照,尚无候选材料中的独立复核。
『来源:钛媒体』
07/08
Google 暂停 OSS 漏洞奖励的产品漏洞提报
Google 自 10 月 1 日起停止在 OSS VRP 接收产品漏洞报告,报道将调整与大量无效 AI 生成报告相联系。
IT之家援引 Google 公告称,10 月 1 日前已提交的产品漏洞不受影响;部分可能影响 Google Cloud 产品的代码库,仍可能由 Cloud VRP 接收。报道援引 Tom's Hardware 的说法称,维护人员面对数以千计的低质量报告,其中一些经排查为无法利用的 AI“幻觉”。
局限:Chinese-language source。报道所述 AI 生成无效报告的规模来自知情人士说法,候选材料未提供 Google 对这一因果关系的直接量化说明;Google 计划在 2027 年第一季度公布 OSS VRP 重组进展。
『来源:IT之家』
08/08
COSMIC 禁止提交 AI 辅助代码
System76 更新 COSMIC 的 PR 模板,要求贡献者确认提交中没有 AI 生成的代码、注释或描述。
IT之家报道称,这项强制检查清单适用于 System76 以 Rust 开发的 COSMIC 桌面环境;目前 cosmic-flatpak 是其唯一不受“No LLM contributions”规则限制的代码库。报道还称,System76 的理由是 AI 生成代码可能缺少对大型项目深层集成关系的理解,从而提高审查与维护成本。
局限:Chinese-language source。该规则反映的是一个开源项目的贡献政策,不是对 AI 辅助代码质量的通用技术结论;候选材料未提供 AI 提交量、拒绝率或维护工时等量化数据。
『来源:IT之家』
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片