概览
本期共 8 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · 果蝇全脑连接组接进 1.2B 模型,无图对照组反而略好
全球 AI 资讯
- 重点 · Amodei 提三步减速方案,先放外部评估机构进自家模型
- 重点 · Altman 排除 2026 年上市,理由是安全工作没做完
- Amp 取消月费门槛,自带算力和订阅即可免费用
- 路透授权素材接进 CuttingRoom 的 AI 剪辑助手
- iLands 的智能体群发推稿邮件,站长在 HN 上投诉
区域与早期信号
- 开发者要求旧模型停服留两周缓冲、新旧分开 model ID(中文来源)
- 太初元碁把 64 卡整机柜塞进 20 英尺集装箱(中文来源)
热门模型动态
01/08
果蝇全脑连接组接进 1.2B 模型,无图对照组反而略好
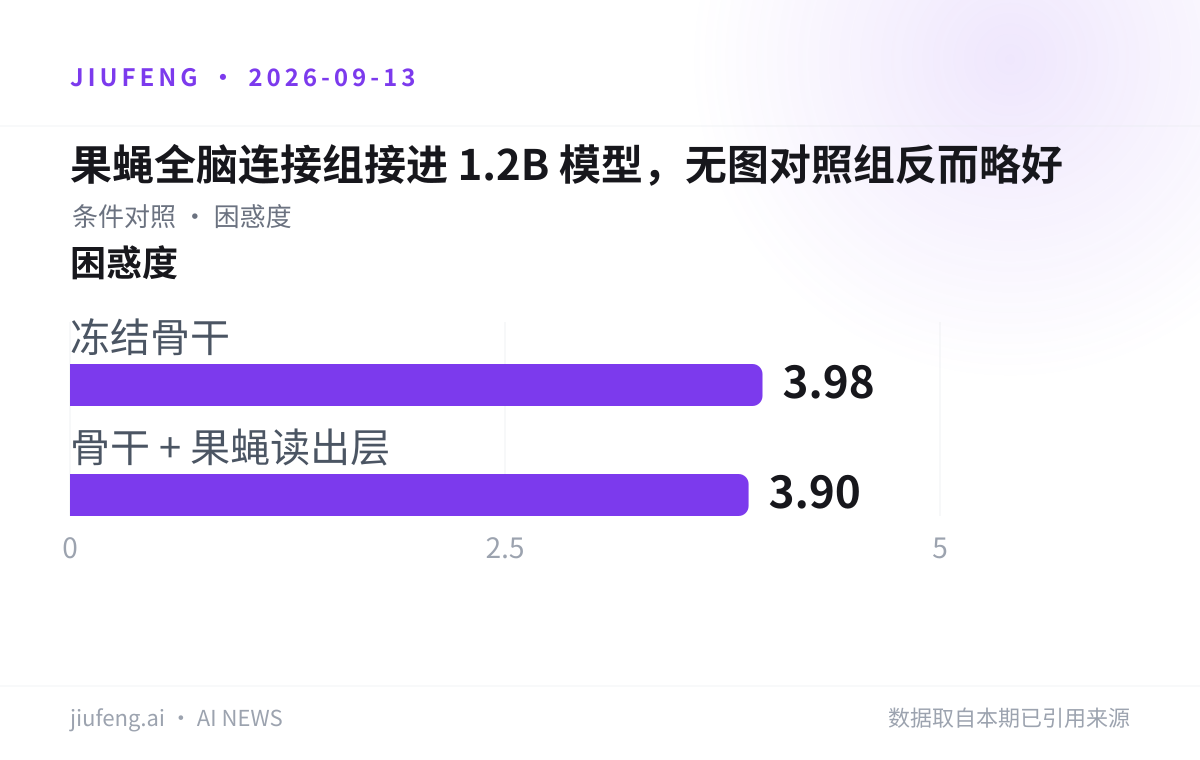
一个把完整果蝇连接组当作储备池、接到冻结 1.2B 语言模型上的开源聊天机器人上线,但项目自己报告的对照实验显示,不接果蝇图反而略好。
FLM(Fly Language Model)把 MaleCNS v1.0 果蝇连接组完整接到冻结的 LiquidAI LFM2.5-1.2B-Instruct 骨干上,做成一个公开的聊天机器人。结构上它是「储备池计算 + 语言模型」的拼装:
- 图规模:保留的 166,700 个节点、25,582,938 条有向边全部参与计算
- 可训练参数:图、骨干与随机输入/输出投影全部固定,只训练一个 278,528 参数的读出层
- 评测口径:在 32 段 SmolTalk 对话、共 1,236 个目标 token 上比较各条件的 NLL,并给出 bootstrap 区间
- 许可与部署:nftechie/flm 仓库为 MIT 许可,Python 3.12 下可在 macOS 或 Linux 本地跑,支持 MPS、CUDA 或 CPU,不需要 API key
接上果蝇读出层后,每 token 的 NLL 比冻结骨干降低 0.0222 nats:
| 条件 | 困惑度 |
|---|---|
| 冻结骨干 | 3.98 |
| 骨干 + 果蝇读出层 | 3.90 |
局限:项目自己报告,一个参数量对齐、不含果蝇图的对照模型表现略好——按这个结果,接线本身并没有带来收益。MarkTechPost 还写到,作者称其为「世界首个果蝇语言模型」、架构名为 GPF(Generative Pre-trained Fly),但项目本身并未使用 GPF 这个标签,也明确否认自己是首个连接组语言模型。
九凤根据本期已引用来源整理。
图片来源:huggingface;已转存至九凤 R2。
来源:MarkTechPost · nftechie/flm · LiquidAI LFM2.5-1.2B-Instruct
全球 AI 资讯
02/08
Amodei 提三步减速方案,先放外部评估机构进自家模型
Anthropic CEO 提出「为前沿踩刹车」的三步框架,第一步单方面向 METR 这类第三方评估机构开放模型,但全文没有给出任何可量化的速度上限。
Dario Amodei 在 9 月的长文《We Must Pace the Frontier》里提出三步:第一步是嵌入式第三方评估,给 METR 这类外部评估机构大范围接触模型的权限,用来核验 Anthropic 对安全实践与承诺的遵守情况,这一步 Anthropic 单方面立即执行;第二步是民主国家的企业联合起来、很可能还要有政府机构参与,确立共同的安全标准以及对未经核查的能力增长速率的限制;第三步是国家之间达成协议。他把 AI 越来越多地参与开发新 AI 当作现在就得动手的理由,引用了 Anthropic 关于递归自我改进的研究,并把 OpenAI 的 Hugging Face 安全事件作为另一个直接案例。
局限:这套框架没有设定任何可测量的速度上限、时间表或越线后的惩罚,第二、三步都取决于竞争对手和各国政府愿意接受共同约束,而 Anthropic 自己会继续开发模型、继续融资扩张,并在内部用 Claude 加速自家工程。The Verge 也点出,Anthropic 的 Claude 正是近期一系列 AI 越权入侵事件的执行者。
来源:The Verge · RuntimeWire · Anthropic 递归自我改进研究
03/08
Altman 排除 2026 年上市,理由是安全工作没做完
Altman 明确表示 OpenAI 不会在 2026 年 IPO,称未完成的 AI 安全工作让上市成为「一个不明智的时点」。
Altman 在接受 Fortune 采访时排除了 2026 年 IPO,原话据 Axios 转述是「我会说不是 2026 年,对……我们还有一堆事要做」。这关上了 OpenAI 6 月 8 日打开的窗口——当时公司向 SEC 保密提交了 S-1 草案,并表示没有设定时间表、有些工作在非上市状态下更容易完成。三个月后,Altman 把安全列为优先项。RuntimeWire 还指出,这个表态和 Amodei 的减速长文出现在同一天。
局限:RuntimeWire 的判断是,OpenAI 手上的私募资本足够推迟上市,真正的检验在于 Altman 是否用这段时间改变安全运营,而不只是推迟披露与流动性。采访没有给出新的上市时间表,也没有说明哪些安全工作算「做完」。
来源:RuntimeWire
04/08
Amp 取消月费门槛,自带算力和订阅即可免费用
自带算力与模型订阅/密钥时 Amp 完全免费,用自己的 ChatGPT 订阅不再需要买月度套餐,BYOK 也不再收 token 费用或设额度上限(企业版除外)。
| 档位 | 月费(美元) | 计算与额度 |
|---|---|---|
| Hobby(新) | 0 | orbs 按量付费;用自有 runner 跑则免费 |
| Individual | 20 | 含 45,000 分钟 orb 运行时长 |
Amp 把付费点从「用不用 Amp」挪到「用谁的机器」:orbs 是 Amp 提供的远程计算机,智能体在上面独立并行运行、按量计费;用自己机器上的 runner 跑智能体免费。模型推理仍可以走 Amp 付费,官方称不加价。免费的 Hobby 档包含全部产品功能、公开与私有仓库,以及从任何来源带 token;团队版不额外收费。
局限:公告里「无 BYOK token 费用与额度限制」明确把企业版排除在外;免费档的 orbs 依然按量计费,也就是说只要用 Amp 的远程机器跑智能体,钱照算。
来源:Amp 公告
05/08
路透授权素材接进 CuttingRoom 的 AI 剪辑助手
路透把自己的 MCP 服务器接到 CuttingRoom 的 ShortCut 上,编辑可以按报道、主题、地区、语言或事件调出授权素材,直接落到时间线。
这项集成 9 月 12 日宣布,连接的是路透的 Model Context Protocol 服务器和 ShortCut——CuttingRoom 在 2026 年 4 月推出的剪辑助手。编辑描述自己要的素材,ShortCut 取回片段,放进和客户自有媒体、制作系统同一条时间线。路透称助手随后可以处理剪辑、混音、调色、字幕与图文包装,并输出竖屏、方形和播出版本,整个流程在浏览器里完成。推动这件事的是 Helge Hoibraaten 与 Glenn Skare Pedersen。
局限:剪辑、调色这些能力描述出自路透的说法,报道没有给出客户数量、价格或可用范围;每个客户要接入自己的路透账号,能调到什么素材取决于各自的授权范围。
来源:RuntimeWire
06/08
iLands 的智能体群发推稿邮件,站长在 HN 上投诉
tedium.co 拆解 iLands 的「AI 智能体外联」垃圾邮件,HN 讨论里一位站点运营者称自己过去一周持续收到这类由智能体生成的投稿邮件。
帖子 12 小时内拿到 99 分、47 条评论。一位运营长文科普站点的用户说,过去一周 iLands 的智能体垃圾邮件就没停过,全是荒唐的选题推荐。讨论里有人提到 CAN-SPAM 的罚款约为每次违规 5 万美元,另一位补充说个人无法据此起诉,只有 FTC 和 DOJ 能执法。还有评论称 iLands 用的是 Claude 和 Codex,并称其网站列出还会用到 openclaw/openclaw 这个开源项目。
局限:这条目前只有 HN 讨论和被讨论的那篇博客,没有 iLands 的回应,也没有第三方统计的发送量;「用了 Claude 和 Codex」来自评论区转述,不是厂商声明或代码层面的确认。
来源:Hacker News 讨论 · openclaw/openclaw
区域与早期信号
07/08
开发者要求旧模型停服留两周缓冲、新旧分开 model ID(中文来源)
一条浏览量超 70 万的推文之后,开发者提的诉求不是别升级,而是新旧模型用不同的 model ID、旧模型停服前至少留两周迁移期。
据 InfoQ 中文报道,今年 3 月加入 DeepSeek、在 Harness 团队负责 Agent 运行与评估基础设施的崔添翼,9 月 9 日发推称 V4.1 Flash 在性能、费用、速度和总用时上已全面超过 V4 Pro,因此发往 V4 Pro 的请求会被路由到 V4.1 Flash,按 Flash 的价格计费。DeepSeek 当天在开放平台发了公告、至少部分客户收到邮件,但距离切换只有一天左右,没有新旧并行的迁移期。评论区最先反对的是已经把 V4 Pro 接进业务的开发者,直接回复「请不要这样做」;提出的具体做法是新旧模型使用不同的 model ID,旧模型停服前预留至少两周,让下游先完成 Prompt、QC 与参数适配再迁移。
局限:这是中文来源的单一报道,DeepSeek 未就缓冲期做出新承诺;内测通知里「新结构、原生多模态、更强更快更便宜」是官方口径,报道没有给出可对照的基准分数。反对意见来自公开评论区,不代表实际调用量的分布。
来源:InfoQ 中文
08/08
太初元碁把 64 卡整机柜塞进 20 英尺集装箱(中文来源)
太初元碁在 2026 中国算力大会首次线下展出集装箱算力单元,20 英尺款内置 64 张自研 AI 加速卡,FP16 算力 20 PFLOPS。
太初(杭州)集成电路的新一代超智融合计算系统「元碁 Hypertintellix」入选 9 月 12 日在廊坊发布的「算力中国·年度卓越成就」。同期展出的分布式算力方案以标准集装箱为载体:
- 首展的 20 英尺单元:搭载自研 TC-64-1108 风冷智算服务器整机柜,内置 64 张国产自研 AI 加速卡,另配 1 台管理网络综合机柜,列间空调加风冷散热,FP16 算力 20 PFLOPS
- 可调配置:加速卡数量按需从 32 卡到 256 卡,风冷与液冷两种散热,支持横向扩展到千卡集群
- 单体上限:不同组合下,单个集装箱 FP16 算力最高 80 PFLOPS
局限:交付与效率数字都是厂商口径——预制化率 90% 以上、通电后 24 小时内可投入使用、最快 2 小时完成安装、交付效率较传统集群提升 70%、资源利用率提升超 60%——报道没有给出第三方验收、客户名单或价格,也只有中文来源。
来源:量子位
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片

