概览
本期共 9 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · OpenAI Codex 小模型赛揭晓,无障碍工具夺冠
- 重点 · DeepSeek V4-Flash 登顶 OpenRouter 周调用榜
- 重点 · Kimi K3 主打原生多模态,对标 DeepSeek V4
全球 AI 资讯
- Amp 支持上传任意文件供智能体读取
- Amazon Bedrock 自动推理策略支持自动修正
- Valar Atomics 融资 10 亿美元,量产小型核反应堆
- AI 监考崩盘,5.8 万名学生须重考
区域与早期信号
- 腾讯云开源 Agent Memory,沉淀团队研发经验
- 亿级日活出海 App 靠跨云架构砍掉 75% GPU 集群
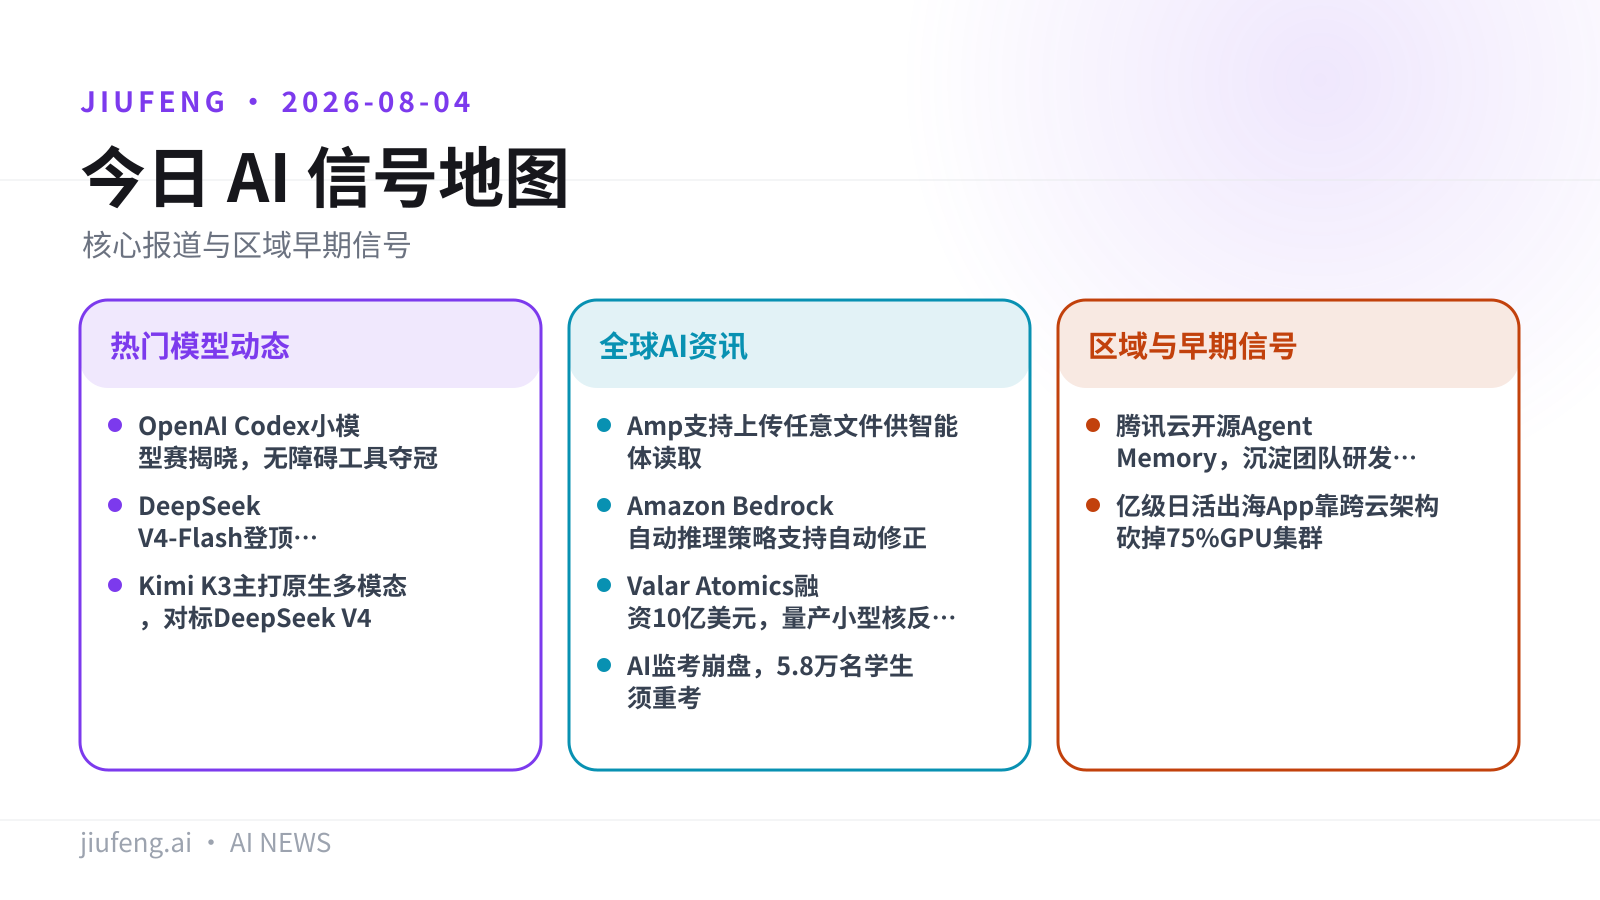
九凤根据本期已引用来源整理。
热门模型动态
01/09
OpenAI Codex 小模型赛揭晓,无障碍工具夺冠
一句话结论:Gradio 的「Build Small」黑客松限定参数不超过 320 亿,三款小模型应用分走 1 万美元 OpenAI Codex 奖金。
归 Hugging Face 所有的 Gradio 于 8 月 3 日在 X 上以五条推文公布「Build Small」黑客松结果,奖金总额 1 万美元、由 OpenAI Codex 赞助,参赛模型参数上限 320 亿。头奖 5000 美元颁给 GitHub 用户 cvpfus 提交的 Tiny Narrator——一个组合了紧凑的语言、视觉与语音(文本转语音)模型、为网页内容做旁白的屏幕阅读器原型;Blood Test Explainer 与 Uta Sensei 分列其后。
RuntimeWire 指出,这些获奖作品显示编程智能体与本地小模型正合流成一套可落地的构建栈——小团队无需为每个请求都调用大型托管模型,即可交付可私有部署、可审查的 AI 工具。名次之外的评审标准与后续奖金安排以官方公布为准。
图片来源:GitHub;已转存至九凤 R2。
来源:RuntimeWire · Tiny Narrator(Hugging Face) · 代码仓库(GitHub)
02/09
DeepSeek V4-Flash 登顶 OpenRouter 周调用榜
一句话结论:DeepSeek V4-Flash 以每周 7.1 万亿 token 登顶 OpenRouter 调用榜,中国模型占据全球前十中的九席。
据 Pandaily,DeepSeek V4-Flash 以每周 7.1 万亿 token 的调用量登上 OpenRouter 周榜首位;中国模型拿下全球前十里的九席,全球每周 AI token 用量突破 56.8 万亿。这一排名反映的是各模型在 OpenRouter 上的实际调用规模。
OpenRouter 榜单衡量的是调用量而非模型能力排名;上述数字来自 Pandaily 报道,未附官方榜单快照,具体口径与统计周期以平台为准。
来源:Pandaily
03/09
Kimi K3 主打原生多模态,对标 DeepSeek V4
一句话结论:据 36氪,月之暗面 Kimi K3 以 2.8 万亿参数、100 万 token 上下文的 MoE 架构,把原生多模态作为区别于 DeepSeek V4 的关键标签。
据 36氪,7 月发布的 Kimi K3 是总参数 2.8 万亿、支持 100 万 token 上下文的 MoE 模型,除 Coding 与长程 Agent 能力外,主打原生多模态——让图像、文字等数据从预训练/持续预训练阶段就共同塑造主模型,并在后训练中继续优化,参与智能体的感知与反馈。报道援引一位多模态研究员的说法:长链任务若只靠代码层反馈,误差会不断累积,而视觉是更准确、更贴近用户意图的反馈。
该文为 36氪的对比分析(原题「Kimi K3 与 DeepSeek V4 之间,隔着原生多模态的时间差」),「时间差」是作者判断而非厂商基准数据;文中未给出可复核的多模态榜单分数,暂无全球英文报道佐证。
来源:36氪(中文来源)
全球 AI 资讯
04/09
Amp 支持上传任意文件供智能体读取
一句话结论:编程智能体 Amp 上线「附加任意文件」,可读取视频、日志、PDF、表格、数据集等并据此行动。
Amp 官方公告,用户现在可以向 orb 上传任意文件供 Amp 读取和使用,包括视频、日志、PDF、电子表格和数据集等。官方给出的用法示例:录屏后让 Amp 修复/改进它看到的内容、从日志文件排查问题、把演示文稿和电子表格转成可交互网站、从媒体输入生成视频与 CAD 文件、转写视频与音频。
公告为能力介绍,未列出文件大小上限、支持的具体格式清单或处理时延等参数;实际效果取决于上传素材质量。
05/09
Amazon Bedrock 自动推理策略支持自动修正
一句话结论:Amazon Bedrock 的自动推理(Automated Reasoning)新增策略自动优化,能诊断失败测试并提出形式逻辑修复。
AWS 官方博客,Amazon Bedrock 现已支持自动化的「自动推理策略优化」(Automated Reasoning policy refinement):优化引擎会诊断失败的测试用例,针对规则问题和语言问题提出形式逻辑(formal-logic)层面的修复建议,用户可据此更新策略。
该条为官方产品公告,素材偏薄,未给出可复核的准确率提升、覆盖场景或定价数据;具体能力与限制以 AWS 文档为准。
来源:AWS Machine Learning Blog(官方)
06/09
Valar Atomics 融资 10 亿美元,量产小型核反应堆
一句话结论:核能创业公司 Valar Atomics 完成 10 亿美元 B 轮,计划从原型转向产线量产、为 AI 产业供电。
据 SiliconANGLE,核能创业公司 Valar Atomics 宣布完成 10 亿美元 B 轮融资,由红杉资本(Sequoia Capital)领投、另有九家风投参投;资金将用于把小型核反应堆从原型阶段推进到产线规模化制造,面向 AI 产业的电力需求。
报道未披露反应堆的具体功率、投产时间表或监管审批进度;小型模块化反应堆的商业化仍受核安全审批周期约束。
来源:SiliconANGLE
07/09
AI 监考崩盘,5.8 万名学生须重考
一句话结论:一场由 AI 监考的远程考试严重失控,5.8 万名学生被要求重考,高分人数一度暴增至五倍。
据 Ars Technica,一场采用 AI 监督的远程考试因失控,导致 5.8 万名(58,000)学生必须重考;报道称考试期间高分(top scores)增加到原来的五倍。
该条素材偏薄,报道摘要未给出考试名称、主办方、AI 监考系统供应商及具体失控原因;「高分增至五倍」的成因(作弊或系统失灵)以原文为准。
来源:Ars Technica
区域与早期信号
08/09
腾讯云开源 Agent Memory,沉淀团队研发经验
一句话结论:TencentDB Agent Memory 开源,试图把历史对话、项目文档、代码库和团队 SOP 变成可复用、可治理的「记忆资产」,而非更大的知识库。
据 InfoQ 中文,腾讯云推出并开源 TencentDB Agent Memory,主张 Agent 从「能用」走向「好用」的瓶颈是记忆而非单次推理。其思路拆成四层:什么内容值得被记住、团队经验如何拆成资产、资产如何被治理,以及用开源与评测验证能力;核心不是给 Agent 更大的知识库,而是把任务中产生的背景与判断沉淀成可装配的记忆资产。项目已在 GitHub 开源。
InfoQ 稿件偏方法论介绍,正文摘录未给出可复核的评测分数、召回率或延迟等硬指标,实际效果需在自有 Agent 流程中试跑验证。中文媒体单源报道,一手证据为官方 GitHub 仓库。
来源:InfoQ 中文(中文来源) · TencentDB-Agent-Memory(GitHub)
09/09
亿级日活出海 App 靠跨云架构砍掉 75% GPU 集群
一句话结论:量子位报道,一款亿级日活的出海 AI 应用因推理成本倒挂濒临亏损,通过跨云架构把 GPU 集群规模砍掉约 75%。
据量子位,一款主打「AI 穿搭 + 购物推荐」的出海应用跻身亿级日活,用户上传自拍即可在锁屏实时生成合成图并导购;但新兴市场 ARPU 仅约 2 美元,而其此前租用某全球 Top2 云厂商的英伟达 L4 GPU、按不同配置每小时 0.7—8 美元、实测生成一张高清图约 12 秒,后台每用户每天约 3 次等效推理,形成「越跑越亏」的成本倒挂。团队改用跨云架构后,将 GPU 集群规模削减约 75%。
报道未点名该应用与云厂商,成本与降幅数据来自受访团队自述、未经第三方审计;不同区域与机型的实际单价可能不同。中文媒体单源。
来源:量子位(中文来源)
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片

