概览
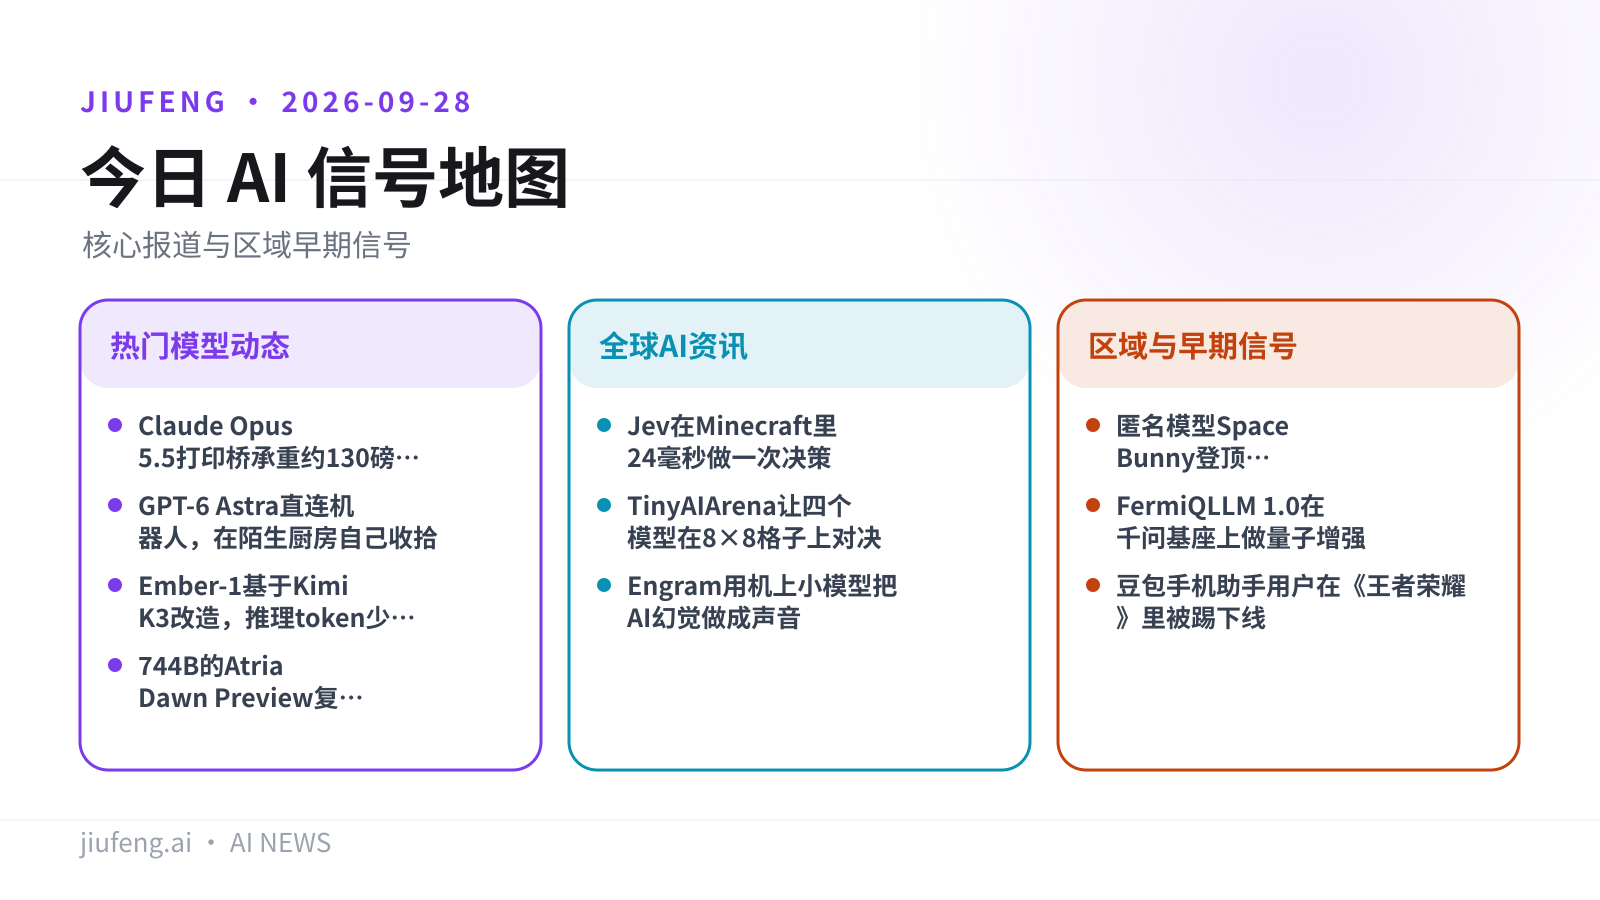
本期共 10 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · Claude Opus 5.5 打印桥承重约 130 磅,五模型第一
- 重点 · GPT-6 Astra 直连机器人,在陌生厨房自己收拾
- 重点 · Ember-1 基于 Kimi K3 改造,推理 token 少四成
- 744B 的 Atria Dawn Preview 复盘:智能体提方案、人类拍板
全球 AI 资讯
- Jev 在 Minecraft 里 24 毫秒做一次决策
- TinyAIArena 让四个模型在 8×8 格子上对决
- Engram 用机上小模型把 AI 幻觉做成声音
区域与早期信号
- 匿名模型 Space Bunny 登顶 OpenRouter 调用日榜
- FermiQLLM 1.0 在千问基座上做量子增强
- 豆包手机助手用户在《王者荣耀》里被踢下线
九凤根据本期已引用来源整理。
热门模型动态
01/10
Claude Opus 5.5 打印桥承重约 130 磅,五模型第一
Anthropic 的 Claude Opus 5.5 在一场五模型 3D 打印承重桥比试里排第一,桥体承重约 130 磅。
Roberto Nickson(@rpnickson)9 月 27 日在 X 上公布了这场比试的结果。参赛的是 Anthropic Claude Opus 5.5、月之暗面 Kimi K3、Meta Muse Spark 1.3、OpenAI GPT-6 Astra 和 SpaceXAI Grok 4.7,他把五个模型都设在「High」推理档。题目有三条硬约束:桥要跨过两英尺、耗材不超过 500 克、打印时间少于 18 小时;配重的种类和压在桥上的位置也由他指定。
| 模型 | 桥体承重 |
|---|---|
| Claude Opus 5.5 | 约 130 磅 |
| Muse Spark 1.3 | 26.5 磅 |
| GPT-6 Astra | 约 17.5 磅 |
| Kimi K3 | 未完成挑战 |
| Grok 4.7 | 未完成挑战 |
RuntimeWire 写道,在 Nickson 的这组对比里,Claude 在承重和打印效率两项都领先。
局限:这是一个人在自己设定的条件下跑出来的结果,报道明确说它描述的是他测试条件下的这几个设计,而不是五个模型工程能力的通用排名;130 磅与 17.5 磅都被明确标注为估计值,结果出自 Nickson 自述,他在 X 帖里附了一段约 15 分钟的视频。
来源:RuntimeWire · Roberto Nickson 在 X 的原帖 · Claude Opus 5.5 产品页
02/10
GPT-6 Astra 直连机器人,在陌生厨房自己收拾
斯坦福与加州理工把 GPT-6 Astra 直接接到 Unitree G1 上,跳过了中间那层专门训练的控制模型。
这套系统叫 HomeBody。它把语言模型与机器人之间常见的已训练控制层去掉,换成一个可替换的视觉语言模型(这里是 GPT Astra)直接调用可扩展的技能库——抓取、导航、开抽屉。机器人先在房间里探索,在 NVIDIA Isaac Sim 里建一个数字孪生,把物体和位置记进空间记忆,因此东西离开视野后它仍能找到。遇到「把厨房收拾一下」这类任务,语言模型逐步规划,出错就自我纠正。
局限:研究者列出的短板是 Astra 的延迟、手指伺服过热和高算力成本。这是一套研究系统,目前能依据的只有研究团队自述的运行结果,没有第三方复现。
图片来源:GitHub;已转存至九凤 R2。
来源:The Decoder · HomeBody 项目仓库 · NVIDIA Isaac Sim 文档
03/10
Ember-1 基于 Kimi K3 改造,推理 token 少四成
Fireworks 说这个从 Kimi K3 改出来的模型能给出相当的答案,但少生成约 40% 的 token。
Fireworks AI 联合创始人 Dmytro Dzhulgakov(@dzhulgakov)9 月 27 日在 X 上推广 Ember-1。公司 9 月 23 日推出这个模型,定位是压低推理密集的编码与智能体负载的成本,官方发布材料用基准测试和客户实测结果支撑了「少 40% token」这一项。Dzhulgakov 在帖子里说它「在 HN 上很热」,并称它快 40%、更便宜。他是 Fireworks 七位联合创始人之一,团队页写明他曾是 Meta 的 PyTorch 核心维护者。
局限:RuntimeWire 指出,官方材料并不支持「响应速度普遍快 40%」这个说法——少生成 token 能降低单任务成本,但不等于跨负载的延迟更低。40% 是厂商自测数字,且与具体负载相关。
来源:RuntimeWire · Dmytro Dzhulgakov 在 X 的原帖
04/10
744B 的 Atria Dawn Preview 复盘:智能体提方案、人类拍板
一支含复旦大学研究者的团队复盘自家模型的开发日志:智能体贡献了最多 55% 的方法提案,但超过 85% 的最终决定还是人做的。
- 样本:769 条任务日志,来自 56 名参与者,另加他们使用的智能体日志
- 被开发的模型:Atria Dawn Preview,混合专家架构、7440 亿参数,面向研究与工程任务
- 训练方式:每个任务绑定一个真实执行环境,调用工具、产出中间结果,再用测试、指标或来源证据这类外部信号校验
- 自述成绩:团队称在 16 个基准里有 5 项领先,含网页搜索与网络安全
局限:这是团队对自己项目的复盘,不是第三方观察;16 项基准里另外 11 项并未称第一,成绩也全部来自团队自述。
来源:The Decoder · Atria Dawn Preview
全球 AI 资讯
05/10
Jev 在 Minecraft 里 24 毫秒做一次决策
Hao AI Lab 放出一段 Minecraft 对战演示,称 TypeSafe 的 Jev 每次决策约 24 毫秒。
演示发布于 9 月 27 日。实验室说,在一块 NVIDIA B200 上跑 DJev,系统每秒最多能做 40 次决策,并把这个速度描述为快过人类反应时间。这套设计的前提是:给软件一组预先定义好的选项,让模型快速给它们打分,而不是让通用聊天模型现场生成一段回复。实现记在 Matt Mastracci(@mmastrac)名下,他的 DJev 仓库描述的正是这种结构化决策服务端。TypeSafe 9 月 15 日完成 4000 万美元种子轮,由 DCVC 领投。
局限:帖子没有公布比赛结果、对照实验或对手信息,24 毫秒和「很难打赢它」都是实验室自述,不是第三方实测;在预设动作里选得快,也不等于在生产软件里可靠。
来源:RuntimeWire · DJev 代码仓
06/10
TinyAIArena 让四个模型在 8×8 格子上对决
一个 Show HN 项目把四个模型放进 8×8 的格子里打生死局,访客可以点开任意一场旁观。
作者 hp6 把 TinyAIArena 发上 Hacker News,说它针对的是「点进一个 AI Arena、期待一场恶战,结果只看到一张跑分表」的失望。页面上每一场对局都可以点进去观战,代码放在 ai-arena 仓库,README 把规则写全了:
- 胜负:最后存活的模型获胜,违规动作由服务端裁判驳回
- 行动:每轮行动顺序随机;移动、攻击(15–24 点伤害)、等待各耗 1 点行动力
- 地图与道具:8×8 棋盘上随机放 4 个障碍格;拾取金币 +1 行动力,击杀 +1 行动力并回 50 HP
- 排名:排行榜按 Elo 计算
帖子在约 8 小时内拿到 93 分、40 条评论。
局限:胜负与排名都出自这个项目自己的服务端裁判和 Elo 排行榜,不是独立评测;本条的证据只有作者自述与代码仓,Hacker News 讨论只能算线索。
来源:Show HN 讨论 · ai-arena 代码仓
07/10
Engram 用机上小模型把 AI 幻觉做成声音
Thoughtful Things 给它的第一台乐器 Engram 开了 Kickstarter:一台用 AI 揉碎输入音频、甚至凭空生成声音的采样器。
Engram 是采样器加 groovebox,公司把它形容成「潜空间里的一台现场录音机」,做的是对小模型的电路弯折。它刻意不做一键出歌那种设备——目标是实验性的、听起来不对劲的声音,把 AI 音频模型推到它的边界之外。设备不联网,机上跑一颗 tiny AI;按 Kickstarter 页面的说法,这颗模型由公司自研设计并自行训练。
局限:这是众筹阶段的硬件,成品表现要等交付后才能判断,声音效果取决于那颗自研小模型;目前可依据的只有公司自述与众筹页面的描述。
来源:The Verge
区域与早期信号
08/10
匿名模型 Space Bunny 登顶 OpenRouter 调用日榜
一个没有厂商认领的匿名模型几天内冲到 OpenRouter 与 OpenCode 的调用日榜第一,量子位做了一轮编码实测。
量子位从 OpenRouter 取 API,接进 DeepSeek Harness 跑了四个随机抽取的 case。用 Three.js 搭一座带交互细节的立方体风格天坛,模型在一到两小时内跑完,还自行加了没被要求的东西:底部控制条里有夜、黎明、正午三个时刻和雨、烟两个天气开关;昼夜自动循环,一天约 3.5 分钟,时辰文字从子时走到亥时。第二题做仿苹果系统的闹钟,追加了每个月闹铃响不响的开关,起床时间设到 7:23。第三题做一个 App,首版窗口不能拖动,也没有关闭和最小化按钮。
局限:模型仍是匿名的,参数、定价与归属都要等厂商认领才知道;两张榜排的是调用量,不是能力。实测是一个人的非受控评测,模型自己也说合成鼠标事件在那个环境里会被系统丢掉一部分,拖动是否与指针同步它没法在无头环境里断言。本条目前只有中文来源(量子位),没有对应的英文报道。
来源:量子位 · @Fei2411 的原帖
09/10
FermiQLLM 1.0 在千问基座上做量子增强
清华背景的初创公司费米宇宙称推出了全链路量子增强大模型,基于 Qwen 开源基座改造。
- 公司:费米宇宙,专注 Q4AI(Quantum for AI);项目今年 3 月启动,先用 4B 小模型验证可行性,5 月正式成立公司
- 融资:种子轮累计 1 亿元人民币,投后估值约 10 亿元,资金正在陆续交割
- 做法:把张量网络、量子模拟退火、规范自由度等方法嵌进数据表征、模型结构、训练、强化、评测五个环节;不依赖容错量子计算机,在现有 GPU 上训练和部署
- 内测数字:对标同参数量级传统模型,推理性能提升超 15%、持续强化学习环节训练成本降 25% 以上;MATH-500、GPQA-Diamond、BBH 等基准相较同规模开源基座综合提升 10%~20%
局限:所有数字都来自公司内测和量子位的独家报道,没有公开的模型权重、技术报告或第三方复现,也没有披露具体参数规模与基座版本;融资还在陆续交割中。本条只有中文来源(量子位)。
来源:量子位
10/10
豆包手机助手用户在《王者荣耀》里被踢下线
搭载豆包手机助手的努比亚 NaviX Ultra 上,用户登录《王者荣耀》会被提示设备环境异常并强制下线,双方口径还没对上。
按 IT之家 9 月 27 日的消息,字节跳动旗下豆包手机助手 9 月 25 日在官方社区发文说明:从 9 月 24 日晚开始陆续收到多条用户反馈,在这台机器上登录《王者荣耀》或进行匹配对战时,会被提示设备环境异常、被强制踢下线。声明称全程未对腾讯游戏系统做任何操作,AI 不存在违规点击、外挂或模拟行为,团队仍在与腾讯相关方接洽,截至发文未收到明确回复。官方建议用户暂时不要在该机型上反复尝试登录,账号已被封禁的通过官方游戏客服渠道申诉。努比亚 NaviX Ultra 是第二代豆包手机,5999 元起。
局限:两边口径没对上——豆包侧称自己没动游戏系统,腾讯侧没有公开回应,只有知情人士称安全风险策略是为保障游戏公平、没有做针对性调整;受影响用户数与封号数都没有公开数字。本条只有中文来源(IT之家)。
来源:IT之家
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片

