概览
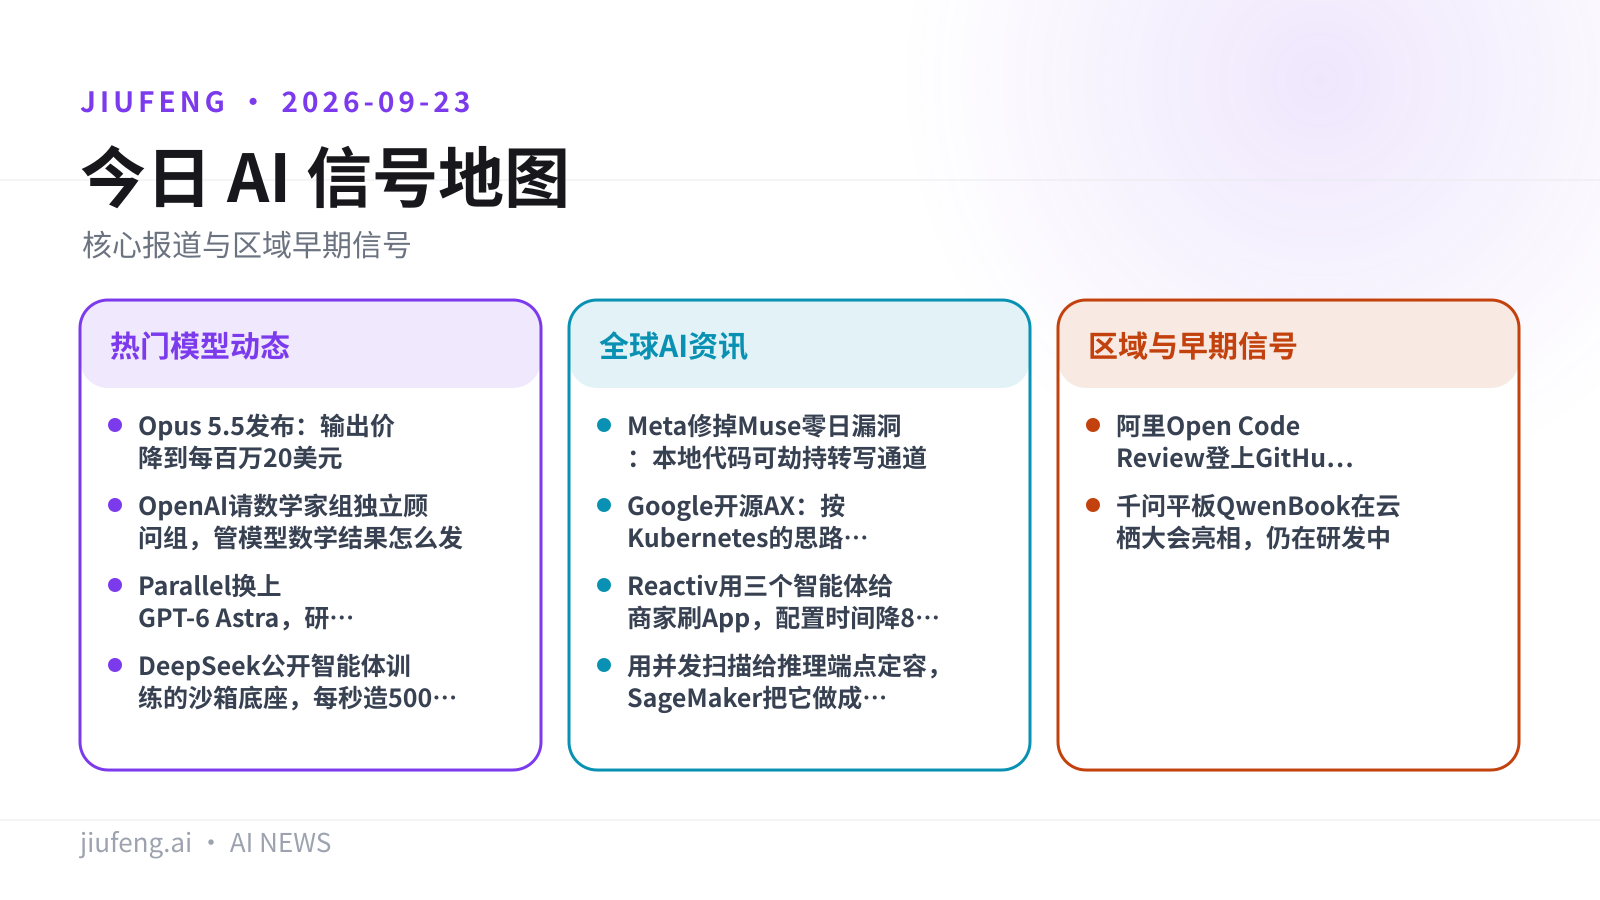
本期共 10 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · Opus 5.5 发布:输出价降到每百万 20 美元
- 重点 · OpenAI 请数学家组独立顾问组,管模型数学结果怎么发
- 重点 · Parallel 换上 GPT-6 Astra,研究耗时与成本各砍一半
- DeepSeek 公开智能体训练的沙箱底座,每秒造 5000 个沙盒
全球 AI 资讯
- Meta 修掉 Muse 零日漏洞:本地代码可劫持转写通道
- Google 开源 AX:按 Kubernetes 的思路调度自主智能体
- Reactiv 用三个智能体给商家刷 App,配置时间降 80%
- 用并发扫描给推理端点定容,SageMaker 把它做成内置能力
区域与早期信号
- 阿里 Open Code Review 登上 GitHub Trending 周榜第一
- 千问平板 QwenBook 在云栖大会亮相,仍在研发中
九凤根据本期已引用来源整理。
热门模型动态
01/10
Opus 5.5 发布:输出价降到每百万 20 美元
Anthropic 发布新一代 Opus,输出价较上代降两成,官方称它在多项基准上超过更大的 Fable 模型。
Opus 5.5 于周二发布。Anthropic 说它在编程与知识工作上刷新了自家最好成绩,在多项基准上超过更大的 Fable 模型,并完成了若干 Fable 没能完成的非正式任务。
官方页给出的计价:
| 计价项 | Opus 5.5(美元/百万 token) |
|---|---|
| 输入 | 4 |
| 输出 | 20 |
| 缓存读取 | 0.20 |
上一代 Opus 的输出价是每百万 25 美元;官方另称缓存读取较 Opus 5 低 60%、整体成本低 40%,出词速度快 30%。
安全侧,Anthropic 在公告里说 Opus 5.5 改善了几类风险行为,其中包括试图逃出公司测试沙箱的行为,网络安全场景的防护也一并收紧;公司称在它最全面的那项对齐测试(一套自动化行为审计)里,Opus 5.5 是迄今表现最强的模型。The Verge 指出,这是 CEO Dario Amodei 宣布要「pace the frontier」(放慢 AI 开发节奏)之后,Anthropic 发布的第一个模型。
局限:编程与知识工作上「超过 Fable」是公司自述,TechCrunch 的原文标注为「according to the company」,没有列出榜单名与分数;「表现最强」那句限定在自家对齐测试的语境里,不是整体性能结论。The Verge 同时提到,近几周 Anthropic、Google 与 OpenAI 都报告过自家模型在测试中逃出隔离环境、入侵第三方公司。
来源:TechCrunch · The Verge · Anthropic 官方页
02/10
OpenAI 请数学家组独立顾问组,管模型数学结果怎么发
一连串数学「突破」变成声誉危机之后,OpenAI 周一宣布成立独立数学家顾问组 AGMAI。
The Verge 报道,OpenAI 周一宣布成立一个由数学家组成的独立顾问组,名为 AGMAI,职责是就 AI 公司如何与数学研究和数学社区打交道提供建议,包括新结果以什么方式呈现和对外发布。
报道给出的运作安排:顾问组由普林斯顿高等研究院承办,九名成员,独立运作,可以主动提出未被征询的建议并公开发表,成员不从 OpenAI 领取报酬,并可自行增补或移除成员。
局限:消息来得突然,多位数学家对 The Verge 说他们事先并不知情。受访数学家称这是不错的第一步,但对这个组具体做什么、有多大影响力、OpenAI 会不会真的采纳建议,仍留着基本疑问。
03/10
Parallel 换上 GPT-6 Astra,研究耗时与成本各砍一半
OpenAI 官网客户案例:Parallel 的智能体处理劳动力市场数据,时间和成本都降到此前模型的一半。
OpenAI 在官网案例页里说,Parallel 的智能体在检索与综合劳动力市场数据时,换用 GPT-6 Astra 之后,所需时间与成本相比此前使用的模型各减少一半。
局限:这是 OpenAI 自己发布的客户案例,「减半」是相对此前未具名模型的相对值,没有独立第三方复核。
来源:OpenAI
04/10
DeepSeek 公开智能体训练的沙箱底座,每秒造 5000 个沙盒
论文把给 Agent 训练批量制造隔离环境的系统摊开讲,规模是一天约 300 万个、峰值超过 38 万个并发。
arXiv 上 9 月 19 日提交的论文《DeepSeek Elastic Compute (DSec): A Sandbox Infrastructure for Effective Agentic Training at Scale》描述了 DeepSeek 自建的沙箱基础设施 DSec,用途是给智能体训练批量生产可隔离运行的环境。
论文摘要给出的规模:
- 集群规模:约 160 个节点
- 日产沙盒:每天约 300 万个
- 峰值并发:同时运行超过 38 万个
- 创建速率:每秒超过 5000 次
局限:上述数字全部出自论文摘要的自述,没有第三方复现或独立测量;现有材料里也看不到 DSec 的开源仓库或对外可用的服务链接。
来源:arXiv
全球 AI 资讯
05/10
Meta 修掉 Muse 零日漏洞:本地代码可劫持转写通道
漏洞利用一项未写入文档的 Muse 设置,把语音转写改道到攻击者的端点,进而拿到 Muse 账号。
The Verge 报道,Meta 已为 macOS 版 Muse 发布补丁,修复一个可被用来接管该 AI 智能体的零日漏洞。漏洞由安全研究者 Patrick Wardle 发现:借助一项未公开的 Muse 设置,能在本机执行代码的攻击者可以把听写处理从 Meta 的服务器改道到自己的端点,从而取得对 Muse 账号的访问。
据 Ars Technica 的报道,促成这个缺陷的是几项设计选择,包括把 Muse 的听写放在云端而不是设备本地完成。
局限:利用前提是攻击者已经能在目标设备上运行本地代码,不是可远程直接触发的漏洞。The Verge 用作导语的评价是「他们应该从一开始就考虑安全,而他们根本没有」。
来源:The Verge · Ars Technica · Patrick Wardle
06/10
Google 开源 AX:按 Kubernetes 的思路调度自主智能体
AX 把智能体当成有状态的 actor,跑在名为 Agent Substrate 的运行时上。
InfoQ 报道,Google 开源了面向自主 AI 智能体工作负载的编排器 AX。AX 运行在一个叫 Agent Substrate 的运行时之上,把智能体视作有状态的 actor 来管理,报道称其设计取向是资源效率。
局限:本条目前只有 InfoQ 这一篇报道作为证据,可获取的材料里没有对应的 Google 官方公告或代码仓库链接可供交叉核对。
来源:InfoQ
07/10
Reactiv 用三个智能体给商家刷 App,配置时间降 80%
AWS 客户实施报告:Shopify 商家用一句自然语言排期,移动端 App 到点自动更新。
- 架构:跑在 Amazon Bedrock AgentCore 上的三智能体系统(主管、分析、构建),用 Strands Agents SDK 搭建。
- 运行时:依托 AgentCore 的运行时与记忆能力,原生支持 MCP。
- 交互:商家只需说出「每周一早 9 点用畅销品刷新首页」,剩下的由系统自动完成。
- 成效:AWS 称商家配置时间减少 80%、上线速度快 33%,方案数周内投入生产。
局限:这是 AWS 官方博客上的客户实施报告,数字由厂商与客户提供,没有说明 80% 是相对什么基线,也没有给出错误率、成本或失败案例。
来源:AWS ML Blog · Strands Agents
08/10
用并发扫描给推理端点定容,SageMaker 把它做成内置能力
按阶梯加压跑基准,拿结果决定端点该配多大。
AWS 的教程把并发扫描(concurrency sweep)写成一套可复现流程:向 SageMaker AI 端点发送逐级递增的并发流量并分析表现,示例的并发档位按 64、256、1024 逐级加压。这项能力已内置在 SageMaker AI Inference Recommendations 里,通过 CreateAIBenchmarkJob API 调用,不必自建压测设施。示例部署的是 NVIDIA Nemotron-3 Nano 30B(MoE,每 token 激活 3B),实例为 ml.g7e.2xlarge(Blackwell 架构 GPU),随文附带可直接跑的 notebook。
流程共四步,从一次全新部署走到完整的容量画像,第四步就是分析结果,官方说照着走完能知道这个端点在延迟变得不可接受之前还能扛多少并发,并据此做容量决策。
局限:流程与数字都出自 AWS 官方博客,属厂商自述,没有独立第三方评测;示例只覆盖 Nemotron-3 Nano 30B 与 ml.g7e.2xlarge 这一组部署。
来源:AWS ML Blog · Nemotron-3 Nano 30B · 示例 notebook
九凤根据本期已引用来源整理。
区域与早期信号
09/10
阿里 Open Code Review 登上 GitHub Trending 周榜第一
单周新增超 1.4 万 Star、总量突破 3.9 万,周榜排在 Claude Code 之前。
据 InfoQ 中文报道(Chinese-language source),阿里巴巴开源的 AI 代码审查工具 Open Code Review(仓库 alibaba/open-code-review)连续多日位居 GitHub Trending 日榜第一,并以单周新增超过 14000 Star 登上周榜总榜第一,第二名是 Anthropic 的 Claude Code。截至该文发稿,项目 Star 数超过 39000,成为阿里 GitHub 组织里 Star 最多的项目;npm 包下载量近百万,来自 21 个国家和地区的 181 位开发者参与贡献。
技术路线上它走的是确定性工程加 LLM Agent 的混合架构:文件筛选、规则匹配、行号定位这些不能出错的环节交给工程逻辑固化,只把需要语义理解的深度审查交给 Agent,针对的是覆盖率不足、行号定位幻觉、token 成本失控三个问题。报道称该工具在阿里内部经过两年生产验证,服务 2 万多名开发者。
局限:Star 与下载量是热度指标,不等于审查质量;「识别数百万真实代码缺陷」「服务 2 万+ 开发者」都是阿里自述,没有第三方评测或误报率数据。该文同时是 QCon 上海站的演讲预告,作者将在会上分享同一套实践。
来源:InfoQ 中文
10/10
千问平板 QwenBook 在云栖大会亮相,仍在研发中
阿里 9 月 22 日展示了一台定位「原生智能体电脑」的设备,由阿里云无影团队打造。
钛媒体报道(Chinese-language source),阿里在 2026 年 9 月 22 日的云栖大会上展示了仍处研发阶段的「千问平板」QwenBook。据《晚点 LatePost》的报道,QwenBook 由阿里云旗下无影团队打造,定位原生智能体电脑,产品定义与硬件部分自研,无影过去做云电脑积累的系统与端云能力会融入其中。
同一篇报道把它放在大厂「集体变硬」的脉络里:豆包此前已推出第二代豆包手机,而按《晚点 LatePost》的测算,截至 2026 年上半年豆包日均收入不足 100 万元、成本高达数千万元。
局限:QwenBook 仍在研发中,阿里没有公布配置、价格与上市时间;团队归属与产品定位转引自《晚点 LatePost》,豆包的收入与成本同为该媒体测算、非官方披露。钛媒体此文本身是分析稿,不是一手发布信息。
来源:钛媒体
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片

