概览
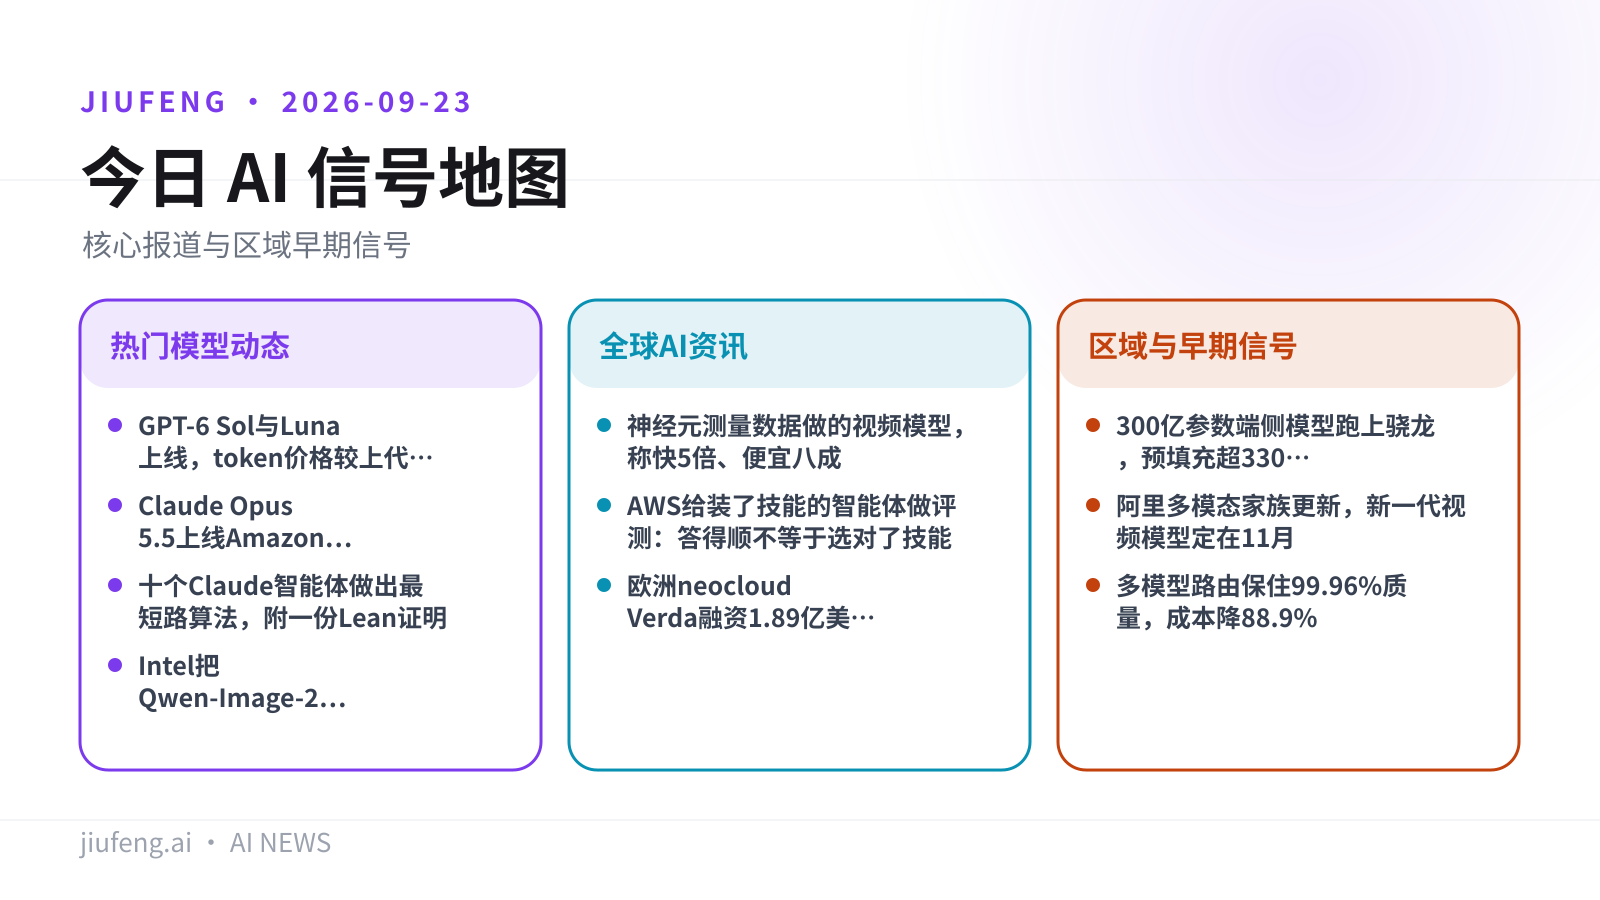
本期共 10 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
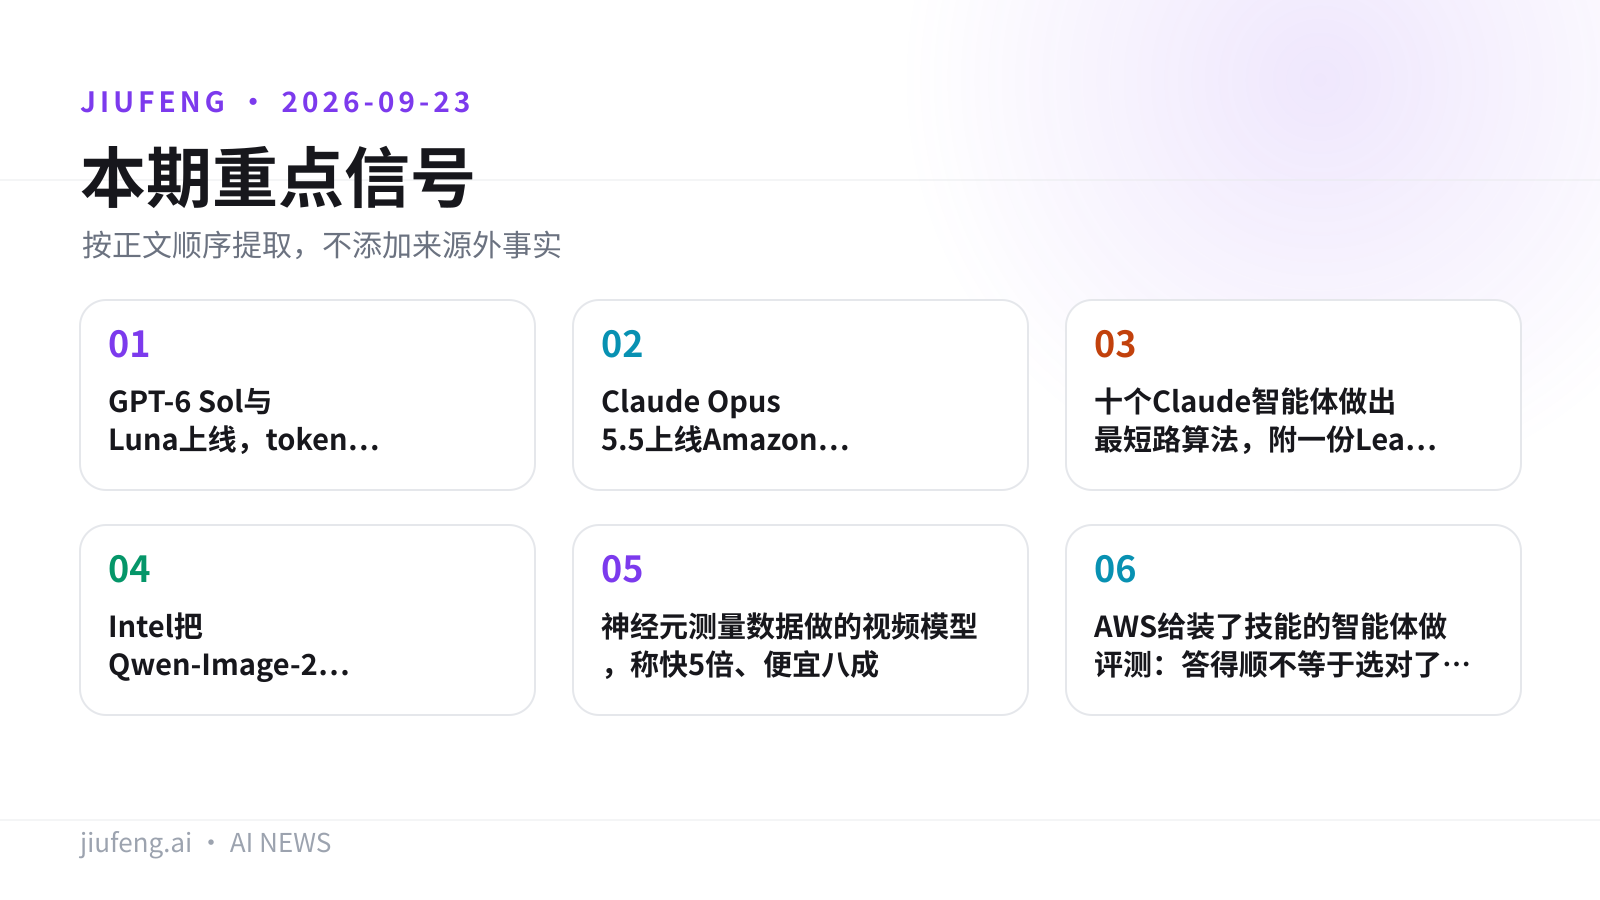
- 重点 · GPT-6 Sol 与 Luna 上线,token 价格较上代砍半
- 重点 · Claude Opus 5.5 上线 Amazon Bedrock,官方称成本比 Opus 5 低四成
- 重点 · 十个 Claude 智能体做出最短路算法,附一份 Lean 证明
- Intel 把 Qwen-Image-2.1 接进 OpenVINO,没给性能数据
全球 AI 资讯
- 神经元测量数据做的视频模型,称快 5 倍、便宜八成
- AWS 给装了技能的智能体做评测:答得顺不等于选对了技能
- 欧洲 neocloud Verda 融资 1.89 亿美元,累计超 4.5 亿
区域与早期信号
- 300 亿参数端侧模型跑上骁龙,预填充超 330 token/s
- 阿里多模态家族更新,新一代视频模型定在 11 月
- 多模型路由保住 99.96% 质量,成本降 88.9%
九凤根据本期已引用来源整理。
热门模型动态
01/10
GPT-6 Sol 与 Luna 上线,token 价格较上代砍半
OpenAI 把新一代模型铺进编码与智能体这类高频场景,价格对半砍,但独立分析没看到多少性能增量。
OpenAI 于 9 月 22 日发布 GPT-6 Sol 与 GPT-6 Luna,两款模型进入 ChatGPT Work 与 Codex,覆盖 Plus、Pro、Business、Enterprise 与 Edu 用户;Free 与 Go 订阅者可在 ChatGPT 桌面端使用 Luna。Sol 定位复杂编码与智能体流程,Luna 面向要低成本跑大批量的窄任务。OpenAI 把降价归因于缓存与推理侧的改进,称直接把节省传给用户。
| 模型 | 输入(美元 / 百万 token) | 输出(美元 / 百万 token) |
|---|---|---|
| GPT-6 Sol | 2 | 10 |
| GPT-5.6 Sol | 4 | 20 |
| GPT-6 Luna | 0.10 | 0.50 |
| GPT-5.6 Luna | 0.20 | 1.20 |
局限:The Decoder 引述的独立分析认为两款模型相对上代几乎没有性能变化,主要差别就是价格;原先价位最低的 Terra 已经下架;两款模型在发布时都不进入普通 Chat 界面。
来源:RuntimeWire · The Decoder · OpenAI 公告 · GPT-6 Sol 文档
02/10
Claude Opus 5.5 上线 Amazon Bedrock,官方称成本比 Opus 5 低四成
Claude 5.5 家族的第一款模型同日开卖,卖点是同等表现下更省 token。
Claude Opus 5.5 在 Amazon Bedrock 与 AWS 上的 Claude Platform 可用。Anthropic 称它在多数任务上与 Claude Fable 5.1 持平,运行成本比 Opus 5 低约 40%:单 token 价格下调、缓存读取更便宜,叠加「同样的活用更少 token」的效率变化。自适应思考默认常开,由模型自己决定每个任务要花多少推理,开发者用 effort 参数代替手动设置思考预算。Sonnet 5.5 与 Haiku 5.5 预计未来几周发布。
| 模型 | Terminal-Bench 4.0(%) | FrontierCode v1.1 Main(%) |
|---|---|---|
| Claude Opus 5.5 | 66.4 | 54.4 |
| Claude Fable 5.1 | 55.8 | 50.3 |
| Claude Opus 5 | 52.3 | 48.0 |
| GPT-6 Astra | 57.9 | 53.3 |
| GPT-5.6 Sol | 37.3 | 47.5 |
局限:表中成绩是 Anthropic 自己公布的基准,「成本低约 40%」同样是厂商口径,AWS 的公告也以「据 Anthropic」转述。The Decoder 提到,被分类器标记为生物学或前沿 LLM 开发的请求会被转到 Opus 5 处理。
来源:AWS Machine Learning Blog · The Decoder
03/10
十个 Claude 智能体做出最短路算法,附一份 Lean 证明
评测公司 Vals 放出的不是一个分数,而是一个可以自己去查的形式化证明包。
Vals AI 的研究员 Geby Jaff 在 9 月 20 日说,十个 Claude Opus 5.5 智能体用大约 15 小时设计出名为 C-HD 的最短路算法,并产出一份 Lean 证明,覆盖正确性与运行时间上界。对照的标尺是 Dijkstra 算法在合适优先队列下的 O(m + n log n),其中 n 为顶点数、m 为边数。Vals 由 Rayan Krishnan 与 Langston Nashold 创立,商业前提是模型买家需要基于真实工作的评测,而不是厂商自选的分数;这次他们把证明包整个公开。
局限:这是一个数学结论,不是实测加速——RuntimeWire 明确写它「不是一次测量出来的提速」。证明里的界只在一段指定范围内成立,公式中出现 ⌊log₂ n⌋^(3/4);范围之外,形式化程序回退到 Bellman-Ford,并不主张 C-HD 的改进界处处成立。实际速度与算法的新颖性仍需另行检验。
来源:RuntimeWire · Lean 证明包 · 对照论文
04/10
Intel 把 Qwen-Image-2.1 接进 OpenVINO,没给性能数据
宣传里的「day-zero 支持」,落到文档上是一条经 Optimum Intel 的部署路径,带一条失败记录。
Intel 为 Qwen-Image-2.1 这款 Diffusers 图像生成与编辑模型增加了 OpenVINO 部署路径,Qwen 官方账号随后转发了 Intel 的公告。
- 部署路径:Optimum Intel + Diffusers,模型导出走 Optimum 的 OpenVINO exporter
- 兼容性依据:Optimum Intel 的兼容性文档列出了它支持的 Diffusers 架构,这是 Intel 公告背后最清楚的一份对照表
- 官方口径:Intel Devs 在 X 上称这是 day-zero 的 OpenVINO 支持
局限:一次 OpenVINO GenAI 测试拒绝了转换后的模型,报 QwenImage21Pipeline 不受支持;配套 notebook 仍标为实验性;两边的发布材料都没有给出 OpenVINO 专属的性能结果。按 RuntimeWire 的说法,这比「OpenVINO 支持」这个说法听起来的范围要窄,开发者上生产前还得自己补验证。
来源:RuntimeWire · Optimum Intel 兼容性文档 · Qwen-Image-2.1 仓库 · Intel Devs
全球 AI 资讯
05/10
神经元测量数据做的视频模型,称快 5 倍、便宜八成
一家旧金山初创公司和 AWS 一起卖「源自神经元」的文生视频模型,目前能拿到的只有一个等候登记页。
The Biological Computing Co.(TBC)宣布与 AWS 合作,推出双方称之为首个「neuron-derived」的 AI 视频模型。按新闻稿的说法,这个文生视频模型建在一个开源视频模型之上,靠一层来自真实神经细胞测量数据的软件层,做到生成速度比基座模型快 5 倍、推理成本低 80%,质量还更好。TBC 计划把模型跑在 AWS Trainium 芯片上,通过 Amazon SageMaker AI 提供服务,并在 AWS Marketplace 上售卖。
局限:TBC 没有说基座是哪个开源模型。The Decoder 指出这些都还停在纸面上——目前唯一可用的东西是一个早期访问登记入口。
来源:The Decoder
06/10
AWS 给装了技能的智能体做评测:答得顺不等于选对了技能
技能按开放标准写进 SKILL.md,但没有评测就无法证明智能体挑对并照做了。
AWS 在博客里给出用 Strands Evals 与 Amazon Bedrock AgentCore 评测「带技能的智能体」的做法。技能是一份可复用的指令集,通常存成 SKILL.md 文件,教智能体做某个领域任务,比如给合同打码、核对发票、遵守团队的 PR 约定。因为技能遵循开放的 Agent Skills 标准,它可以在兼容的 harness 之间移植,智能体在运行时只加载需要的那一个,而不必把所有流程都塞进核心指令。
一个技能打包这几样东西:
- 领域指令:注入上下文的做法与约束
- 工具绑定:依赖的 API、MCP 服务器或本地命令
- 参考知识:完成任务要用到的资料
- 工作流:这件事按什么步骤推进
- 护栏:哪些边界不能越
局限:这是 AWS 自己的官方博客,给的是方法与示例,没有第三方对照数据,也没有给出「选对技能」的通过率基线。
07/10
欧洲 neocloud Verda 融资 1.89 亿美元,累计超 4.5 亿
赫尔辛基这家公司自己写编译器和推理服务软件,卖的是企业级托管推理。
Verda Cloud Oy(原名 DataCrunch)宣布完成早期轮融资,用于扩张从算力到平台服务的 AI 云基础设施。
- 本轮:1.89 亿美元 B 轮,Emergence Capital 领投
- 跟投:MUFG Innovation Partners、Supermicro、Varma、Lifeline Ventures、6 Degrees Capital、byFounders、Tesi
- 天使:Meta AI 系统总监 Ola Tørudbakken、Core Automation 联合创始人 Mark Saroufim
- 累计:股权加债务超过 4.5 亿美元
- 做什么:面向企业的大规模托管推理,自研编译器与推理服务软件,自建性能与可靠性工程团队
局限:SiliconANGLE 的报道没有披露公司估值、在运算力规模或客户数量,也没有给出推理服务的价格与性能指标。
来源:SiliconANGLE
九凤根据本期已引用来源整理。
区域与早期信号
08/10
300 亿参数端侧模型跑上骁龙,预填充超 330 token/s
骁龙峰会上演示的手机智能体,模型不出本地,内存占用被压掉一半以上。
夏威夷时间 9 月 22 日的 2026 骁龙峰会上,高通宣布携手阶跃、无量火与江波龙,在第六代骁龙 8 超级至尊版平台上完成阶跃 StepEdge-Omni 30B-MoE 的端侧适配与推理优化,并现场演示了智能体助手。
- 模型:300 亿参数,混合专家架构,按任务只激活部分专家以降低计算量与内存带宽需求
- 吞吐:预填充超过每秒 330 个 token,解码超过每秒 28 个 token
- 内存:合作方通过推理引擎、异构调度与存储方案优化,运行内存需求较行业常规方案降低超过 50%
- 演示任务:不调云端,本地完成邮件理解、行程规划、日历同步、航班与酒店推荐、行程分享与邮件草拟
局限:本条目前只有中文媒体报道,高通没有公布测试机型、量化方案、功耗与续航数据,也没有给出与其他端侧方案的对照。IT之家引述业内人士称,大参数 MoE 上手机能否规模化,仍取决于终端成本、功耗、模型可靠性与用户接受度。
来源:IT之家
09/10
阿里多模态家族更新,新一代视频模型定在 11 月
图像、音乐与长视频创作引擎一起换代,公开材料里没有参数与基准。
阿里巴巴更新了多模态生成模型家族,本次发布包括图像生成模型 Qwen-Image-3.1、音乐生成模型 Happy Shrimp 1.1,以及面向长视频和复杂创作的 Agentic PE(智能体式创作引擎),新一代视频生成模型将在今年 11 月发布。按 InfoQ 的梳理,这条线的前两站是 2025 年底的 Wan 2.6(支持智能分镜调度、参考生视频、多角色一致性)与今年 4 月的 Happy Horse 1.0(单流 Transformer,原生联合生成音频与视频)。阿里 ATH 技术副总裁、淘天集团首席科学家郑波在现场称,三年内会出现原生全模态统一模型。
局限:本条目前只有中文来源,报道没有给出 Qwen-Image-3.1 的参数规模、许可证与任何基准分数。稿中「导演陆川用 5 天完成过去需数月的短片制作」「模型上下文理解达到博士后水平」均为创作者与厂商在会场的说法,没有可核对的对照口径。
来源:InfoQ 中文
10/10
多模型路由保住 99.96% 质量,成本降 88.9%
把每一步交给合适的模型,是这家公司给出的降本数据,样本条件写着「特定测试配置」。
基元律动联合创始人兼 CTO 韩凯在 2026 杭州云栖大会的企业级 Agent 实践峰会上说,多模型长期异构并存、算力多元供给会是产业的长期结构,一次复杂 Agent 任务往往涉及十余次乃至数十次模型调用。该公司以开源项目 OpenSquilla 做模型路由:按其公布的端到端 Agent 评测,在特定测试配置下保留了固定旗舰模型基线 99.96% 的任务质量,同时把成本降低 88.9%;在另一组 DRACO 深度研究评测中,多模型协同配置的得分超过该组实验里的最强单模型基线,成本约为其三分之一。作为反馈闭环的验证,基于通义 Qwen3.5 底座后训练的 NeoHorse-1 在十项基准上宏平均得分从 58.94 提升到 64.87(4B)、从 65.60 提升到 69.04(9B)。
局限:本条目前只有中文来源,所有数字来自公司自述与现场演讲,「特定测试配置」的具体内容没有公开,也没有第三方复现。国家数据局披露的「2026 年 3 月日均 Token 调用量超 140 万亿」是演讲引用的行业数据,不是该公司的业务量。
来源:量子位
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片

