概览
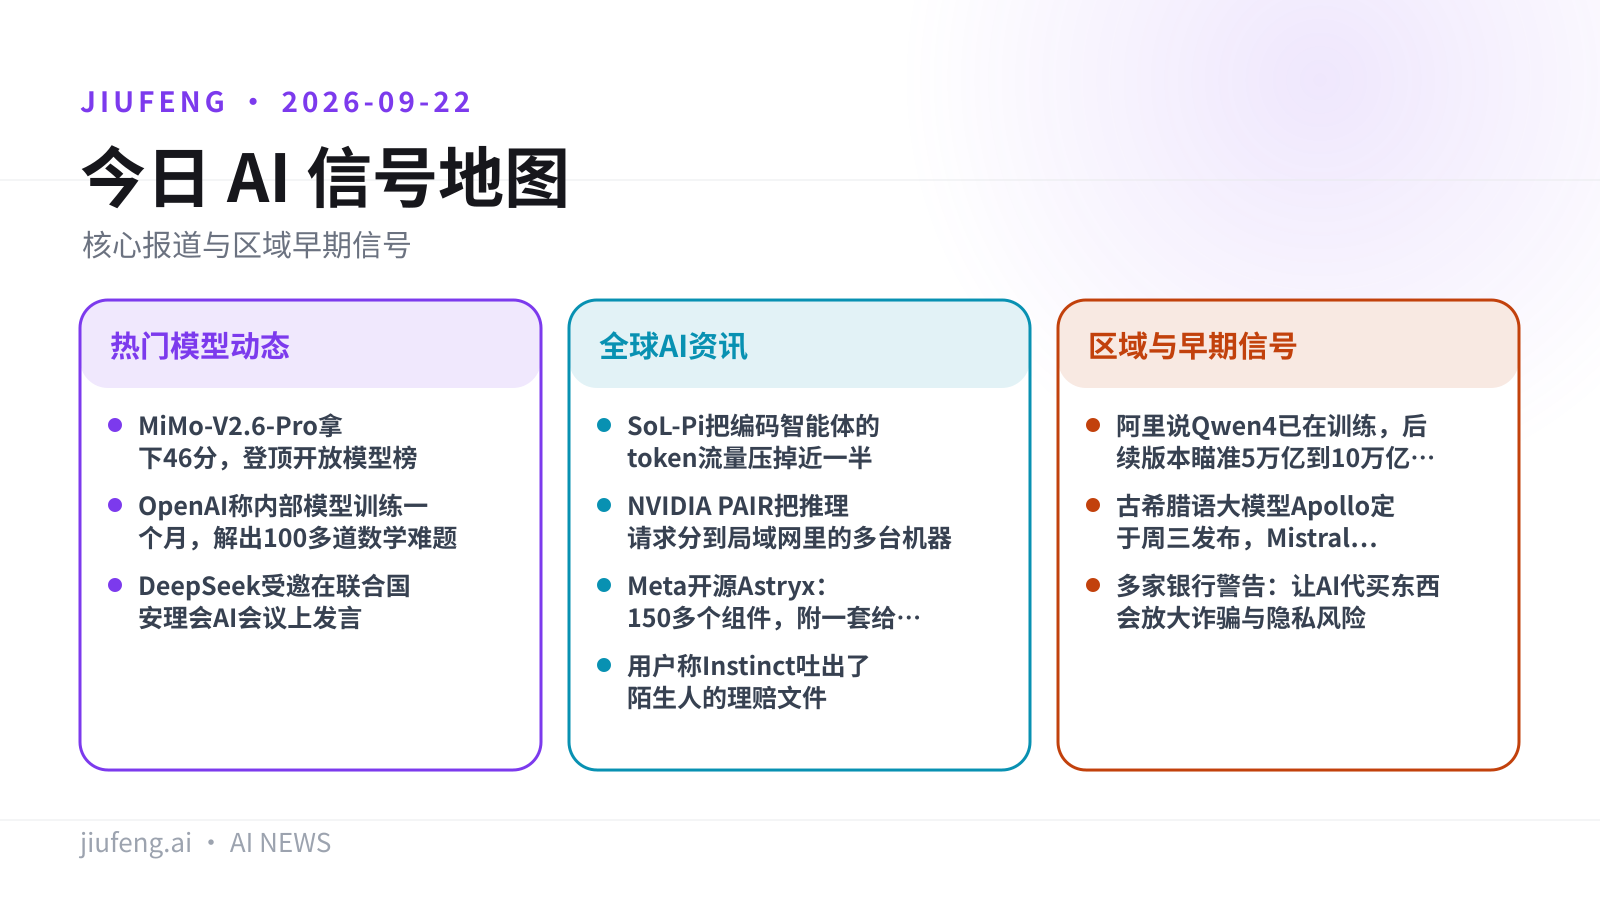
本期共 10 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · MiMo-V2.6-Pro 拿下 46 分,登顶开放模型榜
- 重点 · OpenAI 称内部模型训练一个月,解出 100 多道数学难题
- 重点 · DeepSeek 受邀在联合国安理会 AI 会议上发言
全球 AI 资讯
- SoL-Pi 把编码智能体的 token 流量压掉近一半
- NVIDIA PAIR 把推理请求分到局域网里的多台机器
- Meta 开源 Astryx:150 多个组件,附一套给 Agent 用的 MCP 工具链
- 用户称 Instinct 吐出了陌生人的理赔文件
区域与早期信号
- 阿里说 Qwen4 已在训练,后续版本瞄准 5 万亿到 10 万亿参数
- 古希腊语大模型 Apollo 定于周三发布,Mistral 参与开发
- 多家银行警告:让 AI 代买东西会放大诈骗与隐私风险
九凤根据本期已引用来源整理。
热门模型动态
01/10
MiMo-V2.6-Pro 拿下 46 分,登顶开放模型榜
小米两款新模型里更大的那款在 Artificial Analysis 智能指数上得 46 分,是当前最强的开放可用模型,同时被 Anthropic 指控靠 Claude 取数据。
小米放出 MiMo-V2.6 系列。据小米自述,两款新模型中更大的 MiMo-V2.6-Pro 在分析机构 Artificial Analysis 的智能指数(Intelligence Index)上拿到 46 分,位列开放可用模型第一,价格则大幅低于对手:
- 智能指数:46 分(Artificial Analysis 口径)
- 接口定价:每百万输入 token 0.435 美元,每百万输出 token 0.87 美元
- 单任务成本:按 Artificial Analysis 的测试口径,跑完一次测试任务约 0.13 美元
- 公开内容:技术报告、训练框架、一个可供继续训练的小模型,以及约 7000 个训练任务
The Decoder 称这次跃升来自把强化学习规模扩大后的一轮训练。
局限:同一篇报道里,Anthropic 指控小米通过 Claude 不当抽取数据来训练自家模型系列——这目前只是 Anthropic 的说法,没有第三方裁定。
来源:The Decoder · Hugging Face
02/10
OpenAI 称内部模型训练一个月,解出 100 多道数学难题
OpenAI 一边宣布新的内部模型解开百余道长期未解的数学问题,一边出资在高等研究院设一个独立顾问组。
OpenAI 表示,一款新的内部模型在训练仅一个月后,解出了 100 多道长期未解的数学问题,覆盖数学的大部分分支——这是在此前那则纳维-斯托克斯千禧难题的说法之上再加一码。与此同时,OpenAI 宣布支持在高等研究院(Institute for Advanced Study)设立一个独立顾问组,成员包括菲尔兹奖得主 Timothy Gowers,就 OpenAI 如何向研究者和公众公布结果提供建议。
局限:数学家警告,AI 生成的解答可能损害人对概念本身的理解。而 OpenAI 把自家研究的推进节奏排除在了顾问组的职责之外——顾问组能管的是「怎么公布」,不是「推进多快」。
来源:The Decoder · OpenAI
03/10
DeepSeek 受邀在联合国安理会 AI 会议上发言
路透社称 DeepSeek 拿到 9 月 23 日联合国安理会 AI 会议的发言邀请,但去不去、谁去、说什么,一概未定。
据 RuntimeWire 援引路透社报道,杭州的 DeepSeek 受邀在 9 月 23 日召开的联合国安理会人工智能与国际安全会议上发言,月之暗面等其他中国 AI 开发者也收到了邀请。DeepSeek 公开分发模型权重(如 GitHub 上的 DeepSeek-R1 仓库),同时售卖托管 API 服务。据美联社报道,创始人梁文锋是在做量化投资机构幻方之后,于 2023 年创办 DeepSeek 的。
局限:收到邀请不等于确认出席。截至 9 月 22 日,路透社既没确认 DeepSeek 的与会代表是谁,也没确认它会不会真的到场或发言,会议前一天安排仍在变动。DeepSeek 对 AI 安全、开放权重治理持什么立场,同样没有公开表述。
图片来源:GitHub;已转存至九凤 R2。
来源:RuntimeWire · GitHub · 美联社
全球 AI 资讯
04/10
SoL-Pi 把编码智能体的 token 流量压掉近一半
NVIDIA、NTU 与 MIT 给开源编码智能体 Pi 加了四项效率机制,EdgeBench 上 token 流量降 44.7%–49.0%,得分基本持平。
这四项机制不是人手调出来的,而是由一个 AI 在 harness 层跑自动研究循环发现的,MarkTechPost 称循环覆盖 535 个环境。具体数字:
- token 流量:在 51 题的 EdgeBench 评测上,相比原版 Pi 记录到的 token 流量降低 44.7%–49.0%
- API 成本:约降低 33%
- 任务得分:在 GPT-5.6 Sol 和 Opus 5 两个模型上都与 Pi 接近
- 可用性:以 NVlabs 名义发在 GitHub,MIT 许可,跑在未经修改的 Pi 发行版上;测试环境为 Pi 0.85.1 与 Node.js 22.19 及以上
局限:省下来的是 token 不是分数——得分只是「接近」Pi,并非超过。结论也只在 EdgeBench 这 51 道题上成立,且依赖对应版本的 Pi 与 Node。
来源:MarkTechPost · arXiv
05/10
NVIDIA PAIR 把推理请求分到局域网里的多台机器
PAIR 测试版把本地网络中多台机器的推理能力凑起来调度,NVIDIA 明确说它不合并 GPU、也不把显存拼成一块大卡。
NVIDIA Personal AI Router(PAIR)推出测试版,面向本地多智能体负载:主智能体把子任务分派给多个子智能体时,单块 GPU 容易被请求压垮,PAIR 作为代理接收请求,识别其引擎和模型要求后挑一个合格节点从头到尾执行,智能体侧仍然只看到一个连接。它与 Ollama、LM Studio 这类本地推理服务直接对接,不需要改底层架构或智能体框架;支持 Windows 11、Linux 和 macOS,覆盖 x64 与 arm64,还能把运行不同操作系统的节点配对。官方演示里 Hermes Desktop 把任务拆成五项专项分析,用 RTX Spark、DGX Spark 和 RTX 5090 组合执行,完成时间约为在单台 RTX Spark 笔记本上跑同一负载的一半。
局限:NVIDIA 说这个演示不构成性能保证,结果取决于工作负载并行性、模型、引擎设置、硬件、网络和节点可用性,并明确 PAIR 不会合并 GPU 或把 VRAM 整合成一个更大的加速器。公告发出后社交媒体上仍出现误读,有用户把它当成与第三方共享算力、或把几台低性能机器拼起来跑大模型的方案。
来源:InfoQ 中文 · NVIDIA 开发者博客 · InfoQ
06/10
Meta 开源 Astryx:150 多个组件,附一套给 Agent 用的 MCP 工具链
内部开发八年的 React 设计系统放出 Beta 版,工具链同时面向工程师和 AI Agent。
Astryx 基于 React 19 和 Meta 的 StyleX 构建,提供 150 多个具备可访问性的 UI 组件、可定制的 CSS Design Token,以及专门的 CLI 和 MCP 工具链。组件的行为与可访问性合规跟视觉表现解耦,后者集中在 Design Token 层定义,如配色、字体层级和边框圆角。核心包 @astryxdesign/core 在发类型化 React 组件的同时提供预编译 CSS,组件原生支持 className,可与 Tailwind、CSS Modules 或普通样式表混用;用预编译 CSS 和 className 时不需要额外配置编译器。
局限:目前是 Beta 版。定制能力有边界——Design Token 和标准 React 组合模式能改外观与行为,但若定制需要触及未对外暴露的内部实现,例如私有状态、DOM 结构或拿不到的事件监听器,就只能用 CLI 的 swizzle 命令把组件源码整份导出到自己的仓库。
07/10
用户称 Instinct 吐出了陌生人的理赔文件
截图显示 Instinct 端出了一份理赔文件的信息,还给出「对话串错了」的解释——而这份文件可能根本不存在。
9 月 21 日,用户 Pritak(@prit4k)在 X 上贴出与 Noah Shinn 的 AI 助手 Instinct 的对话截图:他问 Instinct,那份被助手称作 Gerber 理赔文件上署的是谁的名字,Instinct 回了他的名字、一个中间名和一个地址。Pritak 说中间名是错的,相关时期他并不住在那个地址,而且他从没给 Instinct 发过照片。Instinct 随后声称自己查了记录,发现 Pritak 的消息里只有文字。
局限:两种性质完全不同的故障都能解释这些截图——要么 Instinct 真的把别人的文件内容送了出来,要么它连文件带「混淆经过」一起编了出来。截图本身无法判定是哪一种,助手自己的说法也不能当证据。TechCrunch 8 月 24 日已报道过 Instinct 在数据管控上受到的质疑。
来源:RuntimeWire · X · TechCrunch
区域与早期信号
08/10
阿里说 Qwen4 已在训练,后续版本瞄准 5 万亿到 10 万亿参数
云栖大会上,阿里把「模型自己改自己」摆成主线,并给出了 Qwen4 之后的参数路线。
据量子位报道,阿里在 9 月 22 日云栖大会上称,递归自我改进(RSI)已初步进入模型训练、推理及芯模协同环节:
- 自我训练:Qwen3.8-Max 自主搭训练流程、构造数据、设计实验并定位缺陷,在人类零参与下持续迭代超过 1 个月,完成 33 轮有效迭代,Artificial Analysis 得分从 40 涨到 45
- 推理优化:在从未见过的平头哥新款 GPU 上,自主适配下代架构的 Qwen3.8-Flash 推理框架,单实例推理吞吐量提升 96%
- 芯片协同:仅凭一份真实的总线模块规范,自主跑完前端、验证、后端全链路,运行超 60 小时、调用 EDA 工具超万次,拿到面积减少 42% 的物理实现
- 路线:Qwen4 正采用全新架构训练,Qwen4.5、Qwen5 计划把总参数量推到 5 万亿至 10 万亿
阿里同时称已开源 460 余个 Qwen 模型,Qwen3.8-27B 是 Hugging Face 上历史最受欢迎(Most Likes)的开源大模型,排在 DeepSeek-R1、Meta-Llama3.1 之前。
局限:以上全部是阿里在自家大会上的口径,33 轮迭代、96% 吞吐、42% 面积这些数字都没有第三方复核。Qwen4 只说「正在训练」,5 万亿到 10 万亿是计划参数量,不是已交付的模型。本条目前只有中文来源。
来源:量子位
09/10
古希腊语大模型 Apollo 定于周三发布,Mistral 参与开发
奥地利科学院联合 Mistral 和 Sail Reply 做了一个专攻古希腊语的模型,用来补莎草纸残片上缺的词句。
据 IT之家援引《连线》报道,奥地利科学院将于当地时间周三发布 Apollo,训练素材取自手稿、莎草纸与石刻铭文,总计约 6 亿个古希腊历史词汇,研究人员可通过聊天机器人界面免费使用。面对破损文献,Apollo 基于统计概率给出可能性最高的词句来填补空白。奥地利科学院的莎草纸学者 Anna Dolganov 说,模型会按文本类型切换语体:识别到荷马文本就用荷马时代的古希腊语,遇到多利亚方言石刻铭文就切换为多利亚方言。
局限:伦敦大学学院教授 Stephen Colvin 说:「普通读者或许会以为我们一下子就能发掘出索福克勒斯几部失传的戏剧,但这并不会发生。」报道提到,大量莎草纸迟迟没修复,本就是因为记载的多是私人信件、婚约和行政文书。补全结果出自统计概率,仍需学者判定。本条目前只有中文来源。
来源:IT之家
10/10
多家银行警告:让 AI 代买东西会放大诈骗与隐私风险
国民西敏、美国银行等在一份报告里说,AI 代购的发展速度已经超过了行业标准和消费者保护机制。
据 IT之家援引路透社 9 月 22 日报道,国民西敏银行、美国银行、ING、新西兰 ASB 银行和第一资本金融参与的报告警告,让 AI 智能体代替消费者网购会增加诈骗、欺诈和数据隐私泄露风险:智能体可能要求消费者提供银行卡信息再直接输入购物网站,也可能把用户引向消费者保护力度较弱的支付方式。需求确实在涨——英国零售商约翰·刘易斯百货 9 月称,来自 AI 智能体的搜索占比已从一年前的 0.3% 升至 2.5%,增速还在加快。这些银行计划与政策制定者讨论几项提议:要求明确披露 AI 智能体是否参与交易、提高决策过程透明度、建立客户数据保护机制,并让消费者和商户能自由选择 AI 电商服务、不同系统之间实现互操作。
局限:这些只是银行方面的提议,没有任何监管机构表态,也没有时间表;报告没有量化智能体购物已造成的损失规模。本条目前只有中文来源。
来源:IT之家
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片

