概览
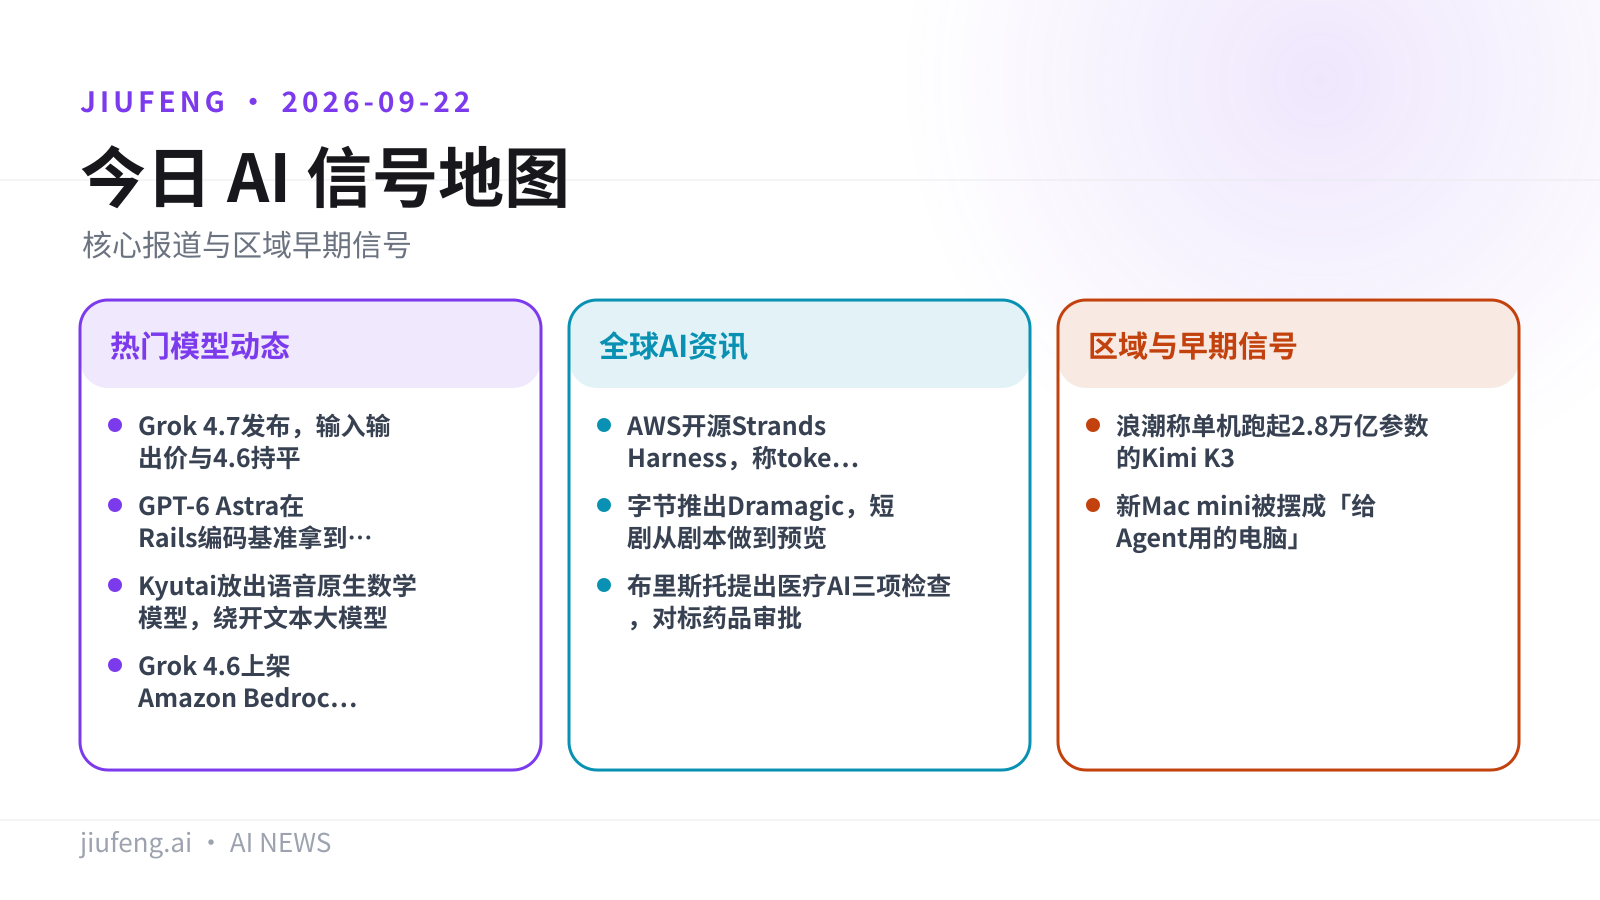
本期共 10 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · Grok 4.7 发布,输入输出价与 4.6 持平
- 重点 · GPT-6 Astra 在 Rails 编码基准拿到 53.3%
- 重点 · Kyutai 放出语音原生数学模型,绕开文本大模型
- Grok 4.6 上架 Amazon Bedrock,500K 上下文四档推理
- 亚马逊封禁 Meta 的 Muse 智能体,不许代客下单
全球 AI 资讯
- AWS 开源 Strands Harness,称 token 成本低 28%
- 字节推出 Dramagic,短剧从剧本做到预览
- 布里斯托提出医疗 AI 三项检查,对标药品审批
区域与早期信号
- 浪潮称单机跑起 2.8 万亿参数的 Kimi K3
- 新 Mac mini 被摆成「给 Agent 用的电脑」
九凤根据本期已引用来源整理。
热门模型动态
01/10
Grok 4.7 发布,输入输出价与 4.6 持平
SpaceXAI 把更大的基座模型定在和上一代一样的 2/6 美元价位,竞争点放在完成一整件长任务的成本上。
马斯克 SpaceX 内部的 AI 团队 SpaceXAI 于 9 月 21 日发布 Grok 4.7,距 Grok 4.6 只隔 40 天。官方口径是一个更大的基座模型,能在困难的编码和知识工作任务上坚持更久,而标准 token 价格不变。
- API 定价:输入 2 美元 / 百万 token,输出 6 美元 / 百万 token,与 Grok 4.6 相同
- 分发渠道:Cursor、Grok Build 与 x.ai API 同步可用
- 规格:开发者文档列出 50 万 token 上下文窗口,知识截止到 2026 年 5 月
- 智能体:SpaceXAI 的发布帖称新模型原生理解 Grok Bot 智能体框架,面向软件仓库之外的对话、调研与文档生成
- 母公司背景:SpaceX 于 2 月 2 日收购 xAI,6 月招股书把这笔收购称为新设 AI 板块的基础,并称将投入大量资本做算力基建
来源另设一节给出与上一代的逐项对比:
| 口径 | Grok 4.7 | Grok 4.6 |
|---|---|---|
| CursorBench 4.0 | 46.3%(xhigh 档) | 40.4%(high 档) |
| Cursor 自测(同档) | 43.9% | 40.4% |
| 单任务成本 | 4.69 美元 | 5.20 美元 |
| DeepSWE v1.1 | 71% | — |
来源同时称,Grok 4.7 在 Terminal-Bench 4.0、电气工程与 Harvey 上相对 4.6 有更大的增益。
局限:上表第一行不是同档对比——4.7 取的是 xhigh、4.6 取的是 high,只有 Cursor 自测那一行是同档口径。「能在长任务上坚持更久」是 SpaceXAI 自己的产品定位说法,不是第三方评测结论。
来源:RuntimeWire · SpaceX 收购 xAI 公告 · Grok 4.7 开发者文档
02/10
GPT-6 Astra 在 Rails 编码基准拿到 53.3%
Rails 把所有模型推到最高推理档,只有 OpenAI 的模型把钱换成了分数,总账单几乎翻倍。
Rails 基金会 9 月 21 日在 X 上公布,其功能开发基准把每个符合条件的模型都调到可用的最高推理档重跑。GPT-6 Astra 保住第一,解题率从中档的 35% 升到最高档的 53.3%,60 次运行中通过 32 次;Claude Fable 5.1 在 high 与 maximum 两档都是 19 次通过,准确率停在 31.7% 不动;Gemini 在最高档反而退步。此前零分的一个 OpenAI 模型这轮完成了 16 次运行。
| 口径(最高推理档) | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| 准确率 | 53.3%(中档 35%) | 31.7%(与 high 档相同) |
| 通过数 / 60 | 32(原 21) | 19(原 19) |
| 整场成本 | 397.62 美元(原 150.47) | — |
| 单次均价 | — | 19.10 美元(原 9.14) |
局限:Rails 的结论是额外推理并不稳定换来更好的代码——各模型增益从 0 分到 27 分不等,而整体账单几乎翻倍。评测本身也有边界:每次运行限 90 分钟、400 步、60 美元,模型不联网、也不给额外的智能体脚手架,任务与核验材料是冻结的。
图片来源:GitHub;已转存至九凤 R2。
来源:RuntimeWire · Rails 基金会 X 帖 · rails/ai-evals
03/10
Kyutai 放出语音原生数学模型,绕开文本大模型
口头出题、开口作答,中间不转写也不过文本模型,GSM8K 最高 77.1%。
巴黎的 Kyutai 于 9 月 21 日在 X 上用五条帖子发布 Voice of Reason:两个语音原生模型直接接收口述数学题并出声作答,不经过转写系统,也不把推理交给单独的文本语言模型。配套论文已被 COLM 2026 接收,作者为 Kyutai 博士生 Timothee Weisselberger、Edouard Grave 与研究负责人 Alexandre Defossez。
技术路线是在 Z.ai 的 GLM-4-Voice 上改后训练而不动架构——GLM-4-Voice 生成时交替输出文本与音频 token。Kyutai 由此得到两个检查点:一个不带隐藏推理 token 直接作答,另一个一边说一边分块静默推理。
局限:GSM8K 最高 77.1%,但更大的级联系统(先转写、再送文本模型)在该基准上仍然领先;报道同时指出这两个模型的通用知识表现更弱,是专门化过头的代价。
来源:RuntimeWire · Kyutai X 帖 · 论文 · 免推理检查点
04/10
Grok 4.6 上架 Amazon Bedrock,500K 上下文四档推理
xAI 在 Bedrock 的第二个模型,这次两个端点都能调,还支持 Converse API。
AWS 于 9 月 21 日宣布 xAI 的 Grok 4.6 已在 Amazon Bedrock 可用,面向长周期智能体、编码与知识工作。
- 上下文:500K token
- 推理档位:low、medium、high、xhigh 四档可配
- 接入面:bedrock-mantle 与 bedrock-runtime 两个端点,支持 Converse 以及 Chat Completions、Responses
- 序列:xAI 在 Bedrock 的第二个模型;上一个 Grok 4.3 转正时 xAI 才成为 Bedrock 模型供应方,当时只能通过 OpenAI 兼容引擎 Bedrock Mantle 访问
局限:AWS 在文中说明,Grok 4.6 的能力与训练描述均来自 xAI 自己的发布公告,不是 AWS 的独立评测;另外这篇 9 月 21 日的博客里记的 Bedrock 上线日期是 2026 年 8 月 18 日。
来源:AWS Machine Learning Blog · xAI Grok 4.6 公告
05/10
亚马逊封禁 Meta 的 Muse 智能体,不许代客下单
上架五天下载破 73 万、刚登上 App Store 免费榜首的智能体,被挡在亚马逊电商站外。
亚马逊已禁止 Meta 的 Muse 智能体访问其电商市场,并在周日晚间通知了用户。Muse 本月早些时候以手机应用形式在美国上线,五天内下载量超过 73 万次,排在 ChatGPT 与 Claude 之前;上周五超过 ChatGPT,成为 App Store 免费榜第一。Meta 同时提供免费版和两个速率上限更高的付费版。
亚马逊就此向 GeekWire 出具了书面声明,SiliconANGLE 的报道另援引了 GeekWire 关于「未披露的第三方在客户账户中活动」的报道内容。
局限:73 万次下载与 App Store 排名都是报道转述的第三方数据,不是 Meta 的官方披露;报道也没有说明封禁的技术手段与生效范围。
来源:SiliconANGLE
全球 AI 资讯
06/10
AWS 开源 Strands Harness,称 token 成本低 28%
一行代码起步的通用智能体外壳,Apache 2.0,Python 与 TypeScript 双版本。
AWS 的 Strands Agents 团队发布 Strands harness——一个装配好的通用智能体外壳,本地可跑,也能部署到云上。所谓 harness 指模型之外的那一层:循环、工具、上下文处理、记忆与恢复;Strands 此前只通过 SDK 暴露这些积木,这次把它们打包成可直接用的默认配置。
- 许可与语言:Apache 2.0,Python 与 TypeScript
- 模型后端:Amazon Bedrock、Anthropic、OpenAI、Google、Ollama 或 LiteLLM
- 自带工具:shell、文件读写等
- 成本口径:跑同样的 Claude 或 GPT 模型,团队称在 6 个基准上比其它 harness 低 28% 成本、准确率接近;6 个基准为 ALFWorld、ContextBench、GAIA、WebShop、τ²-bench 等的平均
- 对比对象:图表点名的竞品为 Claude Code、Codex、oh-my-pi、OpenCode 与 DeepSeek Harness,并在 Terminal-Bench 2.1 上给出同一模型下五个 harness 的成本与准确率逐项对照
- 部署:附带 skills 文件,可让编码智能体生成 AWS、GCP、Azure、Cloudflare、Modal 的部署配置
局限:28% 这个数字由 AWS Strands 团队自己给出,不是第三方复现。
来源:MarkTechPost · GAIA 基准
07/10
字节推出 Dramagic,短剧从剧本做到预览
一条流水线覆盖剧本分析、角色创建、分镜到视频预览,走 BytePlus 企业渠道申请开通。
字节跳动发布 Dramagic,一个面向短剧与视频制作的 AI 平台,覆盖剧本分析、角色创建、分镜与视频预览全流程,支持多人同时协作,并内置一致性检查。该平台通过字节的企业平台 BytePlus 售卖,需申请获取访问权限。
The Decoder 同时援引了这个市场的规模数据:据中国网络视听协会,2026 年第一季度中国上线短剧约 12.8 万部,是去年全年总量的三倍,其中 95% 为 AI 生成;清华大学教授沈阳称一分钟 AI 视频成本约 90 至 120 美元,约为传统制作的十分之一;该行业直接雇佣 69 万人。
局限:Dramagic 只走企业申请制,报道没有公布定价与所用模型细节。报道还提到,有演员被要求先把声音和肖像交给 AI 工具、随后被裁——这是转述说法。
来源:The Decoder · BytePlus 公告
08/10
布里斯托提出医疗 AI 三项检查,对标药品审批
研究者说医学早就有一套对付黑箱的办法,医疗 AI 可以照抄。
布里斯托大学的研究者提出名为 Learning Ensemble 的框架,让开发者按药品上市审评的标准,系统性地检验医疗 AI 系统的可靠性。框架规定三个检查面:系统的适用边界与训练数据、在所有患者群体上的可靠性、以及在日常临床中的实际适配度。
研究者给出的动因是:医疗 AI 常在早期测试中表现良好,一到临床就失效,因为它抓住的是训练数据里与诊断无关的特征;而医学面对作用机理尚未完全清楚的药物时,已经发展出处理这种不确定性的办法。
局限:这目前是论文提出的检查框架,来源只列出三个检查方向,没有给出已用它审过的具体系统或通过率。
来源:The Decoder · 论文(arXiv)
区域与早期信号
09/10
浪潮称单机跑起 2.8 万亿参数的 Kimi K3
128 颗本土 AI 芯片紧耦合,官方称 Token 生成时延降到 5.85 毫秒。
在 9 月 21 日的 2026 人工智能计算大会上,浪潮信息发布元脑 SD200 Ultra 超节点 AI 服务器与元脑 HC2000 多元算力机组。官方称 SD200 Ultra 基于国产 AI 芯片打造,单机可承载 2.8 万亿参数的 Kimi K3,并支持 10 万亿参数级前沿模型单机运行。
- 规模:3D Hyper Mesh 架构,紧耦合 128 颗本土 AI 芯片,8TB 统一编址显存、64TB 内存
- 时延:Token 生成时延首次降至 5.85 毫秒以内,官方折算为单用户 170 Tokens/s
- 互连:原生内存语义通信时延 0.69 微秒;对称内存技术让 GPU 直接访问远端 GPU 显存,AllReduce 通信时间降低 3.5 倍
- 算子:用 Kimi K3 构建超级算子智能体,融合 KDA、Gated MLA、MoE 中的基础算子,算子数量降低 10 倍、推理性能提升 3 倍以上
浪潮给出的判断是参数规模仍在往上走:从 DeepSeek R1 的 6710 亿到 Kimi K3 的 2.8 万亿,上下文从 128K 扩到 1M 以上,Agent 从单体走向成百上千个协同,时延会在「推理—工具调用—反馈—重新规划」的每一轮里累积。
局限:这条只有中文来源,且上述数据全部出自浪潮信息在自家大会上的口径——「达到业界平均水平的 5 倍」「同等投资下 Token 产能提升 10 倍」都没有公开测试方法或第三方复现。
来源:IT之家
10/10
新 Mac mini 被摆成「给 Agent 用的电脑」
苹果把这台 6999 元起的小盒子描述为可以全天候跑智能体的桌面机。
爱范儿拿到一台 M5 Pro、48GB 内存 + 2TB 存储的新 Mac mini,到手价 25749 元,而入门款为搭载 M6 芯片的 16GB + 256GB 版本,6999 元起。文章的观察是 AI PC 的竞争点正从「能不能跑模型」移到「能不能让 Agent 在这台机器上长期工作」:LM Studio Bionic、端侧模型、智能体与 exo 集群成了新 Mac mini 的主打,苹果本身也把它描述为能全天候运行智能体的桌面电脑。评测中这台高配机器可以装下 270 亿参数的本地模型。
局限:这条只有中文来源,属媒体实测口径。文中「OpenAI 采购数万台 Mac mini 和 Mac Studio 训练模型、Anthropic 在 AWS 上租用大量 Mac 服务器」是爱范儿的转述,未给出出处;270 亿参数是在 48GB 高配机上的结论,6999 元的 16GB 版本按文中说法价值在于给 Agent 提供一个能持续工作的地方,而非本地部署大模型。
来源:爱范儿
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片

