概览
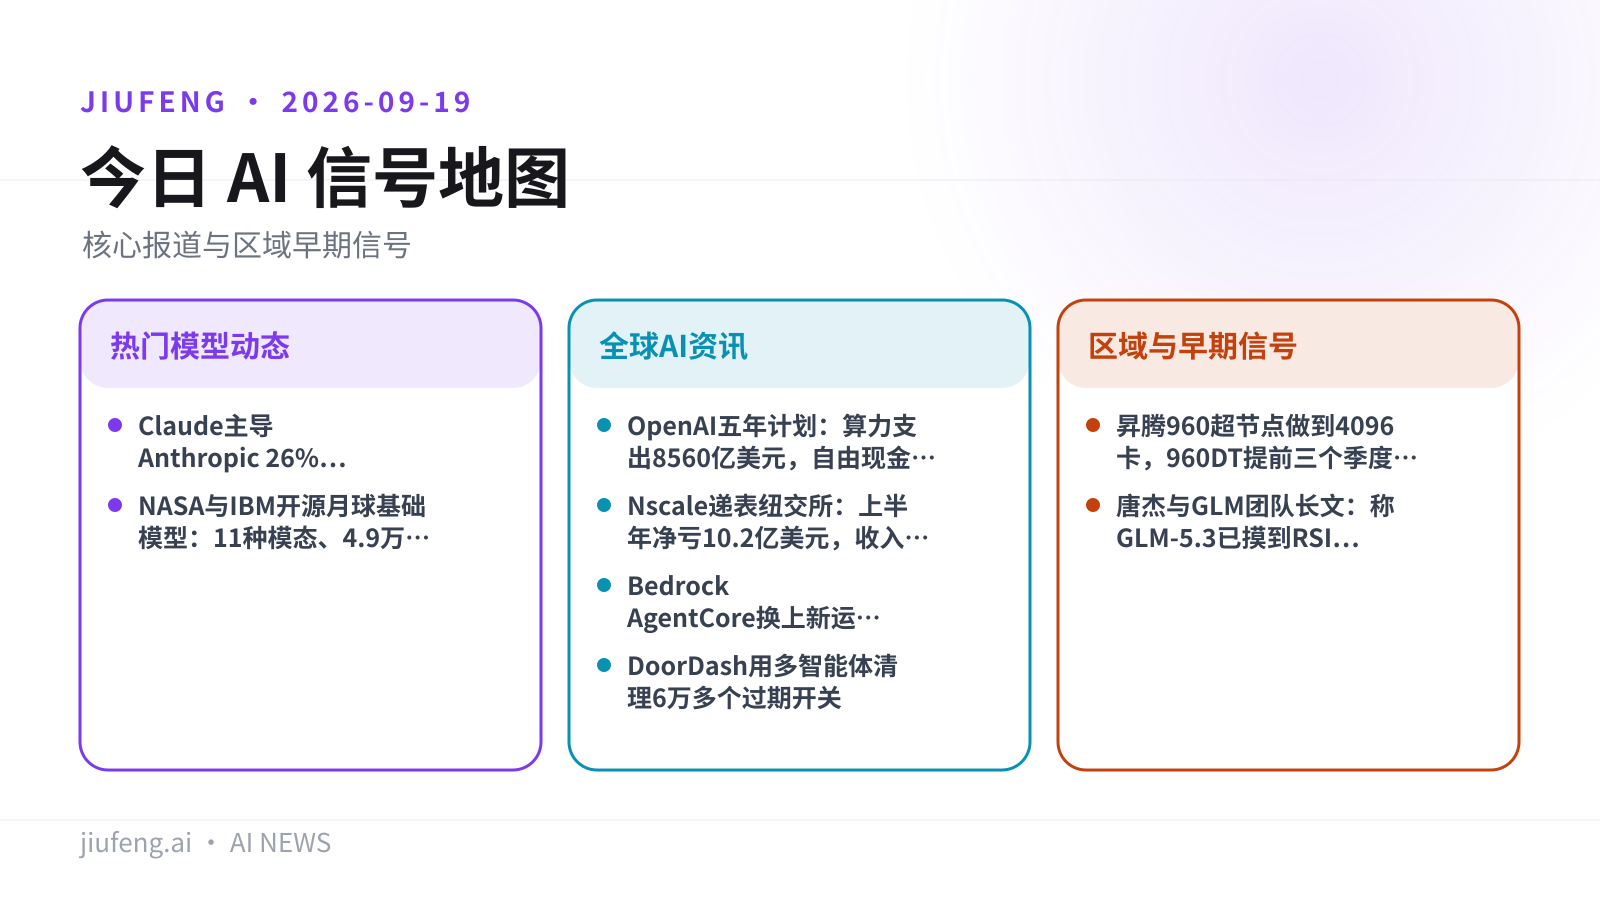
本期共 8 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · Claude 主导 Anthropic 26% 的 AI 研发,3 万智能体同时在跑
- 重点 · NASA 与 IBM 开源月球基础模型:11 种模态、4.9 万个撞击坑
全球 AI 资讯
- 重点 · OpenAI 五年计划:算力支出 8560 亿美元,自由现金流缺口 2780 亿
- Nscale 递表纽交所:上半年净亏 10.2 亿美元,收入涨超 12 倍
- Bedrock AgentCore 换上新运行时,会话释放即回收内存
- DoorDash 用多智能体清理 6 万多个过期开关
区域与早期信号
- 昇腾 960 超节点做到 4096 卡,960DT 提前三个季度就绪
- 唐杰与 GLM 团队长文:称 GLM-5.3 已摸到 RSI 门槛
九凤根据本期已引用来源整理。
热门模型动态
01/08
Claude 主导 Anthropic 26% 的 AI 研发,3 万智能体同时在跑
Anthropic 首次公布内部研发自动化指数:半年里「主导」级任务占比从不到 1% 升到 26%。
当地时间 9 月 17 日,Anthropic 放出一组内部数据,用自建的 R&D Automation Index 量化 Claude 参与自家模型研发的程度。该指数沿用 Epoch AI 的六级标准(AL0–AL5):AL3 是「协作」,AL4 是「主导」——工程师只给出高层目标,模型完成一项任务端到端的大部分执行,人类负责监督和最终决策;AL5 才是完全自主。截至 2026 年 8 月,Claude 在约 26% 的模型研发任务上达到 AL4,超过 90% 的研发工作至少达到 AL3;公司内部使用最广泛的 Agent 平台上,约有 3 万个 Agent 同时跑研究和工程任务。
| 研发任务占比(按人力时间加权) | 2026 年 2 月 | 2026 年 8 月 |
|---|---|---|
| Claude 达到「主导」(AL4) | 不到 1% | 26% |
| 至少达到「协作」(AL3) | 未披露 | 超过 90% |
统计方法是:2026 年 7 月每周随机抽取参与模型研发循环的部门 20% 的员工,由 Claude Research Agent 读取其 Slack 与内部文档,整理出约 1.5 万项细粒度研发任务,再归成 542 个节点、378 个叶节点的任务树,覆盖预训练、强化学习、评测平台故障诊断、RL 沙箱网络策略和推理服务事故复盘等,最后按各任务消耗的人力时间加权。
局限:给 Claude 打分的「裁判」同样是 Claude。与负责对应工作的内部员工交叉验证时,模型与人的评级完全一致率为 59%,而不同人类评估者之间的完全一致率只有 35%;允许相差一级时,一致率才到 97%。26% 也不等于「26% 的研发已经无人化」或「26% 的研究员被替代」——AL4 仍然要人类定目标、做监督和最终决策。
02/08
NASA 与 IBM 开源月球基础模型:11 种模态、4.9 万个撞击坑
用近 200 万个按地理分区的数据包从零训练,下游代码开源,预训练代码没放。
NASA 与 IBM 于 9 月 10 日发布 NASA-IBM Lunar Foundation Model,面向撞击坑测绘、火山地貌分析,以及月球两极是否存在水冰的研究。USRA 9 月 18 日披露了行星科学家 Rachel Slank 在其中的工作:她通过 USRA 的科学与技术研究所在 NASA 马歇尔太空飞行中心参与项目,把不同仪器、不同分辨率采集的观测对齐,同时保留每项测量各自的物理上下文,并完成了撞击坑标注。
- 训练数据:近 200 万个按地理分区切分的数据包,全部从零预训练
- 模态:11 种,从相机影像、地形到雷达、矿物学、重力与光照几何
- 分辨率跨度:每像素 1 米到 20 公里
- 人工标注:4.9 万个撞击坑
- 预训练算力:约 1100 H100 GPU 小时(模型卡数据)
局限:GitHub 上的发布包含下游任务代码,但没有放出预训练代码,外部要完整复现这套模型仍有缺口。
图片来源:huggingface;已转存至九凤 R2。
来源:RuntimeWire · Hugging Face 模型卡
全球 AI 资讯
03/08
OpenAI 五年计划:算力支出 8560 亿美元,自由现金流缺口 2780 亿
投资者材料显示收入目标追不上算力账单,差额要靠资本市场补。
《金融时报》9 月 18 日报道,援引 OpenAI 近期为投资者准备的一份演示材料:公司预计 2026 至 2030 年自由现金流为负 2780 亿美元,同期算力与基础设施支出约 8560 亿美元,而收入目标是 8400 亿美元。与此同时,Sam Altman 已就新一轮私募融资展开早期接触,投资者讨论的估值至少 1.2 万亿美元,OpenAI 希望拿到更高的数字——1.2 万亿比不到六个月前敲定的 8520 亿美元投后估值高出 41%。
| 2026–2030 五年计划 | 金额 |
|---|---|
| 收入目标 | 8400 亿美元 |
| 算力与基础设施支出 | 8560 亿美元 |
| 自由现金流 | −2780 亿美元 |
局限:这些数字来自 FT 看到的内部演示材料,不是 OpenAI 的公开披露,而且口径仍在变——修订后的计划已经把预期现金消耗调低了 270 亿美元。新一轮融资尚在洽谈,1.2 万亿估值没有成交;眼下的现金跑道来自公司 3 月 31 日公告的那轮融资。
来源:RuntimeWire · OpenAI 3 月融资公告
04/08
Nscale 递表纽交所:上半年净亏 10.2 亿美元,收入涨超 12 倍
签下 Anthropic 446 亿美元、460 兆瓦合同之后,这家数据中心公司启动 IPO。
Nscale Global Holdings 于 9 月 18 日向纽约证券交易所提交上市申请,文件没有披露计划募资规模;上月有消息人士对彭博社称其寻求最多 30 亿美元,公司在 3 月的估值为 146 亿美元。财务上 Nscale 尚未盈利:今年上半年净亏损 10.2 亿美元,为去年同期的近三倍;同期收入增长超过 1250%,达到 1.406 亿美元。上月它与 Anthropic 签下 446 亿美元的基础设施合同,为后者在西弗吉尼亚的旗舰园区 Monarch 提供约 460 兆瓦算力,该园区完全由自建微电网供电。
局限:募资金额未在申报文件中给出,30 亿美元的说法来自彭博援引的消息人士;公司自述有「清晰的扩展路径到 8GW+」,那是规划而不是在建产能。本条目前为单一来源报道。
来源:SiliconANGLE
05/08
Bedrock AgentCore 换上新运行时,会话释放即回收内存
AWS 给长时间运行的生产智能体重做托管计算层,按实际用量计费。
AWS 9 月 18 日宣布新版 Amazon Bedrock AgentCore runtime,这是 AgentCore 的托管计算层,面向长时间运行、无人值守的生产智能体。官方列出的变化包括:内存在会话释放时即回收,而不是一直占着;资源分配粒度更细;启动更快且更稳定;计费按实际用量计算。AWS 称自发布以来已有数千个团队用它跑生产智能体,并在 AgentCore 示例仓库里给出了按 HTTP 协议托管智能体的可运行样例。
局限:这条只有 AWS 自家博客一个来源,没有给出冷启动时延、吞吐或成本的任何具体数字,也没有第三方复现,「启动更快、更稳定」目前只是厂商说法。
来源:AWS 运行时公告 · AgentCore 示例仓库
06/08
DoorDash 用多智能体清理 6 万多个过期开关
623 个仓库里的 feature flag 清理交给 LLM 智能体,实验数据通过 MCP 接入。
InfoQ 报道,DoorDash 搭了一套多智能体 LLM 系统,自动清理陈旧的 feature flag,覆盖 6 万多个开关和 623 个代码仓库。这套工作流通过 MCP 把线上实验数据接进来判断哪些开关已经失效,再结合工程师的判断决定是否删除。
局限:本条目前只有 InfoQ 的一篇报道,没有公开清理的准确率、回滚率和人工复核比例,也没有披露这套系统最终删掉了多少开关。
来源:InfoQ
区域与早期信号
07/08
昇腾 960 超节点做到 4096 卡,960DT 提前三个季度就绪
华为把竞争点从单颗芯片挪到整机系统:4096 卡超节点、NPO 光互联、一年一代路线图。
量子位 9 月 19 日报道,华为汪涛给出昇腾的新进度:昇腾 960DT 比原计划提前三个季度准备就绪,单芯片算力实现倍增,960PR 版本也将继续提前。华为把超节点、NPO 光互联和 CANN 生态一起摆上台面,理由是「只做好一颗芯片远远不够」——一个大规模超节点同时牵涉芯片、通信、IP 网络、光互联、供电、散热、软件与故障管理。
- 昇腾 960DT 算力:2 PFLOPS FP8、4 PFLOPS FP4
- 显存:HBM 容量最高 288GB,带宽 9.6TB/s
- 超节点规模:4096 张 NPU 卡,最高 8 EFLOPS FP8、超过 1PB HBM
- 路线图:2028 年昇腾 970、2029 年昇腾 980,保持一年一代
| 超节点 | NPU 卡数 |
|---|---|
| 昇腾 910C | 384 |
| 昇腾 950 | 1024 |
| 昇腾 960 | 4096 |
华为还称,在同样十万卡规模下,由 4096 卡超节点组成的集群相对传统八卡服务器组成的集群,MFU(大模型真正吃到的理论算力比例)可提升 2.75 倍;NPO 把光电转换的光引擎推到芯片附近,公司自称该方案是首个规模商用、集成 36 路 200G、且唯一内置光源的。
局限:上述数字全部来自华为在会上的自述,MFU 2.75 倍出自华为自己的仿真而非第三方实测;970、980 仍是路线图。本条目前只有中文来源报道。
来源:量子位
08/08
唐杰与 GLM 团队长文:称 GLM-5.3 已摸到 RSI 门槛
智谱把递归自我改进的进展写成长文,并举了一个国产集群上的推理优化案例。
InfoQ 中文 9 月 18 日刊出唐杰与 GLM 团队的长文,披露智谱在递归自我改进(RSI)方向的最新进展,称 GLM-5.3 已经摸到门槛,文中用了「正一步步走向取代我们」的表述。文章举的案例发生在 10 万卡规模的国产芯片集群上:不到两周把端到端吞吐提升到初始基线的 3 倍,手段包括 EPD 分离架构与 W8A8 量化。
局限:这些进展和数字都出自智谱团队自述,「摸到门槛」是团队自己的判断,没有第三方复现或独立评测佐证。本条为中文单一来源。
来源:InfoQ 中文
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片

