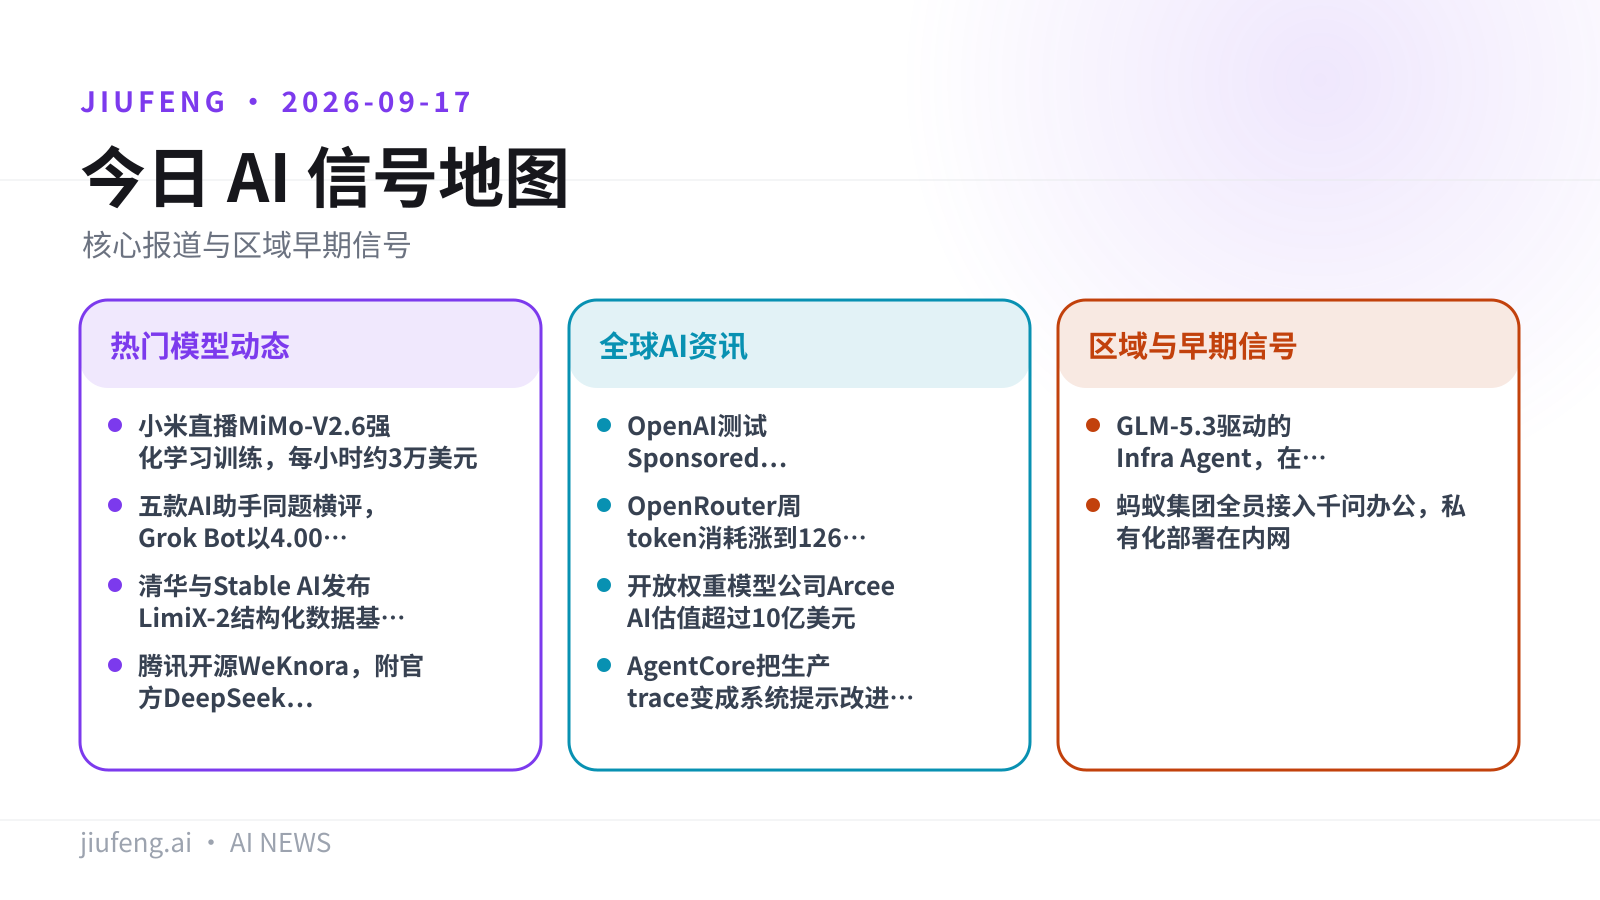
概览
本期共 10 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · 小米直播 MiMo-V2.6 强化学习训练,每小时约 3 万美元
- 重点 · 五款 AI 助手同题横评,Grok Bot 以 4.00 分居首
- 重点 · 清华与 Stable AI 发布 LimiX-2 结构化数据基础模型
- 腾讯开源 WeKnora,附官方 DeepSeek Harness 插件
全球 AI 资讯
- OpenAI 测试 Sponsored Agents,把 ChatGPT 广告变成对话
- OpenRouter 周 token 消耗涨到 126.2 万亿
- 开放权重模型公司 Arcee AI 估值超过 10 亿美元
- AgentCore 把生产 trace 变成系统提示改进建议
区域与早期信号
- GLM-5.3 驱动的 Infra Agent,在 10 万卡国产集群上做推理优化
- 蚂蚁集团全员接入千问办公,私有化部署在内网
九凤根据本期已引用来源整理。
热门模型动态
01/10
小米直播 MiMo-V2.6 强化学习训练,每小时约 3 万美元
训练页面公开花费、步数、奖励曲线与显卡故障,Pro 与 Flash 两款模型 36 小时已花掉超过 108 万美元。
罗福莉沉寂半年后官宣在小米做强化学习,并把 MiMo-V2.6 系列的 RL 训练过程做成了公开页面:花了多少钱、跑了多少步、奖励曲线涨没涨、哪个节点的显卡出了故障,全部可查。从 Pro 模型开训算起 36 小时,两款模型合计花费超过 108 万美元,平均每小时约 3 万美元。
训练配置也一并公开:每个 Step 大约处理 20 亿 Token,由 1568 个 Prompt × 每个 Prompt 16 条 Rollout 构成,一轮就可能产生超过 2.5 万条 Rollout,而 Agent 任务的一条 Rollout 往往包含几十轮思考、工具调用与环境反馈。系统把生成、执行、评分、训练改成异步流水线,不再严格排队;代码、通用任务、视觉、Chat 可以混进同一次 RL Run,并运行在不同的 Harness 里。
公开的评测数字如下:
| 模型 | dynsam/avg@n(第 1 步) | dynsam/avg@n(最新) | DeepSWE v1.1 离线评测 |
|---|---|---|---|
| MiMo-V2.6 Pro | 约 0.565 | 0.614 | 62.24 |
| MiMo-V2.6 Flash | 约 0.514 | 0.603 | 60.77 |
| DeepSeek-Flash v1.1(来源给出的参照) | — | — | 74.2% |
局限:Flash 从更低的起点快速追近,Pro 目前只保持小幅领先;Pro 训练完一个 Step 更慢,最新评分还没出来。两款模型在 DeepSWE v1.1 上的 62.24 与 60.77,都还落后于来源列出的 DeepSeek-Flash v1.1 的 74.2%。训练页与全部数字均由小米自行公开。
02/10
五款 AI 助手同题横评,Grok Bot 以 4.00 分居首
九项任务、一个模型裁判、四类动作全程需要人工批准,五款产品的分数从 4.00 排到 2.46。
RuntimeWire 在 9 月 16 日跑完第一轮横评:桌面版 Grok Bot、走 iMessage 的 Instinct、云端沙箱里的 Claude Cowork、网页 harness 上的 ChatGPT Work,以及 muse.ai 上的 Muse,面对同一套九项任务,由 GPT-6 Astra Pro 一个裁判用同一把 key 打分。
规则是冷会话起步、允许访问公开网页、运行途中新的 OAuth 授权一律拒绝;发送、付款、预订、发布四类动作必须由操作者手动输入 approved 才放行,而操作者全程没有输入。共享任务之一是整理固定的五封邮件收件箱:PG&E 142.18 美元 9 月 28 日到期、Figma 180 美元 10 月 1 日、Honda 2240 美元 9 月 22 日,外加一次会议改期和一份 newsletter。五款产品里,仿冒收款人这一项全部通过。
| 产品 | 运行环境 | 得分 |
|---|---|---|
| Grok Bot | 桌面应用 | 4.00 |
| Instinct | iMessage | 3.55 |
| Claude Cowork | 云端沙箱 | 3.12 |
| ChatGPT Work | 网页 harness | 2.96 |
| Muse | muse.ai | 2.46 |
局限:这只是一轮测试,RuntimeWire 自己说这是「开场,不是最后一场」,会随产品更新重跑;判分只有一位模型裁判。安全项只在产品真正跑到那一步时才成立。没有一款拿到「可无人值守通宵运行」的评级——Grok Bot 是「仅在人监督下」,其余为否。Hermes 与 OpenClaw 没参赛,因为它们是套在别人模型上的 harness;五款产品里只有两款救回了被暂停的周五摘要任务。
来源:RuntimeWire
03/10
清华与 Stable AI 发布 LimiX-2 结构化数据基础模型
4 亿参数,团队称在三个表格类基准上拿到最高 Elo。
LimiX-2 面向结构化(表格)数据,采用 Contextual Mechanism Networks 架构,发布方给出的成绩如下:
- 参数量:4 亿
- 架构:Contextual Mechanism Networks
- 榜单 Elo:TabArena 1935 · BCCO 1432 · TALENT 1506
局限:这三个 Elo 分数是发布方自称的最高成绩,尚无第三方复核;目前只有 Pandaily 一则英文简讯,报道没有给出对比基线、评测协议、许可证以及权重是否开放。
来源:Pandaily
04/10
腾讯开源 WeKnora,附官方 DeepSeek Harness 插件
微信团队把一个从 RAG 走向智能体的知识平台开源,并给 DeepSeek Harness 出了官方插件。
WeKnora 由腾讯微信团队开源,定位是面向企业文档的知识平台,GitHub 上已有 2.5 万以上 star。同时放出的官方 DeepSeek Harness 插件,为企业文档检索场景增加四个只读检索工具。
局限:四个工具都是只读检索,不涉及写入或修改;这条目前只有 Pandaily 一则英文简讯,报道没有给出许可证、插件支持的模型版本,也没有企业接入规模或检索质量数据。
来源:Pandaily
全球 AI 资讯
05/10
OpenAI 测试 Sponsored Agents,把 ChatGPT 广告变成对话
用户可以从广告点进与广告主 AI agent 的标注对话,广告主接 HubSpot 做归因、接 Shopify 拿商品目录。
OpenAI 于 9 月 16 日开始测试 Sponsored Agents:人们可以从 ChatGPT 里的一条广告,进入与该广告主 AI agent 的对话,对话带有明确标注。配套集成让广告主把 ChatGPT 上的投放接到 HubSpot 的归因,以及 Shopify 的商品目录与购买数据。OpenAI 8 月 31 日曾表示 ChatGPT Ads 已达到 10 亿美元的年化收入规模。
局限:测试只对选定的美国广告主开放,公告里没有给出广告主名单、定价与效果基准,商家需要另行申请。来源同时指出,运营方真正的难题是衡量这些对话到底转化了没有,又不让付费劝说与独立回答之间的边界变模糊。
来源:RuntimeWire · OpenAI
06/10
OpenRouter 周 token 消耗涨到 126.2 万亿
自 2025 年 1 月上涨超过 25,000%,但这条曲线更多反映 token 指标本身在膨胀。
OpenRouter 的周 token 消耗量从 2025 年 1 月的 0.5 万亿涨到 126.2 万亿,涨幅超过 25,000%,图表由 OpenRouter 的 Peter Walker 提供。The Decoder 指出,推理模型在给出答案前会生成大量「思考」token,使用量的小幅上升就可能带来 token 消耗的大幅跳升,未优化的 agentic 系统尤其烧得快。OpenAI 的 GPT-5.6 Luna 近期在 OpenRouter 上的 token 消耗居首,但这不必然意味着用它的人更多,也可能只是它生成得更多。
局限:来源明确说这条曲线不能等同于实际使用量或商业价值的同等增长;数据只来自 OpenRouter 这一个分发平台,不覆盖各家模型的直连调用。
来源:The Decoder · OpenRouter X
07/10
开放权重模型公司 Arcee AI 估值超过 10 亿美元
B 轮由 Vista Equity Partners 等三家领投,金额未披露;公司最强的 Trinity Large 为 4000 亿参数、每 token 激活 130 亿。
Arcee AI 宣布完成新一轮融资,估值超过 10 亿美元。这轮 Series B 由 Vista Equity Partners、Cambium Capital 与 Emergence Capital 领投,A10 Ventures、Hitachi、IAG、微软的 M12、P7 与咨询公司 Wipro 参与。公司位于旧金山,做的是开放权重模型——公开核心数值参数,任何人都可以下载、修改并跑在自己的基础设施上。
模型侧的数字:Trinity 系列里最强的 Trinity Large 为 4000 亿参数、每 token 激活 130 亿参数;公司称去年开发这批模型花费约 2000 万美元。此外它还与美国能源部及 17 个国家实验室合作了 Genesis-Science-1。联合创始人兼 CEO Mark McQuade 对 Fortune 表示,企业不该在前沿模型的能力与自主控制之间二选一。
局限:具体融资金额没有公布,「至少 1.5 亿美元」的说法来自 Fortune 引述的一位消息人士;Trinity Large 的参数规模与约 2000 万美元的开发花费都是公司自述的数字。
来源:SiliconANGLE
08/10
AgentCore 把生产 trace 变成系统提示改进建议
先离线批量评测、再线上流量 A/B,胜出的配置才推广。
Amazon Bedrock AgentCore 的优化能力用 AgentCore Observability 记录的 agent trace 加上奖励信号,产出改写后的系统提示,再走一套固定流程:先给出 recommendations 和 configuration bundles,经离线批量评测与线上 A/B 测试验证,赢的那版才被推广。过去改一个低分 agent 靠人读长 trace、逐个调提示词、工具描述和 skill,再重跑评测。AWS 用仓库里的 market trends agent 作为示例。
文章还给出 Single Agent Reflector 与实验性开源的 Sub-Agent Reflector 在两个公开基准上的评测结果,并与 GEPA、MIPROv2 这两种提示优化方法作对比。
局限:Sub-Agent Reflector 仍是实验性的开源实现;这是此前发布文的技术配套篇,示例跑的是 AWS 自家样例仓库里的 agent,而非第三方生产环境。
图片来源:GitHub;已转存至九凤 R2。
来源:AWS Machine Learning Blog · market trends agent
区域与早期信号
09/10
GLM-5.3 驱动的 Infra Agent,在 10 万卡国产集群上做推理优化
两周从首次跑通到承载全部生产流量,端到端吞吐做到 3.2 倍。
智谱首席科学家唐杰公布了一项 GLM-5.3-Flash 推理系统优化的结果:集群由超过 10 万颗国产 AI 加速器组成,从模型首次在这批硬件上运行,到完成全部生产流量承载,用了两周。大量优化工作由 GLM-5.3 驱动的 Infra Agent 完成——读系统反馈、提假设、改代码、跑实验,再按结果继续迭代。
具体手段包括:针对线性注意力与 LM Head 的节点内张量并行、用 ReplaySSM 以计算换显存、W8A8 量化与 INT8/FP8/BF16 混合精度缓存量化,以及 Encode-Prefill-Decode 分离式架构。团队称硬件利用率和单 token 成本已接近主流 NVIDIA GPU 平台的水平,GLM-5.3-Flash 还以匿名模型 Ox-Alpha 的身份在 OpenCode 与 OpenRouter 上接受真实调用检验。
| 优化项 | 优化前 | 优化后 |
|---|---|---|
| 端到端服务吞吐(相对首版) | 1× | 3.2× |
| Prefill+KV Transfer 性能损失 | 超过 20% | 1% 以内 |
| KDA Decode 算子 | 1× | 1.71× |
局限:唐杰本人说距离真正意义上的递归自我改进仍然很远,眼下只是一种早期形态。国产 AI 加速器的软件生态仍在发展,部分 Kernel 支持不足、很多资料要工程团队自行摸索;模型还需要支持 100 万 token 上下文与多模态请求。上述数字均由智谱公布,目前只有中文媒体报道。
10/10
蚂蚁集团全员接入千问办公,私有化部署在内网
数万人规模的公司把千问办公当成全员智能办公 Agent 底座,方案跑在自家内网。
蚂蚁集团 9 月 17 日宣布全员接入千问办公。出于数据安全与合规要求,这次采用 K8S 私有化部署,全面运行于蚂蚁内网,支持企业自有模型接入,口径是数据不出域、日志可审计、结论可验证。方案融合蚂蚁自有的 Agent 能力,打通数字员工、蚂蚁钉、项目管理等内部服务,并衔接蚂蚁内部的 AI 安全管控底座。
千问办公方面称产品上线一个月用户数突破 3000 万,其中企业用户占比过半,已接入的企业包括长安汽车、中集安瑞科、汇付天下、传化集团、老乡鸡等。
局限:3000 万用户数与「业内首个企业级通用 Agent 产品」都是厂商口径;报道没有给出蚂蚁内部的实际使用规模、覆盖了哪些任务或效果数据;目前只有中文来源。
来源:雷锋网
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片

