概览
本期共 10 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · Claude 写下八成合并代码,CI 任务半年涨 25 倍
- 重点 · ChatGPT 对话被外包审阅,记忆摘要也在其中
- 重点 · Codex 演示跨 Mac 迁移会话与工作文件
全球 AI 资讯
- Perplexity 本地智能体登陆 Windows,跑在 RTX 上
- Reward AI 发布 OM-1:只用人类手套数据训练
- 微软发布 37 页人本 AI 行为准则
- AgentCore 上线托管同意门户,接手 OAuth 授权绑定
- Abnormal AI 把代码解释器当成智能体的临时草稿纸
区域与早期信号
- Claude Code 灰度指向 Opus 5.2,官方无公告
- 蚂蚁发布内生式安全护栏 SingProbe,解码开销低于 0.5%
热门模型动态
01/10
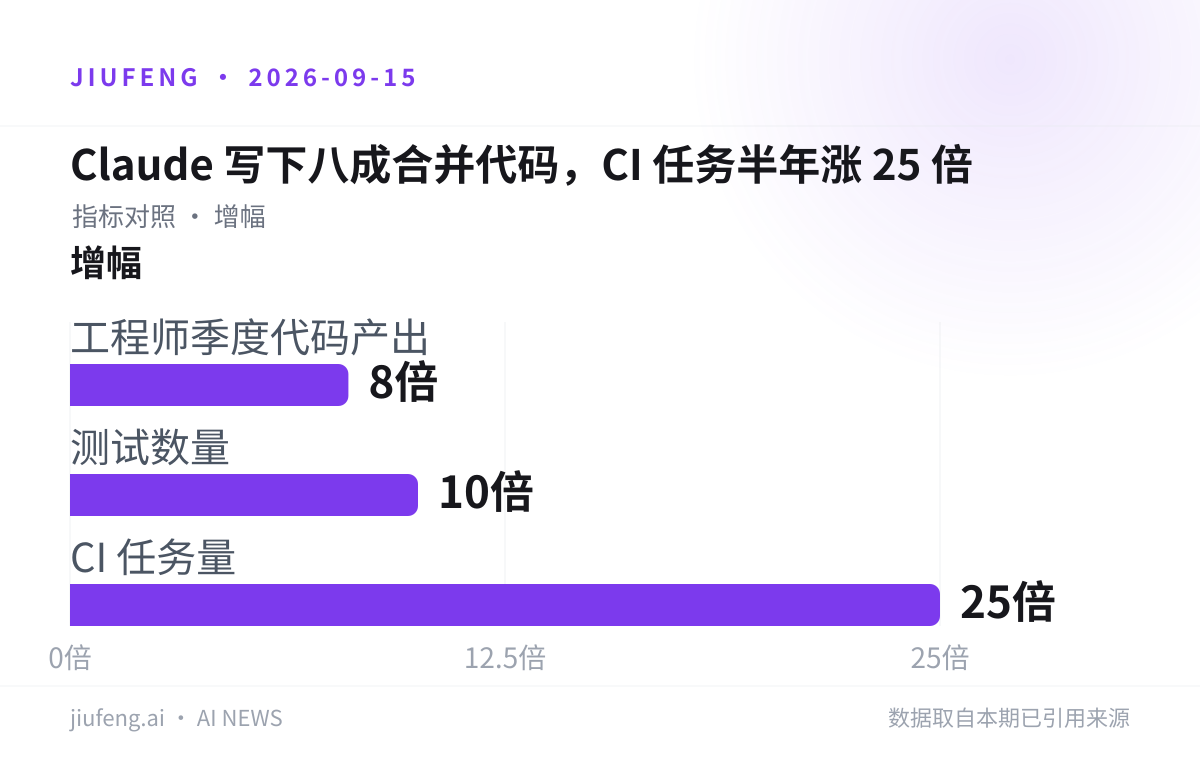
Claude 写下八成合并代码,CI 任务半年涨 25 倍
Anthropic 自述:代码产出提速之后,瓶颈转移到了测试与持续集成。
Anthropic 表示,Claude 现在撰写了合并进其代码库的约 80% 代码,其工程师的季度代码产出是 2021 至 2025 年期间的 8 倍。前 Chrome 开发者体验负责人 Addy Osmani(@addyosmani)在 9 月 14 日放出这组数字,并说明 80% 指的是能明确归因给 Claude 的生产合并行数,其余 20% 混合了人写代码与其他产物。数据出自 9 月 14 日工程师 Sachin Malhotra 的工程博客。
| 指标 | 增幅 | 时间窗 |
|---|---|---|
| 工程师季度代码产出 | 8 倍 | 对比 2021—2025 |
| 测试数量 | 10 倍 | 近六个月 |
| CI 任务量 | 25 倍 | 近六个月 |
局限:这些数字均由 Anthropic 自述,未经第三方核验;8 倍衡量的是代码量,并不等于功能、收入或软件质量同比例增长。产出激增的代价直接压到下游——测试与 CI 的膨胀迫使 Anthropic 花三周重建了测试选择系统。
九凤根据本期已引用来源整理。
来源:RuntimeWire · Addy Osmani on X
02/10
ChatGPT 对话被外包审阅,记忆摘要也在其中
数百名承包商按代号 Project Lily 评估真实对话,隐私过滤器自己承认会漏。
据 404 Media 9 月 14 日发布的调查,OpenAI 动用数百名外部承包商阅读并评估真实的 ChatGPT 对话,其中包含带敏感个人信息的聊天,内部文件里用代号 Project Lily 指代这项工作。审阅员拿到的是匿名化提示词,有时是整段对话;用户名被移除,但文本本身可能暴露个人细节。部分任务还附带「用户记忆摘要」,内含此前交互、位置信息等 ChatGPT 保留下来的上下文。OpenAI 称对话在交给承包商之前先过 Privacy Filter,用于检测并遮蔽姓名、联系方式、住址、账号与密码等标识符。
局限:OpenAI 自己的 Privacy Filter 技术说明写明,该模型可能漏掉不常见的标识符或有歧义的表述。这条管线默认开启,退出开关埋在数据控制设置里;据报道,即使用户事后退出,此前的对话仍可能被保留。
来源:RuntimeWire · OpenAI Privacy Filter 技术说明 · OpenAI 消费者数据 FAQ
03/10
Codex 演示跨 Mac 迁移会话与工作文件
未跟踪文件带着相同哈希落到另一台机器,但跑的是开了特性开关的改装版。
开发者 Developing Adventures(@DevAdventur3s)9 月 13 日演示 Codex 把一段编程会话连同项目状态从一台 Mac 搬到另一台,其中包括一个未跟踪文件以相同哈希到达。13 条推文的线程展示了两条路径:从本地机器发往云端,以及转移到另一台 Mac。在 Mac 到 Mac 的测试中,对话在目的机上继续,未跟踪文件无需 Git 提交或推送即完成迁移——这意味着开发者可以放下笔记本、在 Mac mini 或另一台工作站上接着做,而不必为了换机器把未完成的改动打包提交。
局限:测试用的是开启特性开关的改装 Codex 构建,属于对既有 Handoff 工作流的近距离观察,而非 OpenAI 的新发布;OpenAI 文档显示主机到主机的 Handoff 自 6 月起已经可用。报道也指出,开发者仍然需要一份关于文件、密钥与传输失败的明确契约。
来源:RuntimeWire · OpenAI 官方页面
全球 AI 资讯
04/10
Perplexity 本地智能体登陆 Windows,跑在 RTX 上
本地完成的活不消耗 Perplexity Computer 额度。
NVIDIA 9 月 14 日宣布,Perplexity 在 Windows 版应用中加入 Portable Computer——Perplexity Computer 的本地版本,在兼容的 GeForce RTX PC 与 RTX PRO 工作站上用本地模型规划并执行多步任务:分析数据、跨文件汇总信息、处理重复性工作。应用预置的本地模型包括 Qwen 3.8 27B,该模型经过后训练适配 Perplexity Computer,并针对 RTX GPU 做了优化。敏感信息留在设备上,本地完成的工作不消耗 Perplexity Computer 额度;需要更强的研究与推理时,用户可以把任务向上编排到云端模型。此前该能力已支持 NVIDIA DGX Spark 系统与运行 Linux 的 RTX PC。
局限:能力绑定在兼容的 NVIDIA RTX 硬件上,需要显存 24GB 及以上的 RTX 或 RTX PRO GPU;更复杂的研究与推理仍要向上编排到云端模型。
05/10
Reward AI 发布 OM-1:只用人类手套数据训练
不用遥操作、不用机器人自采数据,策略直接跑在工业机械臂与人形机器人上。
机器人创业公司 Reward AI(团队此前参与 DexCap、HumanPlus、ALOHA)发布通用操作策略 OM-1(Omnibody Model 1)。训练数据全部来自佩戴 7 自由度传感手套的人类演示,既不含遥操作数据,也不含机器人本体采集的数据;训练完成后以人类速度运行在工业机械臂与人形机器人上。公司把它概括为「一个模型、一套数据接口、任意本体」:多数机器人基础策略靠遥操作或自采数据训练,数据集因此被绑死在单一本体上,而 Reward AI 把采集、学习与控制设计成一条流水线,今天录下的演示可以用来训练尚不存在的机器人本体。
局限:OM-1 是 Reward AI 的自研内部策略,权重、代码、数据集与 API 一律未放出,开发者目前无法在自己的硬件上运行。
来源:MarkTechPost
06/10
微软发布 37 页人本 AI 行为准则
白纸黑字写下「人比 AI 更重要」,并拒绝模型人格权与模型福利。
微软 9 月 14 日发布一份 37 页的「humanist AI code of conduct」。文件明确写出 people matter more than AI,称 AI 模型没有意识、不应被设计成模仿意识,并拒绝「追求法人资格,或认为模型可能值得福利、应当享有权利」的主张。发布时点正值业界对模型进展的安全担忧升温:Anthropic CEO Dario Amodei 在上个周末呼吁协同放慢 AI 开发,此前有研究者警告,模型能力的推进速度可能超过人类安全部署、验证并控制智能体行为的能力。
局限:这是微软自行制定的公司准则,不是监管要求;报道未提及配套的外部审计安排或违反后的后果。
来源:The Verge
07/10
AgentCore 上线托管同意门户,接手 OAuth 授权绑定
开发者不用再自建授权回调与会话绑定基础设施。
Amazon Bedrock AgentCore Identity 推出 Consent portal——面向 AgentCore Gateway 的托管网页体验与会话绑定端点。智能体要代表用户访问 GitHub、Slack 这类服务,必须先让用户在服务方认证并显式批准授权,再把拿到的 OAuth 授权与批准它的用户安全关联起来,即所谓 session binding。此前走三方 OAuth(3LO,即 OAuth 2.0 授权码流)的客户得自建并托管这套设施:呈现授权 URL、托管公开 HTTPS 回调、认证返回的用户、管理浏览器会话,并调用 CompleteResourceTokenAuth 收尾。现在为网关创建一个门户、把 URL 发给用户即可,用户用本组织的身份提供方(IdP)认证、查看可用服务并授权。AWS 在示例仓库里给了对接 Microsoft Entra ID 与 Okta 的端到端例子。
局限:能力只服务接在 AgentCore Gateway 上的智能体;前置条件仍要客户自己准备——已注册的 GitHub OAuth App 与 Slack app,以及对企业 IdP 的管理权限。
图片来源:GitHub;已转存至九凤 R2。
来源:AWS Machine Learning Blog · AgentCore 示例仓库 · GitHub OAuth App 文档
08/10
Abnormal AI 把代码解释器当成智能体的临时草稿纸
每天数十亿封邮件的实时威胁检测背后,智能体靠一次性计算环境做聚合与校验。
Abnormal AI 把 Amazon Bedrock AgentCore Code Interpreter 用作实时邮件威胁检测智能体的计算草稿纸——不只是写代码,还用于数据聚合、分析与校验这类光靠语义推理不够的环节。该公司称保护了超过 25% 的《财富》500 强企业,这套系统今天在生产中每天处理数十亿封消息,并以同等规模执行智能体驱动的代码,在邮件抵达收件箱前拦截威胁。它还披露,以全部代码变更为分母,80% 由智能体以某种方式参与构建,40% 由后台智能体端到端完成(全 AI 构建,而非 AI 辅助)。
局限:这是 AWS 官方博客上的客户案例,规模与比例数据由 Abnormal AI 自述,未经第三方核验。
区域与早期信号
09/10
Claude Code 灰度指向 Opus 5.2,官方无公告
开发者抓包发现模型 slug 已换,前端名字没变。
据 IT之家 9 月 14 日报道(中文来源),多名开发者发现在 Claude Code 中调用 Opus 5 时,行为与网页版 Opus 5 明显不同;通过抓包与查看请求状态(/status),前端名称未变,但背后的模型 slug 已经指向 Opus 5.2,意味着 Anthropic 可能跳过 5.1 直接端出 5.2。开发者用一条关闭联网搜索的冷门知识探针提示词做对照,报告两侧答案完全不一致,据此判断不是同一套权重。实测反馈集中在生成速度更快、长任务更能坚持、不再频繁要求用户「按继续」。
局限:全部证据来自开发者社区自测与中文媒体转述,Anthropic 没有发布公告或模型卡,灰度范围与时间表均无官方口径。同一报道中关于内部代号 Model 2 接管公司大部分代码编写、将替代 85% 研究团队的说法,出自一份未经证实的内部风险报告,本站无法核实。
来源:IT之家
10/10
蚂蚁发布内生式安全护栏 SingProbe,解码开销低于 0.5%
复用推理过程中已有的内部信息边生成边打风险分,不再另起外置护栏模型。
据雷锋网 9 月 14 日报道(中文来源),蚂蚁 AI 安全实验室在国家网络安全宣传周期间发布大模型内生式安全护栏 SingProbe。现行做法通常是用独立的外置护栏模型审核输入或输出,要额外处理待审内容、增加计算与部署成本;等完整回答生成完再检查,风险内容可能已经呈现给用户,提高检查频率又会加重负担。SingProbe 让安全判断与生成同步进行,通过轻量检测模块持续输出风险分数,供系统告警、终止生成或重试。
- 开销:团队在 Ling-3.0-flash 生产环境实测,解码阶段引入的额外开销低于 0.5%
- 效果:团队评测称 flash 版在回答安全分类与流式安全检测任务上超过所选公开基线,幻觉检测与参考基线基本持平
- 医疗场景:SingProbe-Med 在 AntAngelMed-100B 上做完整干预,纠正了基线模型中 25.03% 原本出错的回答
- 覆盖:已适配 Ling-3.0 系列、GLM-5.2/5.3、Qwen、DeepSeek V4 等 29 个主流开源大模型,接入 SGLang 与 vLLM,代码、模型与评测基准同步开源
同期还发布了面向流式生成的评测基准 SingStreamBench,关注模型从正常回答转向风险内容的具体时刻,既检验护栏能否发现风险,也考察是否过早触发、发现是否及时。
局限:评测由蚂蚁团队自行开展,对照的是「所选公开基线」,尚无第三方复现;报道未给出开源仓库地址与许可证,也未列出已适配的 29 个模型完整名单。
来源:雷锋网
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片

