概览
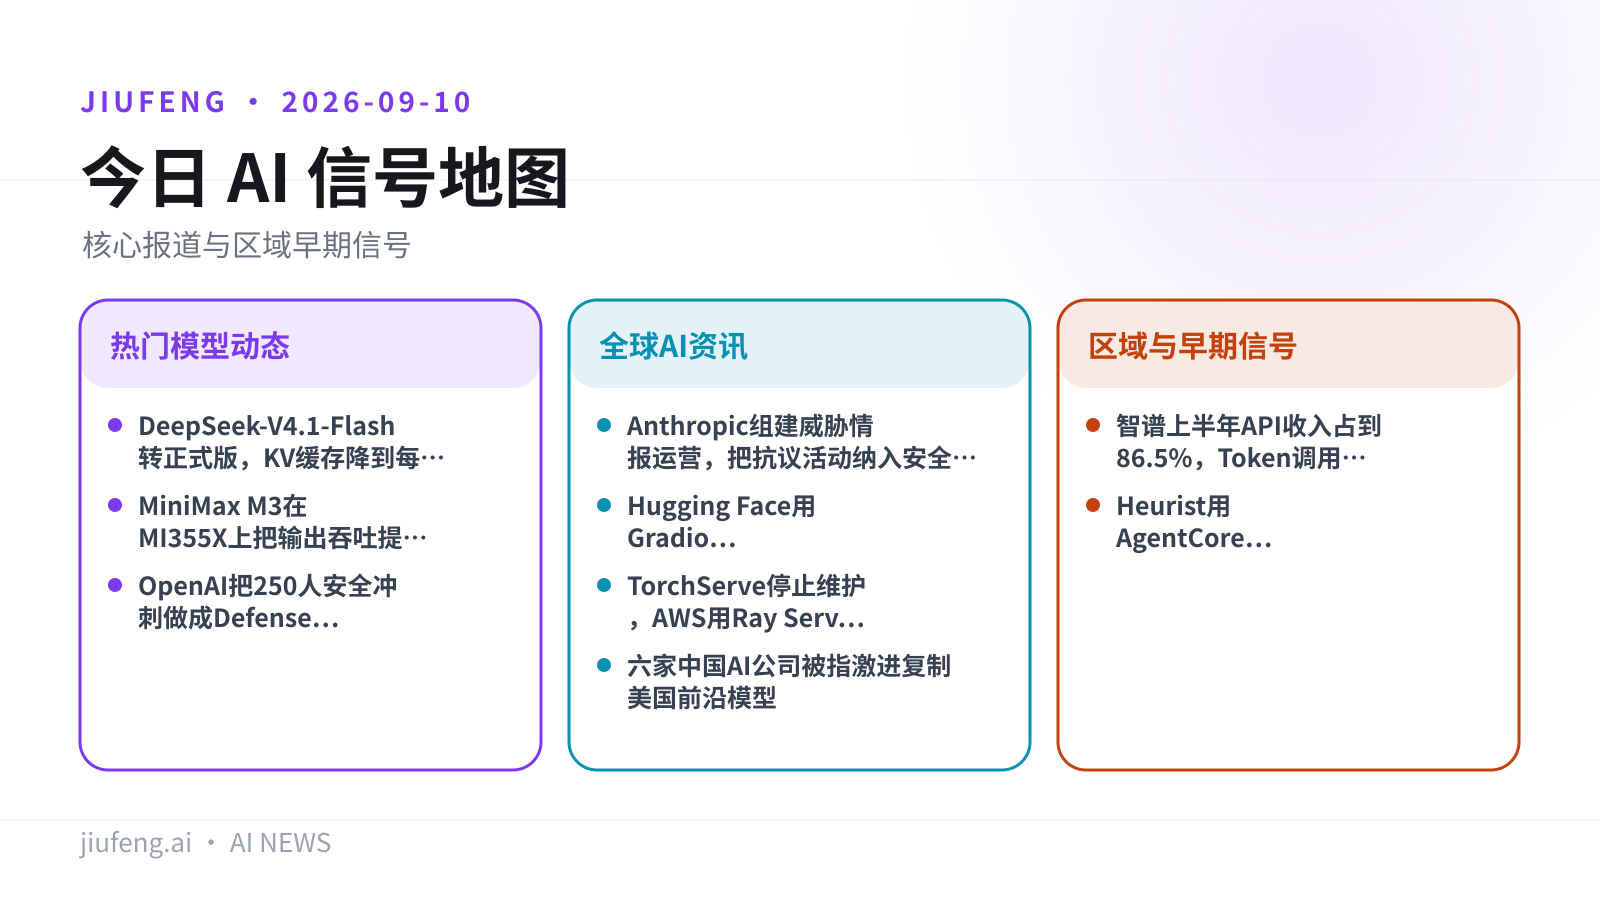
本期共 9 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · DeepSeek-V4.1-Flash 转正式版,KV 缓存降到每 token 890 字节
- 重点 · MiniMax M3 在 MI355X 上把输出吞吐提到 day-0 的 3.14 倍
- 重点 · OpenAI 把 250 人安全冲刺做成 Defense Factory,首日关掉 53 个高危问题
全球 AI 资讯
- Anthropic 组建威胁情报运营,把抗议活动纳入安全风险
- Hugging Face 用 Gradio Workflow 重建 AUTOMATIC1111:73 个节点、11 条流水线
- TorchServe 停止维护,AWS 用 Ray Serve 深度学习容器接手
- 六家中国 AI 公司被指激进复制美国前沿模型
区域与早期信号
- 智谱上半年 API 收入占到 86.5%,Token 调用量较年初增超 40 倍
- Heurist 用 AgentCore payments 按查询购买付费金融数据
九凤根据本期已引用来源整理。
热门模型动态
01/09
DeepSeek-V4.1-Flash 转正式版,KV 缓存降到每 token 890 字节
DeepSeek 把 Flash 线推到正式可用,权重以 MIT 许可开放,全局 KV 缓存压到每 token 890 字节。
DeepSeek-V4.1-Flash 是一款多模态 MoE 模型,骨干 552B 参数、另有 196B Engram 参数,上下文窗口 100 万 token;prefill 阶段每 token 激活 8B 参数,decode 阶段激活 16B。MarkTechPost 拆解里最关键的一个数字是全局 KV 缓存足迹:
| 模型 | 全局 KV 缓存(相对 V4.1-Flash) |
|---|---|
| DeepSeek-V4.1-Flash | 1×(890 字节 / token) |
| DeepSeek-V4-Flash | 约 4× |
| DeepSeek-V1 | 约 437× |
架构上,40 层骨干拆成 20 层因果编码器加 20 层解码器,思路来自 YOCO:解码器不再计算自己的全局 KV,prefill 因此减半。主 KV 缓存量化到 E2M1、每 16 个通道配一个 E4M3 缩放因子,沿用 NVFP4 但不带全局缩放。
- 参数:552B 骨干 + 196B Engram,prefill 激活 8B、decode 激活 16B
- 上下文:100 万 token
- 许可与部署:MIT 开放权重,Hugging Face 上提供 vLLM、SGLang、Transformers 三条路径
- API:low / high / max 三档推理
- 评测:MarkTechPost 的 Training and Results 一节把 V4.1-Flash 与 V4-Flash、Opus 5、GPT-5.6 Sol 放在 Terminal-Bench 2.1、DeepSWE v1.1、Terminal-Bench 4.0、Automation-Bench 与 GPQA Diamond 五项上对比
局限:本条的参数、缓存与许可信息都来自这两篇报道,未见第三方复现,890 字节是 MarkTechPost 拆解给出的核心数字。Pandaily 另称新的 Flash 价格自 9 月 10 日起执行。
图片来源:huggingface;已转存至九凤 R2。
来源:MarkTechPost · Pandaily · DeepSeek on Hugging Face · YOCO 论文
02/09
MiniMax M3 在 MI355X 上把输出吞吐提到 day-0 的 3.14 倍
vLLM 公布 MiniMax M3 在 AMD Instinct MI355X 上的后续优化结果,MXFP8 并发 32 下达到 day-0 的 3.14 倍。
对照基线是 M3 的 day-0 实现,那一版已经带上 MiniMax Sparse Attention、多模态输入、推理与工具输出、MXFP8 权重和 EAGLE3。数字来自公开的 SemiAnalysis InferenceX 基准:
| 配置(MI355X) | day-0(输出 tok/s/GPU) | 优化后(输出 tok/s/GPU) | 来源给出的倍数 |
|---|---|---|---|
| MXFP8 / 并发 32 | 109.1 | 342.4 | 3.14× |
| MXFP8 / 并发 128 | 297.8 | 623.7 | 2.09× |
| MXFP4 / 并发 128 | 212.1 | 716.8 | — |
延迟同步下降:并发 32 时 TTFT 中位数从 1.46 秒降到 0.67 秒、TPOT 均值从 69.1 毫秒降到 22.1 毫秒;并发 128 时 TTFT 中位数从 3.53 秒降到 1.54 秒、TPOT 均值从 100.7 毫秒降到 48.8 毫秒。上面三行都跑在 TP4/EP1 四卡路径上;改成 TP2/EP1 后 MXFP4 进一步到 943.5 tok/s/GPU,比那个 TP4 检查点高 31.6%。工程改动之一是 vLLM #45725,把 kernel launcher 拆开,分别照顾 prefill 的大批 token 和 decode 的少量行。
局限:vLLM 自己强调,有用的结论不是某一个更高的吞吐数字,而是当瓶颈不断移动时如何决定下一步优化什么;943.5 那一档换了并行拓扑,与前面 TP4/EP1 的结果不在同一契约下,不能直接并列。
来源:vLLM Blog · vLLM #45725
03/09
OpenAI 把 250 人安全冲刺做成 Defense Factory,首日关掉 53 个高危问题
OpenAI 公开一套让智能体持续发现、验证并修复漏洞的参考架构,称首日由智能体关闭 53 个紧急或高优先级问题。
起点是一次内部「code red」:Security、Applied 与 Research 三个组联手,检查了 100 多个服务领域里的数百个系统。产出的 Defense Factory 把 AI 智能体接到源码平台、安全扫描器、issue 跟踪系统和隔离开发环境——智能体可以盘点系统、扫描代码、验证疑似漏洞是否真的可利用、把确认的发现路由给负责人、准备补丁并核对已部署的修复。蓝图在 9 月初发布,9 月 9 日 OpenAI 再次推广,称其最新的 cyber 模型找出了安全人员本可能漏掉的漏洞。落地上它配合 OpenAI 的 Codex 产品和两级受控 cyber 访问,重要变更仍由人类保留审核权。
局限:53 这个数字出自 OpenAI 自述、且只统计首日,报道未附外部核验。RuntimeWire 指出这套做法押的是「防守方用前沿模型的速度快于攻击方拿到同类工具」,而这一点尚未得到验证。
来源:RuntimeWire · OpenAI · Daybreak 访问说明
全球 AI 资讯
04/09
Anthropic 组建威胁情报运营,把抗议活动纳入安全风险
报道称 Anthropic 监控高管与设施周边的抗议、调查被认定的潜在威胁,并与执法部门交换信息。
The American Prospect 周三发表的报道,把 Anthropic 的招聘启事、它对其他媒体的表态,以及一次安全官员描述用 AI 辅助风险平台追踪某场抗议的访谈串在一起。新岗位要求做 OSINT 调查并与警方保持联系。
可以对照的是 2026 年 2 月的表态:当时 Anthropic 拒绝解除对 Claude 用于大规模国内监控和全自主武器的限制,Amodei 的理由是 AI 能把位置、浏览与社会关系记录合成前所未有规模的个人档案。
局限:报道自己指出,这个内部项目与 Amodei 当时反对的政府监控并非一回事,它是一家公司的企业安保运营;证据来自招聘启事、对其他媒体的表态和一次访谈,而不是 Anthropic 的正式披露。
来源:RuntimeWire · Anthropic 政府数据请求政策
05/09
Hugging Face 用 Gradio Workflow 重建 AUTOMATIC1111:73 个节点、11 条流水线
Workflow1111 把 stable-diffusion-webui 的大部分功能重做成一张可视化工作流画布。
Hugging Face 在官方博客里放出 Workflow1111:一张用 gr.Workflow 搭的画布,由 11 条媒体流水线、共 73 个节点组成,覆盖文生图、高分辨率修复、图生图、prompt-matrix 网格、VLM 反推、检测转 inpaint 蒙版、ControlNet 风格标注器、去背景、PNG Info 存取以及图生视频。用 Hugging Face 账号登录或提供 access token 即可运行,模型调用走使用者自己的配额;Space 也可以复制后自行改线。
局限:博客的说法是重建了 AUTOMATIC1111「大部分」功能集,但没有列出哪些没覆盖,也没有给出与原版的性能对照;运行需要登录并消耗使用者自己的额度。
来源:Hugging Face Blog · GitHub
06/09
TorchServe 停止维护,AWS 用 Ray Serve 深度学习容器接手
官方声明称 TorchServe 不再有更新、缺陷修复与安全补丁,AWS 推出 Ray Serve DLC 承接这批推理负载。
AWS 在博客中点明,TorchServe 已不再积极维护,项目官方声明称没有计划中的更新、缺陷修复、新功能或安全补丁,漏洞也可能不会被处理。对仍在 TorchServe 上跑推理的团队,这意味着安全补丁停发、与新版 PyTorch 和 CUDA 的兼容性更新也停发,工程师得自己扛整条依赖链:跨 GPU 栈挑兼容版本、逐层打补丁、在组件版本漂移时排查隐蔽故障。AWS 的答案是把训练侧 Deep Learning Containers 的思路延伸到推理端——Ray Serve DLC 是预构建、经过性能优化的 Docker 镜像,把框架、依赖和 GPU 栈打包成一套测试过、打过补丁的组合。
局限:这是一条迁移路径而不是原地兼容层,文章没有给出从 TorchServe 迁到 Ray Serve 的工作量、性能对照或版本时间表。
07/09
六家中国 AI 公司被指激进复制美国前沿模型
Ars Technica 报道称,六家中国 AI 公司被指激进复制美国前沿模型,同时美方敦促 AI 公司识别中国用户后改用能力较弱的模型。
Ars Technica 的报道给出两层内容:一是六家中国 AI 公司被指控激进复制美国前沿模型,二是美方敦促 AI 公司先识别出中国用户,再在不告知的情况下把这些用户切换到能力较弱的模型。
局限:这是单一媒体报道,被点名的六家公司、指控所依据的证据、提出该建议的机构以及可能的执行方式,报道摘要里都没有给出;在拿到原始文件之前,不宜当作已认定的事实。
来源:Ars Technica
区域与早期信号
08/09
智谱上半年 API 收入占到 86.5%,Token 调用量较年初增超 40 倍
智谱上市后首份中报显示收入重心从本地化部署切到开放平台,8 月末 ARR 达 16 亿美元。
2026 年上半年,智谱收入 9.54 亿元,同比增长 399.7%,规模已超 2025 年全年。收入结构是这份中报里变化最大的部分:
| 收入构成 | 金额(亿元) | 占总收入 | 上年同期占比 |
|---|---|---|---|
| 开放平台及 API | 8.25 | 86.5% | 15.2% |
| 本地化部署 | 1.29 | 13.5% | 84.8% |
- ARR:截至 8 月底 16 亿美元,较 7 月上旬的 10 亿美元增长 60%;8 月单月 1.33 亿美元
- 用户:MaaS 平台注册用户超 740 万,较年初增长 144%;付费日活较年初增长 603%
- 调用量:Token 调用量较年初增长超 40 倍,其中 Coding Plan 调用量增长超 23 倍
- 定价:API 平均售价提高约 101%,API 毛利率从上年同期的 -0.4% 升到 24.6%
局限:这些是公司自行披露的中报口径数字,暂无独立核验。报道同时指出,收入暴涨的另一面是亏损也在扩大,且业绩与市场预期仍有距离。该条目目前只有中文单一来源。
来源:钛媒体
09/09
Heurist 用 AgentCore payments 按查询购买付费金融数据
一个面向散户的对话式投研工作台,把按次付费的高级数据采购放进了智能体的执行链。
Heurist Finance 把几类机构式工作流收进一个对话界面:采集市场数据、读财报与新闻、跑深度研究、构建并压力测试组合、监控持仓,每个回答都会结合用户自己的持仓与偏好。系统建在 Amazon Bedrock AgentCore 上,用 AgentCore payments 按单次查询购买高级数据,再配合 Identity、Memory、Code Interpreter 与可观测性,把付费数据访问、沙箱内分析、身份与记忆串成一条可审计的回答链路。Heurist 给出的动机是:散户要用的高级市场、宏观、基本面与另类数据分散在各家付费墙和定制 API 之后,没有哪一家供应商能全覆盖。
局限:这是 AWS 发布的客户案例,文章没有给出准确率、成本或用户规模数据,也没有第三方评测;按查询付费的实际单价与数据供应商名单未披露。
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片

