概览
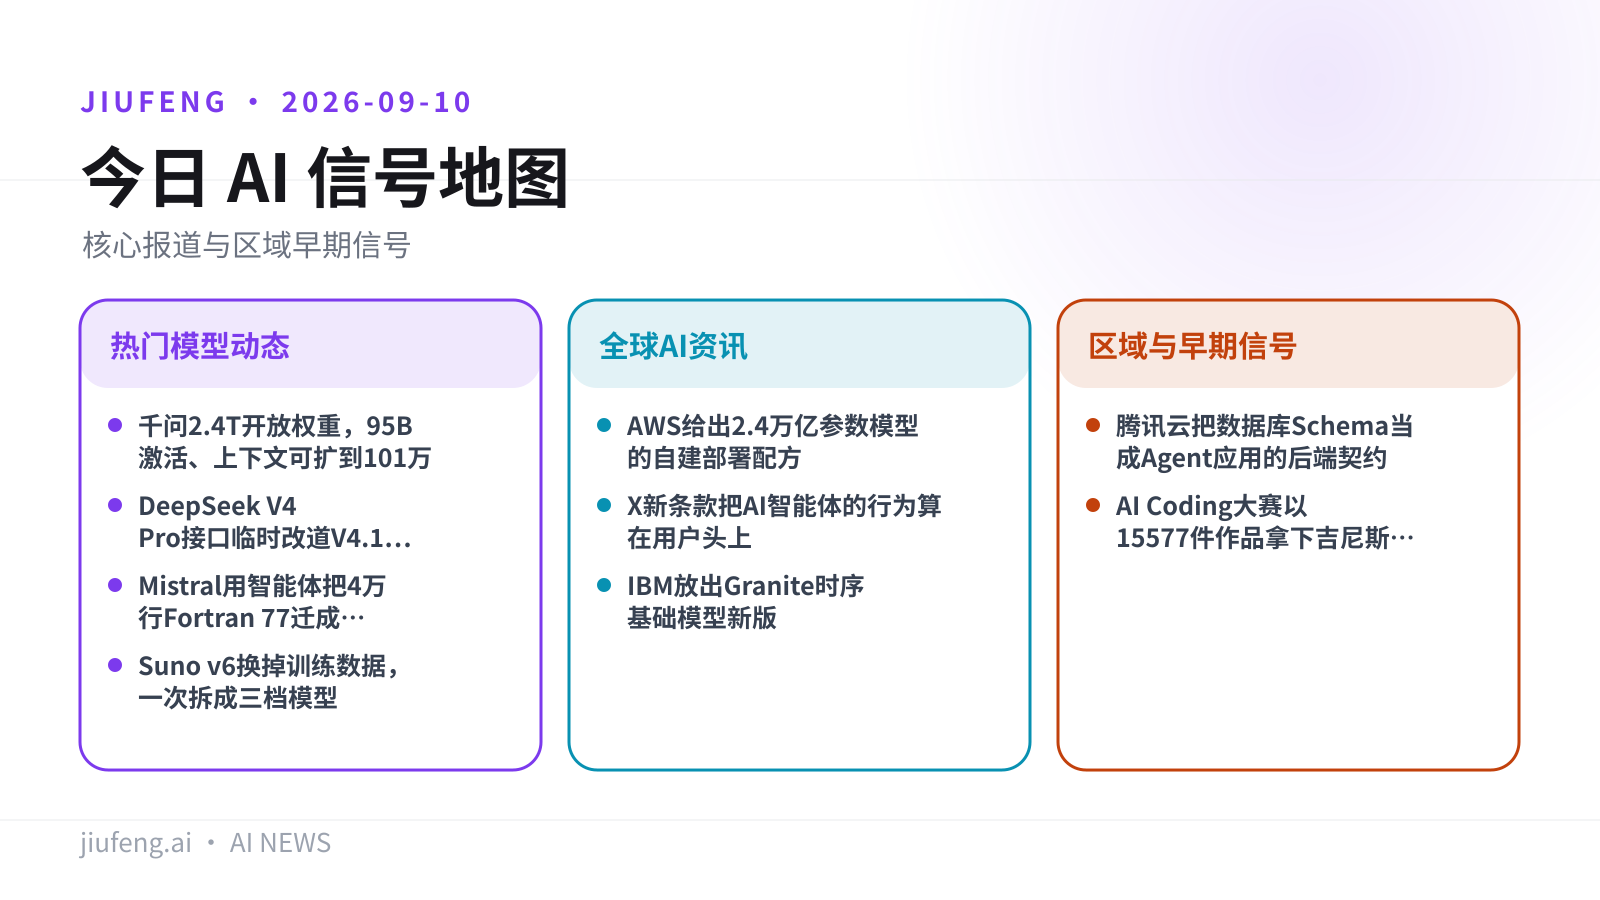
本期共 9 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · 千问 2.4T 开放权重,95B 激活、上下文可扩到 101 万
- 重点 · DeepSeek V4 Pro 接口临时改道 V4.1 Flash
- 重点 · Mistral 用智能体把 4 万行 Fortran 77 迁成 C++
- Suno v6 换掉训练数据,一次拆成三档模型
全球 AI 资讯
- AWS 给出 2.4 万亿参数模型的自建部署配方
- X 新条款把 AI 智能体的行为算在用户头上
- IBM 放出 Granite 时序基础模型新版
区域与早期信号
- 腾讯云把数据库 Schema 当成 Agent 应用的后端契约
- AI Coding 大赛以 15577 件作品拿下吉尼斯纪录
九凤根据本期已引用来源整理。
热门模型动态
01/09
千问 2.4T 开放权重,95B 激活、上下文可扩到 101 万
阿里云 Qwen 团队把一个 Max 级别的混合专家模型做成可下载权重,愿意自己运维的团队可以完全自托管。
Qwen3.8-2.4T-A95B 于 8 月 12 日发布,权重与配置文件可直接下载,而不是只能通过托管 API 调用。模型卡给出的规格如下:
- 规模:2.4 万亿总参数,推理时激活 950 亿;92 层结构,每个 MoE 块有 512 名专家,其中 10 名路由专家加 1 名共享专家参与计算
- 上下文:原生 262,144 token,可扩展到 1,010,000
- 推理栈:可发布的产物支持 Hugging Face Transformers,服务端支持 vLLM、SGLang 与 TokenSpeed
- 定位:支持可调推理深度,RuntimeWire 把它描述为 OpenAI GPT-5.5 Pro 的自托管替代品——后者是一款面向编程、研究与知识工作的高算力推理模型
局限:这些数字来自模型卡与官方材料,报道没有给出自托管所需的硬件规模、吞吐或成本;1,010,000 token 是扩展后的上限而非原生长度。阿里云同时提供 Qwen Cloud 托管入口,自建并不是唯一路径。
图片来源:GitHub;已转存至九凤 R2。
来源:RuntimeWire · Qwen 团队 GitHub · 一手来源 Gist
02/09
DeepSeek V4 Pro 接口临时改道 V4.1 Flash
在 V4.1 Pro 到位之前,所有 V4 Pro 的 API 请求都会被转到更便宜的 V4.1 Flash,等于给现有旗舰端点提前退役。
DeepSeek 计划在北京时间 9 月 10 日前后发布 V4.1 Flash,并临时把 V4 Pro 的全部 API 请求路由过去,部分 Pro 工作负载的 token 价格因此下降超过 70%。此前该公司已于 7 月 31 日把更新后的 Flash API 转入公开测试,并放出实验模型 DeepSeek-V4-Flash-Vision-Exp,权重页在 Hugging Face 可查。
Open Design 的早期测试给了一组窄口径的设计任务对比:
| 模型 | Open Design 竞技场总分(满分 100) |
|---|---|
| GPT-6 Astra | 82.7 |
| DeepSeek V4.1 Flash | 81.2 |
| GPT-5.6 Sol | 77.6 |
同一组结果里,V4.1 Flash 的需求满足度为 28.4/30,设计质量 52.8/70,交付率 57.7%,完成时长 5.3 分钟。
局限:DeepSeek 称 V4.1 Flash 在性能、推理成本、生成速度和任务完成总时长上都胜过 V4 Pro,这是公司自己的内外部测试口径,独立评测尚未覆盖编程、推理、智能体与多模态负载。Open Design 只测设计任务,样本很窄。围绕 V4 Pro 的输出、工具调用或推理行为调过的应用,即使 API 配置一个字没改,也要重新测一遍。
来源:RuntimeWire · Hugging Face 模型页
03/09
Mistral 用智能体把 4 万行 Fortran 77 迁成 C++
一家欧洲能源运营商把没有测试套件、没有集中文档的油藏模拟器交给 Mistral 的智能体做语言迁移。
这套物理计算密集的模拟器有 40,000 行 Fortran 77 代码,原作者离开后,沉在代码里的知识很难再恢复。Mistral 在复盘里给出的判断是:语法层面的翻译基本已经是解决了的问题——把非冷门语言的片段丢给任何较新的模型,迭代几轮就能收敛到可接受的结果;真正难的是把过程式代码整体迁成面向对象的 C++,这需要重建架构。
局限:这是 Mistral 自己发布的客户案例,只有一方口径,客户名称未披露,也没有第三方验证迁移结果。原系统既没有测试套件也没有集中文档,这一点是 Mistral 自己点出的难处,意味着迁移后的正确性验证本身就是这类项目最难交付的部分。
来源:Mistral AI
04/09
Suno v6 换掉训练数据,一次拆成三档模型
v6 是 Suno 第一个在唱片业配合下训练的模型,同时给出 v6、v6-wild、v6-mini 三档,mini 对所有人免费。
Suno 的 Jack Brody 对 The Verge 表示,v6 是「从头训练」的,用的是一套不包含此前模型训练数据的新数据。这批数据来自 Warner Music Group、BMG 与 Believe 授权的内容,以及「用户数据」。三档模型里,v6-mini 免费向所有人开放,主打快速、低资源占用,代价是输出更简单、更容易带上暴露 AI 出身的瑕疵。
局限:The Verge 写明,「新数据」是否彻底排除了来路存疑的内容并不清楚;同一篇报道也指出,v6 依然抓不住真人演奏的那种「自然瑕疵」。
来源:The Verge
全球 AI 资讯
05/09
AWS 给出 2.4 万亿参数模型的自建部署配方
官方博客写了怎么在 SageMaker HyperPod 上用 vLLM 跑 Qwen3.8-2.4T-A95B,从开集群一路到暴露 OpenAI 兼容端点。
这篇教程的对象正是刚放出权重的 2.4 万亿参数开放模型,步骤覆盖集群开通、NVFP4 量化,以及对外提供一个 OpenAI 兼容的推理端点——也就是把自托管的最后一段接口差异抹平。
局限:这是部署教程而不是评测,摘要里没有吞吐、时延或成本数字。教程用的是 NVFP4 量化,精度与速度的取舍需要按自己的业务基准比对量化前后的输出,集群规模与 GPU 配额也得自己准备。
来源:AWS 机器学习博客
06/09
X 新条款把 AI 智能体的行为算在用户头上
9 月 9 日发布、10 月 9 日生效的条款规定:通过自主功能产生的提示、输出、信息与操作,责任在用户。
修订后的条款给了 30 天缓冲,10 月 9 日之后继续使用即视为接受。用户要为自主功能生成的内容和执行的动作负责,包括是否符合法律与 X 的政策;X 一侧则保留宽泛的责任上限。争议解决条款同时扩展到一个已经包含 SpaceXAI、Cursor 与 SpaceX 的公司集团:集体诉讼与陪审团弃权在法律允许的范围内适用于所有用户,并覆盖这些关联公司;条款还缩短了起诉时限、限制了可获得的救济。按地区分开的只有管辖地与适用法——欧盟、EFTA 国家与英国以外的用户约定德州法律与德州法院管辖,该法院不可用时走个人仲裁;欧盟、EFTA 与英国用户适用爱尔兰法,保留当地不可放弃的保护。
局限:RuntimeWire 的观察是,这份合同里的「智能体」比产品本身出现得更早——X 已经把风险分配写清楚了,却还没说明这些自主功能到底会做什么、什么时候上线。
来源:X Privacy Center · RuntimeWire · X 服务条款
07/09
IBM 放出 Granite 时序基础模型新版
PatchTST-FM-r2 以商用友好许可发布,约 3.85 亿参数,主打零样本预测。
- 规模:约 3.85 亿参数,属 Granite TSFM 家族,是 PatchTST-FM-r1 的新版本
- 相比上代:架构更新、预训练语料更大,新增概率预测与缺失值插补
- 排名口径:IBM 称截至 2026 年 9 月 8 日,它是以商用友好许可发布的零样本模型中表现最好的一个
- 拿到哪:模型在 Hugging Face,代码仓库是 ibm-granite/granite-tsfm
时序基础模型改变的是建模方式:不再为每个数据集单独训练和维护一个模型,而是拿预训练模型直接做零样本预测。
局限:这条排名出自 IBM 自己的文章,评测口径要读者自行核对。零样本预测的效果随数据分布变化,换到自有序列上是否还成立,得在上线前跑一遍。
来源:Hugging Face 博客 · GitHub
区域与早期信号
08/09
腾讯云把数据库 Schema 当成 Agent 应用的后端契约
云开发 CloudBase for Supabase 版基于 Schema 直接映射出 REST API 与 RPC 接口,资源池化后数据库资源返回时间压到 3 秒以内。
9 月 5 日 DBTalk 数据库 AI 技术沙龙北京站上,腾讯云数据库 PostgreSQL 团队给出的判断是:AI 缩短的是代码生成时间,不是生产工程的责任清单——身份认证、权限隔离、弹性伸缩、成本控制和数据安全一个都不能少。对应的做法是把 Schema 当作应用后端的契约,平台据此映射出 REST API 和 RPC 接口,再配合 JWT、表级授权和行级安全策略,把原本散在应用层的后端能力下沉到数据库侧。
交付方式也跟着改:传统云数据库建库通常仍是分钟级,资源池化之后数据库资源返回时间可以压到 3 秒以内,计费按 CU 结算,1 核 2G 每小时记为 1 CU。针对多 Agent 协作里最容易出问题的三类情况——长期记忆不可靠、隔离边界不清晰、中间状态难以回退——团队给出的对应做法是:事实记忆入关系表、pgvector 做语义检索、Apache AGE 做关系记忆;隔离用 Cube Sandbox 做到 microVM 级;回退依托 PG 18 的 branch 能力「先分支试、再按点回」,现场给的实验数据是 3.8GB 的库克隆从 1200 余毫秒降到 56.8 毫秒。现场还引用了两组判断——Neon 认为未来 AI 驱动的数据库请求占比可达 80%,Gartner 预计到 2027 年企业级 Agent 采用率将达 33%。
局限:这些都是厂商在自家沙龙上的说法(中文来源,暂无全球英文报道),3 秒、80%、33% 和克隆耗时都没有公开压测或第三方核验;给出的解法也全部落在腾讯云自家的产品栈上。
来源:InfoQ 中文
09/09
AI Coding 大赛以 15577 件作品拿下吉尼斯纪录
外滩黑客松·AI Coding 大赛完成吉尼斯世界纪录认证,上万名参赛者里近七成未满 18 岁。
9 月 9 日,该赛事以 15,577 件应用作品拿到「线上生成式人工智能编程马拉松大赛中开发最多的应用」这一世界纪录。参赛者中近七成未满 18 岁,最小的 6 岁,最终由一名 9 岁选手夺冠。颁奖现场,11 家头部 AI Coding 平台共同发布了《AI Coding 公开挑战赛技术规范》,主办方称这是国内首份由多家平台共同制定的公开挑战赛技术规范。
局限:纪录的认证口径是「原创应用 + 达到相应 MVP 标准 + 官方审核」,衡量的是数量而不是应用复杂度、留存或后续可用性。这条目前只有中文来源,技术规范的具体条款在报道里没有展开。
来源:雷锋网
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片

