概览
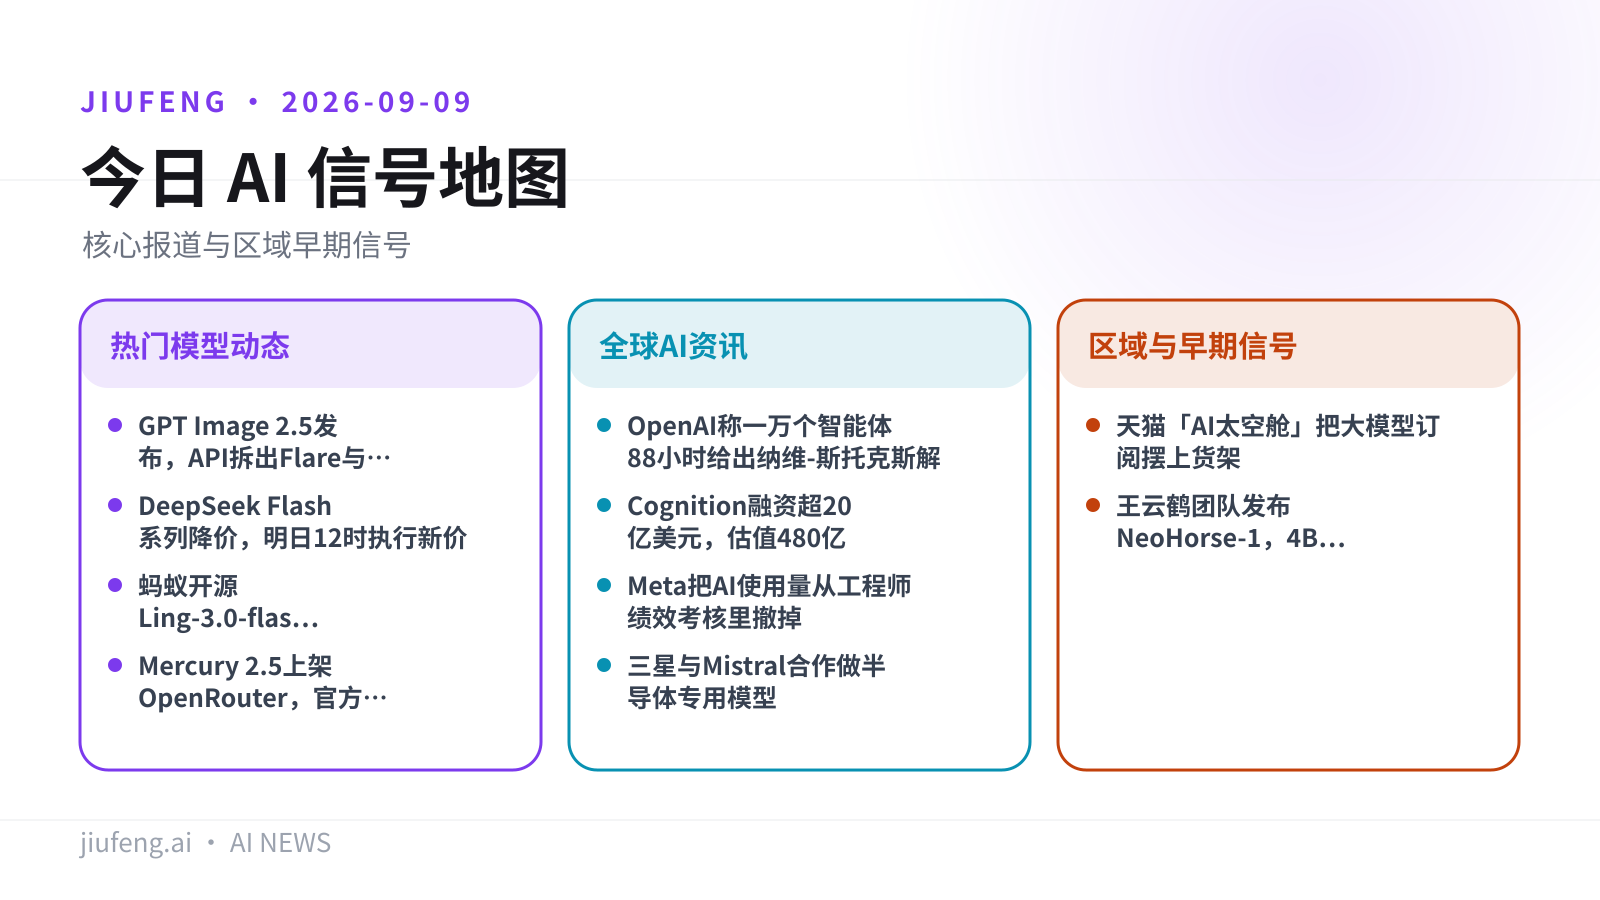
本期共 10 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · GPT Image 2.5 发布,API 拆出 Flare 与 Sunburst 两档
- 重点 · DeepSeek Flash 系列降价,明日 12 时执行新价
- 重点 · 蚂蚁开源 Ling-3.0-flash-VL:124B 总参、激活 5.5B
- Mercury 2.5 上架 OpenRouter,官方称 1107 tok/s
全球 AI 资讯
- OpenAI 称一万个智能体 88 小时给出纳维-斯托克斯解
- Cognition 融资超 20 亿美元,估值 480 亿
- Meta 把 AI 使用量从工程师绩效考核里撤掉
- 三星与 Mistral 合作做半导体专用模型
区域与早期信号
- 天猫「AI 太空舱」把大模型订阅摆上货架
- 王云鹤团队发布 NeoHorse-1,4B 与 9B 两档
九凤根据本期已引用来源整理。
热门模型动态
01/10
GPT Image 2.5 发布,API 拆出 Flare 与 Sunburst 两档
OpenAI 上线 ChatGPT Images 2.5,生成延迟相比 Images 2.0 最多降低 50%;API 同时给出 Flare 与 Sunburst 两个模型、token 单价与 GPT Image 2 持平,系统卡公布了三档的不安全生成率。
消费端先看变化。9 月 8 日起,ChatGPT Images 2.5 向 ChatGPT、ChatGPT Work 与 Codex 的全部套餐推送,覆盖桌面、移动与网页端。官方口径是光照更自然、纹理更丰富,跨多轮编辑更能保住参考照片里的人物特征——脸部特征这类识别性细节可以在同一段对话的多次生成与修改中稳定传递,生成延迟相比 Images 2.0 最多降低 50%。新功能里最显眼的是 Sketch:在输入框打 @Sketch 打开画布,用手指、触控笔或鼠标画个草图当参考,模型据此出图;此外还加了传单、产品图这类常见版式的模板,可以直接在生成图上留评论做定点修改,也能把提示词随图分享出去。OpenAI 称每周有超过 30 亿张图片产自 ChatGPT Images 与 API 上的 GPT-Image 系列。
API 这边拆成两档,官方模型页把差别写得很直白:Flare 是「最快的高质量日常图像生成模型」,社交素材、产品展示图、快速打样这类高频场景走它,SiliconANGLE 转述的官方说法是出图速度为 GPT-Image-2 的 2 到 4 倍、透明背景生成也有改善;Sunburst 是「最强的图像生成与编辑模型」,用更长的生成时间换编辑精度。
| 对照项 | Flare | Sunburst |
|---|---|---|
| 官方定位 | 日常高频出图 | 精细编辑成稿 |
| 性能 / 速度标注 | Higher / Very fast | Highest / Medium |
| 型号 ID | gpt-image-2.5-flare | gpt-image-2.5-sunburst |
| 日期快照 | -2026-09-08 | -2026-09-08 |
| 质量档 | low…auto 六档 | low…auto 六档 |
两档都能在 Image API 里直接选,也能作为 Responses API 图像生成工具的模型。
价格没动。官方模型页给两档列的是同一张表,并写明 token 单价与 GPT Image 2 一致:
| 计费项(每百万 token) | Flare / Sunburst |
|---|---|
| 文本输入 | $5.00 |
| 文本缓存输入 | $1.25 |
| 图像输入 | $8.00 |
| 图像缓存输入 | $2.00 |
| 图像输出 | $30.00 |
| 文本输出 | 不计费 |
真正会绊人的是页面上那句提醒:GPT Image 2 的 token 计算器估不准 2.5 的 token 消耗,迁移时照搬旧口径估成本会偏。能力边界也在同一页——文本只能作输入,图像可输入可输出,音频与视频不支持;流式、函数调用、结构化输出、微调与预测输出均不支持。
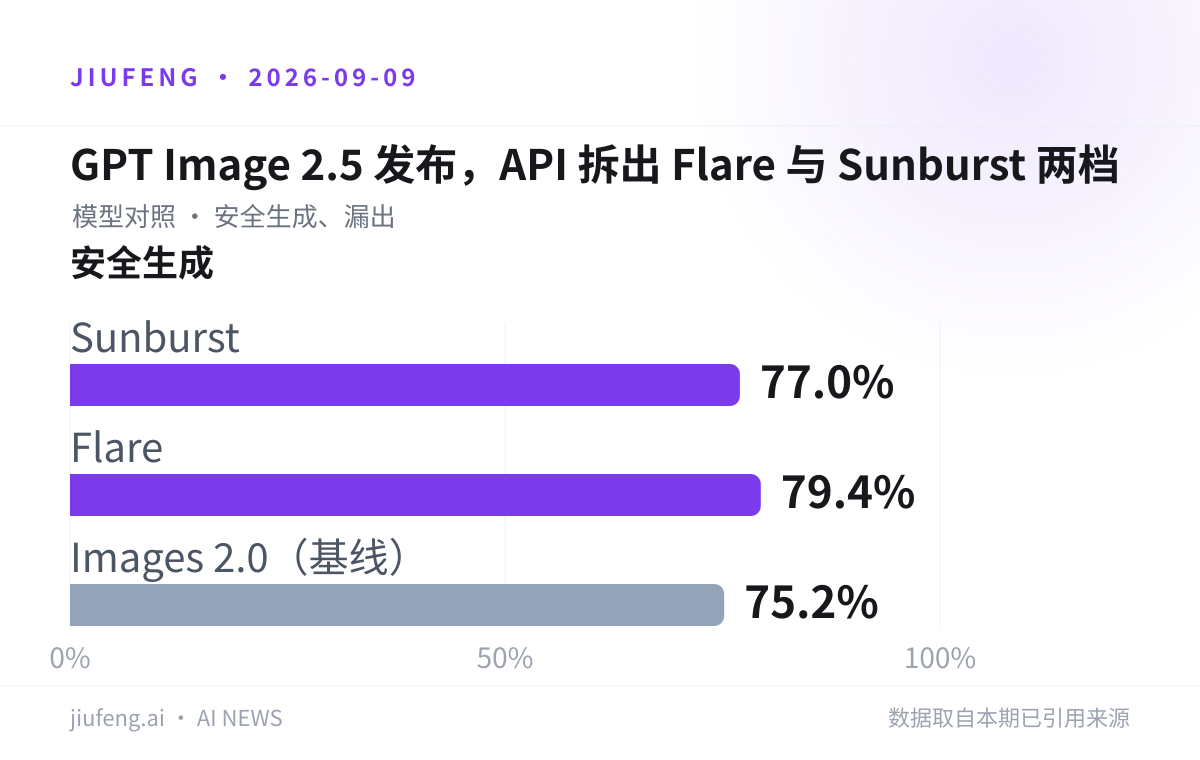
随发布公布的系统卡给了一组可比的数字。在一套专门设计的对抗性提示集上:
| 模型 | 安全生成 | 拦下 | 漏出 |
|---|---|---|---|
| Sunburst | 77.0% | 21.9% | 1.09% |
| Flare | 79.4% | 19.2% | 1.41% |
| Images 2.0(基线) | 75.2% | 23.1% | 1.64% |
分类目上,Sunburst 对性内容的拦截率为 89.1%,政治类图像的安全生成率为 90.4%,极端主义类的漏出率为 0.00%。安全栈是分层的:先由基于 LLM 的策略检查在生成前拒掉违规请求,再由一个安全推理模型审查文本与图像输入、并在展示前检查成图。溯源上继续写入 C2PA 元数据,并叠加了 Google DeepMind 的 SynthID 隐形水印。系统卡把风险也写明了:真实感提高意味着在没有防护的情况下,更容易做出以假乱真的深度伪造,包括政治、性或其他敏感题材。
第三方平台当天就跟上了:
- OpenRouter:Flare 与 Sunburst 两个模型页,标注 9 月 9 日发布、上下文 400K
- fal:
openai/gpt-image-2.5/flare与.../sunburst,文生图与图生图各一个端点 - Adobe Firefly:两档均已进入,Flare 为默认档,Sunburst 留给要求更高的成稿创作
三家的 token 单价都与官方模型页一致。
局限:系统卡自陈自动策略标注可能出错,上面那组数字只对一套固定的对抗测试集成立;两档的速度差,官方只给了 Very fast 与 Medium 这样的定性标注,没有公布逐张耗时。
九凤根据本期已引用来源整理。
来源:OpenAI · 系统卡 · Flare 模型页 · Sunburst 模型页 · The Verge · SiliconANGLE · OpenRouter · fal
02/10
DeepSeek Flash 系列降价,明日 12 时执行新价
DeepSeek 开放平台公告:9 月 10 日 12 时起,Flash 系列空闲时段输出降到每百万 token 4 元,缓存命中输入 0.02 元。
新价按时段分两档,高峰时段各项均为空闲时段的两倍:
| 每百万 token | 缓存命中输入 | 缓存未命中输入 | 输出 |
|---|---|---|---|
| 空闲时段 | 0.02 元 | 1 元 | 4 元 |
| 高峰时段 | 0.04 元 | 2 元 | 8 元 |
高峰时段划定为北京时间周一至周五 9:00-12:00 与 14:00-18:00,其余时间都算空闲。按这套划法,把批量任务挪到夜里跑,缓存命中的输入成本只有原来的一成出头。
适用范围是 Flash 系列,目前包含 deepseek-v4-flash 与实验性的 deepseek-v4-flash-vision-exp 两款模型,后者额外接受图像输入。
局限:这条以官方定价公告为准,本站未见 DeepSeek 就此发布性能或架构层面的说明。
来源:IT之家 · DeepSeek 定价文档
03/10
蚂蚁开源 Ling-3.0-flash-VL:124B 总参、激活 5.5B
百灵系列首个原生多模态模型开源,MoE 架构 124B 总参、每 token 激活 5.5B,MIT 许可。
模型卡给的参数如下:
- 结构:在 Ling-3.0-flash 的 MoE 架构上扩出原生多模态,ViT 视觉编码器配两层 MLP 投影,VideoRoPE 做空间与时间编码,42 层混合骨干里 KDA 与 Gated MLA 按 5:1 交替
- 模态与上下文:原生支持图像、文本、视频输入,上下文最高 100 万 token
- 许可与评测:MIT 许可;Artificial Analysis Intelligence Index v4.1.1 得 42 分,比底座高 4 分
它主打的机制叫视觉反馈闭环:不是一次性看图生成,而是把任务推成观察→行动→验证→修正的持续闭环,官方举的场景是医疗报告解读、前端代码生成与 GUI 自动化。
局限:两处需要留意。一是口径不一致——中文报道写的上下文是 256K,模型卡写的是最高 100 万 token,本站以模型卡为准;二是部署门槛,模型卡建议 4 到 8 张高端 GPU,且思考模式默认开启、需要按请求关闭。
来源:Hugging Face 模型卡 · IT之家
04/10
Mercury 2.5 上架 OpenRouter,官方称 1107 tok/s
Inception 的扩散语言模型 Mercury 2.5 发布并上架 OpenRouter,官方称在常见 NVIDIA GPU 上达到每秒 1107 token。
扩散语言模型不按顺序逐个吐 token,而是并行产出一批再反复精修。Inception 给出的数字是:常见 NVIDIA GPU 上每秒 1107 token,智力较 Mercury 2 提升 40%,水平与 Gemini 3.5 Flash-Lite、Claude Haiku 4.5 这类成本优化档模型相当;上下文 260K,支持可调推理强度、并行工具调用与符合 schema 的 JSON 输出。定价每百万 token 输入 $0.20、输出 $0.75,上线促销打两折,降到 $0.04 与 $0.15。渠道方面除自家 API 外,Baseten 与 OpenRouter 均可调用。
局限:速度与智力提升都出自 Inception 自己的发布材料,本站未见第三方复现或独立评测。
来源:Inception · OpenRouter
全球 AI 资讯
05/10
OpenAI 称一万个智能体 88 小时给出纳维-斯托克斯解
OpenAI 说一个未发布的内部模型带约一万个协同智能体,用 88 小时给出纳维-斯托克斯存在性与光滑性问题的解,并放出 165 页论证与 Lean 4 形式化。
OpenAI 把材料公开了:一份 165 页的分析性证明,外加可下载、可自行构建检查的 Lean 4 形式化。论文主张三维不可压缩流体可以从静止出发、在有限时间内发展出无界速度,同时动能保持有界、施加的外力保持光滑。公司称背后的模型显著强于刚发布的 GPT-6 Astra,训练仍在进行中。
局限:克莱数学研究所目前仍把纳维-斯托克斯列为未解决问题,OpenAI 也表示不打算申领对应的 100 万美元奖金。围绕这项工作还有署名争议——纽约大学数学家 Tristan Buckmaster 称,他与 Anthropic 的 Levent Alpöge 用模型做出的相关进展在公开前被对方拿去推进,并称 OpenAI 一名研究者两次要求把在 Anthropic 工作的合作者从署名中去掉;OpenAI 已就此作出回应。
来源:OpenAI · The Verge · TechCrunch
06/10
Cognition 融资超 20 亿美元,估值 480 亿
AI 编程公司 Cognition 完成超 20 亿美元 E 轮,估值 480 亿美元,运行率收入接近 9 亿美元。
对照上一轮:今年 5 月 Cognition 拿到超 10 亿美元、估值 260 亿,当时运行率收入 4.92 亿美元;四个月后估值接近翻倍,公司自报的运行率收入接近 9 亿美元。旗舰产品 Devin 从高层需求出发,自己规划任务、写代码与测试、调试并在沙箱环境里推部署,而不是逐行接指令;公司还持有 2025 年 7 月收购的 AI 编程编辑器 Windsurf。按报道,Devin 已被用在 NVIDIA 的芯片设计流程里。
局限:收入是公司自报的运行率口径,不等于已确认的年度收入。
来源:SiliconANGLE · TechCrunch
07/10
Meta 把 AI 使用量从工程师绩效考核里撤掉
内部备忘录称,AI 看板与 token 计数不再进入工程师绩效评估,改看工作的质量、速度与复杂度。
The Information 看到的这份内部备忘录署名 Maher Saba 与 Santosh Janardhan。此前 Meta 把 AI 使用列为考核项,催生出被员工称作 tokenmaxxing 的做法:为了在内部排行榜上好看,大量烧 token。代价直接落在账上——内部 AI 使用成本 2026 年正走向数十亿美元量级,Meta 计划从 2027 年起上预算与统一看板来管这件事。
局限:这条来自内部备忘录的转述,Meta 没有公开发布;同一报道还提到公司正在测试名为 Hatch 的智能体工具,部分员工出于隐私顾虑不愿把它连到个人账号。
来源:The Decoder
08/10
三星与 Mistral 合作做半导体专用模型
两家宣布战略合作,把 Mistral 的模型与服务用于三星的芯片设计、制造工艺优化与工程流程,并训练三星专属的本地部署模型。
按三星的公告,合作覆盖芯片设计、制造工艺优化与工程工作流,方式是把 Mistral 的服务与旗舰模型接进三星半导体业务,并在此基础上做定制的本地部署模型;一个被反复强调的约束是保护自有的半导体工艺信息不外流。公告发布于韩法两国在巴黎的国事峰会期间。
局限:有报道称三星在这笔合作中领投了对 Mistral 的 35 亿美元投资,这一数字目前出自媒体报道而非双方公告,需要等正式披露确认。
区域与早期信号
09/10
天猫「AI 太空舱」把大模型订阅摆上货架
天猫上线 AI 太空舱,把国产大模型的 token 与编程订阅当成零售充值来卖,智谱已开出 Coding Plan 店铺。
按报道,天猫这个入口把大模型的订阅与 token 包做成了类似话费充值的零售商品:智谱开了 Coding Plan 店铺,Kimi 与 MiniMax 处在洽谈阶段。对国产模型厂商来说,这是把开发者渠道之外的电商流量当作分发口子。
证据边界:目前公开的两篇报道都没有给出具体价格、订阅档位与上架时间表,也没有厂商对销量的说法。
10/10
王云鹤团队发布 NeoHorse-1,4B 与 9B 两档
华为诺亚方舟实验室前主任王云鹤创办的基元律动发布首个 Agent-Native 模型,基于 Qwen3.5 底座后训练。
NeoHorse-1 有 4B 与 9B 两个版本,分别在阿里开源的 Qwen3.5-4B 与 Qwen3.5-9B 上做后训练。它的特别之处在语料:核心是自家 Routing Harness(开源项目 OpenSquilla)在真实调度中产生的执行轨迹,里面保留了能力需求预测、路由选择、模型响应、工具调用与环境反馈,经完整性检查和目标完成、证据一致性、错误恢复等质量评估后进入后训练;训练方法上结合了执行监督与在策略蒸馏。技术报告在 11 项覆盖 Agent 执行、工具交互、代码与指令遵循的基准上评测,报告所列 4B 级模型中 NeoHorse 4B 的未加权平均分最高,并在其中 5 项上超过 Qwen3.5-9B 底座。
局限:报告自陈改善集中在流程清晰、反馈可观察、结果可验证的任务上;复杂状态维护、长程调试与失败恢复这些环节,更大的模型仍然占优。评测与结论都出自厂商自己的技术报告。
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片

