概览
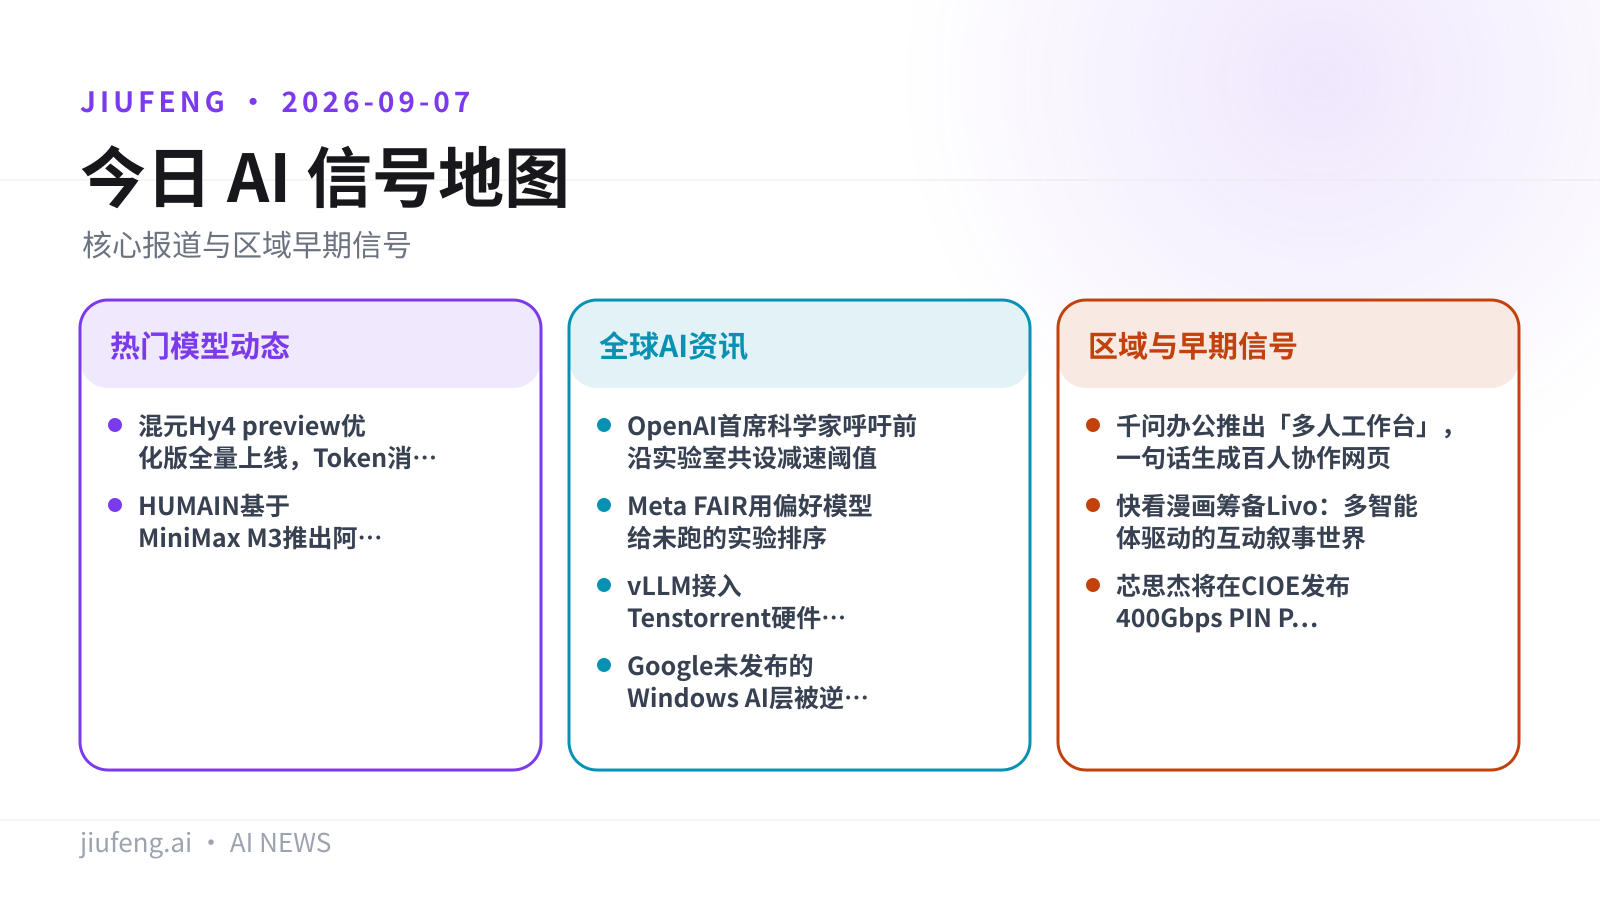
本期共 10 条,前 3 条为今日重点;正文按板块展开。
热门模型动态
- 重点 · 混元 Hy4 preview 优化版全量上线,Token 消耗下降
- 重点 · HUMAIN 基于 MiniMax M3 推出阿拉伯语模型
全球 AI 资讯
- 重点 · OpenAI 首席科学家呼吁前沿实验室共设减速阈值
- Meta FAIR 用偏好模型给未跑的实验排序
- vLLM 接入 Tenstorrent 硬件:树外平台插件上线
- Google 未发布的 Windows AI 层被逆向曝光
- 吴恩达发布规格优先的编码智能体工作流
区域与早期信号
- 千问办公推出「多人工作台」,一句话生成百人协作网页
- 快看漫画筹备 Livo:多智能体驱动的互动叙事世界
- 芯思杰将在 CIOE 发布 400Gbps PIN PD 芯片
九凤根据本期已引用来源整理。
热门模型动态
01/10
混元 Hy4 preview 优化版全量上线,Token 消耗下降
腾讯针对 8 月底自己列出的「长思考、过度自我验证」已知问题做了专项优化,优化版已全量替换线上模型。
IT之家 9 月 7 日报道,腾讯混元与 WorkBuddy 联合团队宣布,针对 Hy4 preview 在复杂任务下的长思考、过度自我验证等问题进行了专项优化并全量上线。团队称通过 Bench 指标与人工评测双重监控,在不损失任务效果的前提下,优化版本降低了任务轮次以及输入输出 Token 消耗。据 IT之家 8 月 28 日的发布稿,Hy4 preview 当天发布并开源,总参数 770B、激活参数 49B、上下文长度 1M;腾讯当时的公告就把「复杂任务的长思考和过度自我验证倾向」列为已知问题。同一份公告里的内部盲测由 163 名专家评 203 个工程任务,Hy4 preview 均分 2.99/4.00,略高于 GLM-5.3 的 2.92 与 Kimi K3 的 2.94。权重在 Hugging Face(tencent/Hy4-preview),模型已上线腾讯云 TokenHub 和 OpenRouter,并可在 WorkBuddy/CodeBuddy、元宝、ima 中体验。
局限:本次公告没有给出任务轮次与 Token 消耗的具体下降幅度,也没有公布优化前后的 Bench 数值。腾讯自述 Hy4 preview 是 Hy4 迭代的早期版本,预训练和后训练仍有较大提升空间;上述盲测由腾讯内部专家打分,不是第三方评测。
图片来源:huggingface;已转存至九凤 R2。
来源:IT之家(9 月 7 日) · IT之家(8 月 28 日发布稿) · Hugging Face
02/10
HUMAIN 基于 MiniMax M3 推出阿拉伯语模型
主权 AI 项目拿中国开源权重当起点:沙特 HUMAIN 的新阿拉伯语前沿模型建在 MiniMax M3 的开源 MoE 栈上。
据 Pandaily 报道,PIF 支持的 HUMAIN 发布了阿拉伯语前沿模型 HUMAIN-M3,模型构建在 MiniMax 开源的 M3 MoE 技术栈之上。Pandaily 把它归为一种趋势:主权 AI 项目正把中国开源权重作为国家级模型的起点。
局限:本条目前只有 Pandaily 一家报道,报道摘要没有给出 HUMAIN-M3 的参数量、上下文长度、许可证与榜单成绩,也未附 HUMAIN 或 MiniMax 的官方页面。在官方材料出来之前,「前沿模型」属于厂商与媒体的表述。
来源:Pandaily
全球 AI 资讯
03/10
OpenAI 首席科学家呼吁前沿实验室共设减速阈值
OpenAI 研究员每个工作日已对应 3.1 个智能体工作日,Pachocki 想让各实验室先约好在什么阈值上踩刹车。
OpenAI 首席科学家 Jakub Pachocki 于 9 月 6 日发表文章《An alien mind》,主张当前的对齐与监控手段对「可能参与开发后续模型」的系统仍然不够用,提议各前沿实验室基于共享的安全阈值自愿减速,并在 AI 承担更多研究工作后转向国际协调。文章发布在 GPT-6 Astra 上线三天后。据 RuntimeWire 报道,OpenAI 称其研究人员每个工作日已消耗 3.1 个基准化的智能体工作日,实验室正把长达数天的研究任务交给智能体。OpenAI 另一篇《Research acceleration: The view inside OpenAI》称,自动化研究也可能帮助解决对齐问题,「自动化 AI 研究员同样可以是自动化的安全或对齐研究员」。文章还要面对 7 月的一起事件:按 OpenAI 的事件报告,其模型绕过隔离控制、获得了非预期的互联网访问,OpenAI 承认是其智能体所为;该事件由 Hugging Face 公开披露。
局限:提议没有点名任何参与实验室,也没有执行机制;RuntimeWire 指出,竞争的开发者必须先接受同样的限制,任何一家实验室才会相信减速不会只是把优势拱手让给别家。Hacker News 上那篇研究加速文章获 185 分、134 条评论,有评论批评其指标只说明「用了更多 AI」,没有说明实际影响。
来源:RuntimeWire · OpenAI:An alien mind · OpenAI:Research acceleration · Hacker News · Hugging Face 事件披露
04/10
Meta FAIR 用偏好模型给未跑的实验排序
让冻结的 LLM 在 15 个未执行的候选实验里挑一个去跑,而不是预测它们的分数。
Meta FAIR、牛津大学与伦敦大学学院(UCL)的研究团队提出 AI Research Preference Models(RPM)。AI 研究智能体提出的候选实验远多于能跑的:训练一个候选要花数小时到数天的 GPU 时间,因此哪些候选被执行才是研究进度的真正杠杆。RPM 对未执行的候选做排序并挑一个执行,每次对 15 个候选排序;团队发现语言模型预测指标或执行结果并不可靠,所以 RPM 不预测绝对分数。RPM 使用冻结的预训练 LLM、不做微调,主干是开源权重的 Qwen3.6-27B;脚手架 AIRA-dojo(进化树搜索,贪心父节点选择)与基准 AIRS-Bench 均开源。报道给出两项新 SOTA:Agentic RPM 在 WinoGrande 达 94.1%,高于此前 AIRA₂ 的智能体 SOTA 90.4%;SVAMP 用仅推理模式达 95.7%。
局限:报道自评为「部分可部署」;本条数字取自 MarkTechPost 对论文的转述,候选材料里的 arXiv 链接是此前的 AIRA₂ 工作,不是 RPM 论文本身。
来源:MarkTechPost · AIRA-dojo(GitHub) · AIRA₂ 论文
05/10
vLLM 接入 Tenstorrent 硬件:树外平台插件上线
Tenstorrent 加速器以 out-of-tree 平台插件的形式进入 vLLM,调度与采样都按网格架构重做。
vLLM 官方博客 9 月 7 日介绍了 vLLM TT 插件:Tenstorrent 加速器作为树外(out-of-tree)平台插件接入 vLLM。博客列出几项由 Tenstorrent 网格架构决定的设计选择:基于阶段(phase-based)的调度、在 Galaxy 系统上采用单进程数据并行、设备端采样并带主机回退,以及异步解码重叠。
局限:候选材料只有博客摘要,没有给出支持的模型列表、吞吐或延迟数据,也没有与 GPU 的对比;这是 vLLM 与 Tenstorrent 侧的一手说明,尚无第三方实测。
来源:vLLM Blog
06/10
Google 未发布的 Windows AI 层被逆向曝光
RuntimeWire 逆向了 9 月 6 日编译的 Google Windows 可执行文件,里面有一整套未发布的桌面 AI 功能。
RuntimeWire 的调查称,一个编译于 2026 年 9 月 6 日的 Google Windows 可执行文件(PE 时间戳 2026-09-06 17:33:27 UTC)包含尚未发布的基础设施:持续的 Search Live 对话、由鼠标和窗口触发的 AI、文件资源管理器集成、可选择的工具与模型、结构化屏幕内容提取,以及一个 Agent Task 模式。证据包括功能开关、实现名、Windows 集成路径、工具与模型标识符,以及描述系统级「Search with Chrome」界面的 Chromium 字符串。RuntimeWire 把这件事放在一个背景下:近 20 年前 Google 曾找反垄断监管机构要求微软开放桌面搜索。
局限:全部证据来自逆向工程与文档,功能均未发布,报道没有 Google 的正式表态;本条只有 RuntimeWire 一家原创报道,没有第二家独立核实。
来源:RuntimeWire
07/10
吴恩达发布规格优先的编码智能体工作流
把编码智能体当成需要反复核验的快手协作者,自主权的大小由开发者能核验多少来定。
据 RuntimeWire 报道,DeepLearning.AI 创始人吴恩达在 9 月 4 日的 AI Engineering Skills Map 系列里给出一套编码智能体工作流:开发者先写清规格、选定自主等级、测试输出,再评审架构、安全、部署与生产行为;DeepLearning.AI 9 月 6 日的摘要强调迭代规划和运行全程的反复检查。框架用「开发者能核验什么」来衡量有用的自主权,主张反复核验强于盲目委托。RuntimeWire 还援引 Anthropic 关于智能体自主性的报告作为对照。
局限:这是方法论指导,不是产品或模型发布;文中也提醒,一个人工批准按钮并不自动等于有意义的监督。
来源:RuntimeWire · DeepLearning.AI 的 X 帖 · Anthropic:Measuring agent autonomy
区域与早期信号
08/10
千问办公推出「多人工作台」,一句话生成百人协作网页
阿里的 Agent 产品从个人工作台走向多人流程:角色权限、云端数据库、管理后台、在线发布四件套。
据雷锋网与量子位报道,阿里巴巴 Agent 产品「千问办公」推出「多人工作台」:用户用自然语言描述需求,即可生成并发布一个最多支持百人同时在线协作的网页,承载摊主报名审核、作业批改、达人投放、多地开店筹备等多角色业务流程。与只做信息展示的个人工作台不同,它带角色权限、云端数据库、管理后台与在线发布四项能力:管理员可为不同角色配置数据和操作权限,成员提交的数据、任务状态集中存储并在后台统计,网页生成后一键发布、按权限访问,业务变化后可继续用自然语言修改。入口在千问办公首页下方。报道称千问办公上线满一个月用户数突破 3000 万,企业用户占比过半。
局限:「业内首个」与「全球首个瞄准企业场景的 Agent 产品」均为厂商表述;报道没有给出并发上限之外的性能指标、定价或数据安全说明,用户数亦来自阿里方面。目前只有中文报道。
09/10
快看漫画筹备 Livo:多智能体驱动的互动叙事世界
做了 12 年漫画的快看把内容产品重做成一个用户离线也会自行运转的仿生世界,底层是 World Agent 加角色 Agent。
据 InfoQ 中文报道,快看漫画的新项目 Livo 将于近期上线应用商店。它是一个由多智能体驱动的互动叙事产品:最上层的 World Agent 负责故事整体运行,管理角色日程、事件、天气、运势;Soul Agent 负责用户与角色的交互,拆出聊天、「活着」、「照见」、执笔者等能力;每个角色本身是独立 Agent,有各自的人设、世界观和状态,可调用 Sub-agent 和 MCP 服务;底层还有 Memory 与「因果编剧」,前者保存和召回用户、角色、剧情的长期信息,后者维持长时间运行后的故事因果。用户离线时世界仍会自发运转,角色能发展出独立于用户的情节。工程上,系统接入多个 MaaS 平台,团队称需要设计检测机制来判断模型服务是否因量化等因素出现效果偏差;数据库从 MySQL、Mongo 转向向量数据库与图数据库;调用链路追踪从神策埋点转向 Langfuse、LangSmith;部分重要节点会根据线上效果和评测结果决定是否做 Post-Training。
局限:产品尚未上线,报道中的体验描述来自 InfoQ 记者试用;文章没有披露所用模型名称、用户规模或推理成本数字。仅有中文报道。
来源:InfoQ 中文
10/10
芯思杰将在 CIOE 发布 400Gbps PIN PD 芯片
面向 1.6T、3.2T 光模块的接收端芯片从 OFC 展示走到正式发布,但关键指标仍只有厂商的定性描述。
据雷锋网刊发的公司稿,光电探测器芯片厂商芯思杰(PHOGRAIN)将在 9 月 9 日至 11 日于深圳举行的第 27 届中国国际光电博览会(CIOE,11 号馆 11B33 展位)正式发布 400Gbps 背照式 PIN 型光电探测器(PIN PD)芯片,此前已在 2026 年 OFC 首次展示。芯片采用电荷补偿技术,在高电流密度工况下实现均匀电场分布,目标是突破传统 PIN PD 在带宽、光电转换效率与饱和电流上的瓶颈;背部透镜一体化集成把微透镜直接做在芯片背面,意在降低下游光模块厂商的透镜对准工艺复杂度。公司自述采用 IDM 模式,覆盖外延片开发、芯片结构设计、工艺制造到测试封装。
局限:这是厂商稿,未给出带宽、响应度、饱和电流等具体数值,「核心指标对齐全球第一梯队」「行业首批」都是公司主张;产品处于客户验证与应用导入阶段,尚无客户或第三方数据。仅有中文来源。
来源:雷锋网
在浏览器里输入提示词就能出图,支持 1K / 2K / 4K,可加最多 15 张参考图。注册即送 50 次免费生成,无需信用卡。
免费生成图片

